
無料のローカルSEOクローラー

SpiderHeadは、開始URLから手元のマシンでサイトをクロールし、同一ホストのリンクをたどり、robots.txtに従います。結果は、Screaming Frogのエクスポートと同じチェックで監査します。

できること

プロジェクトなしでクロール

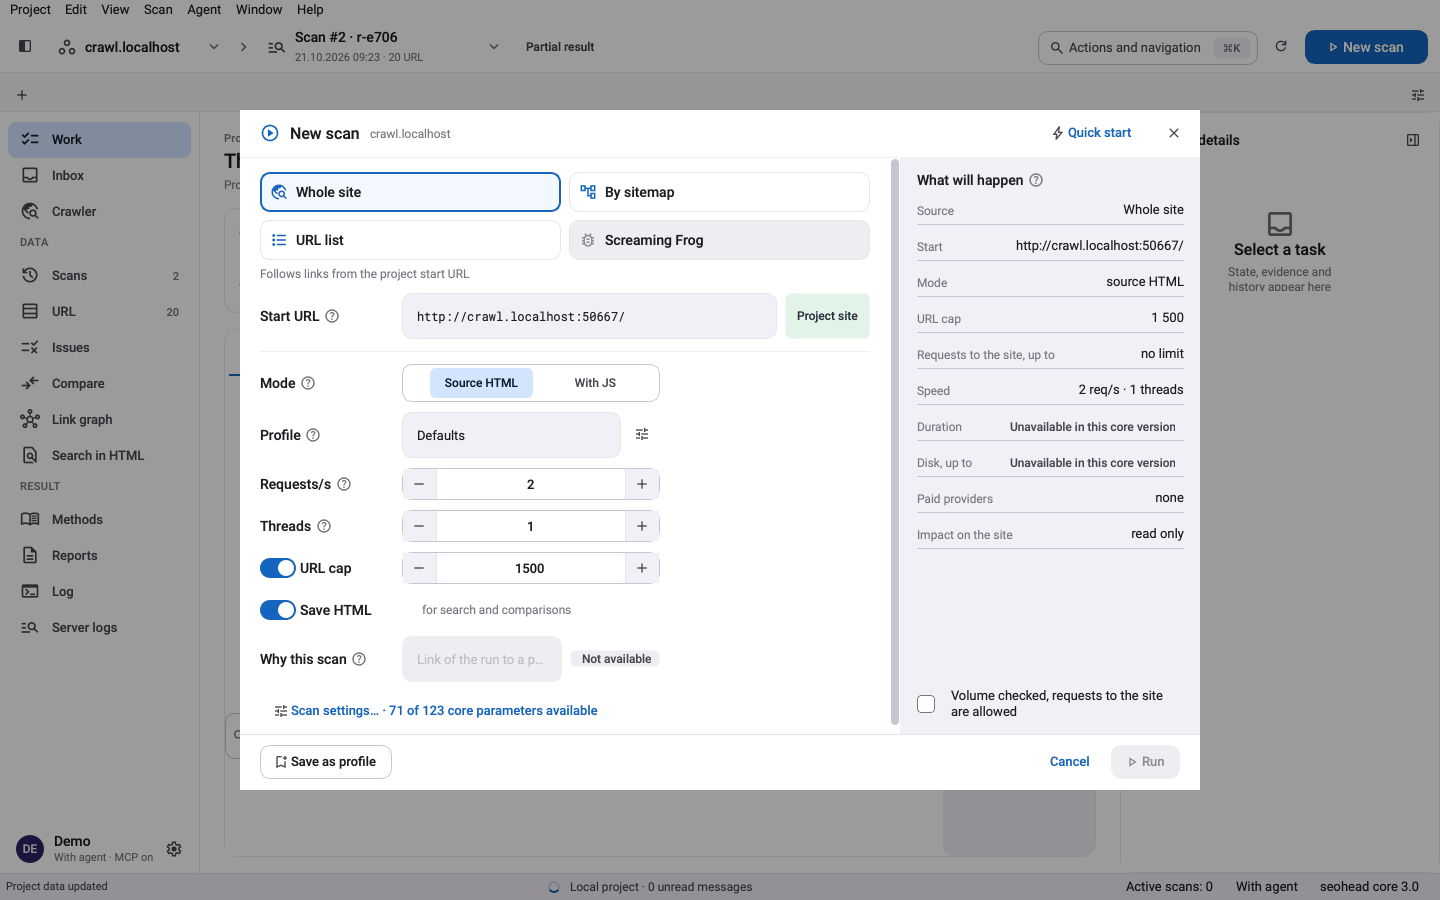
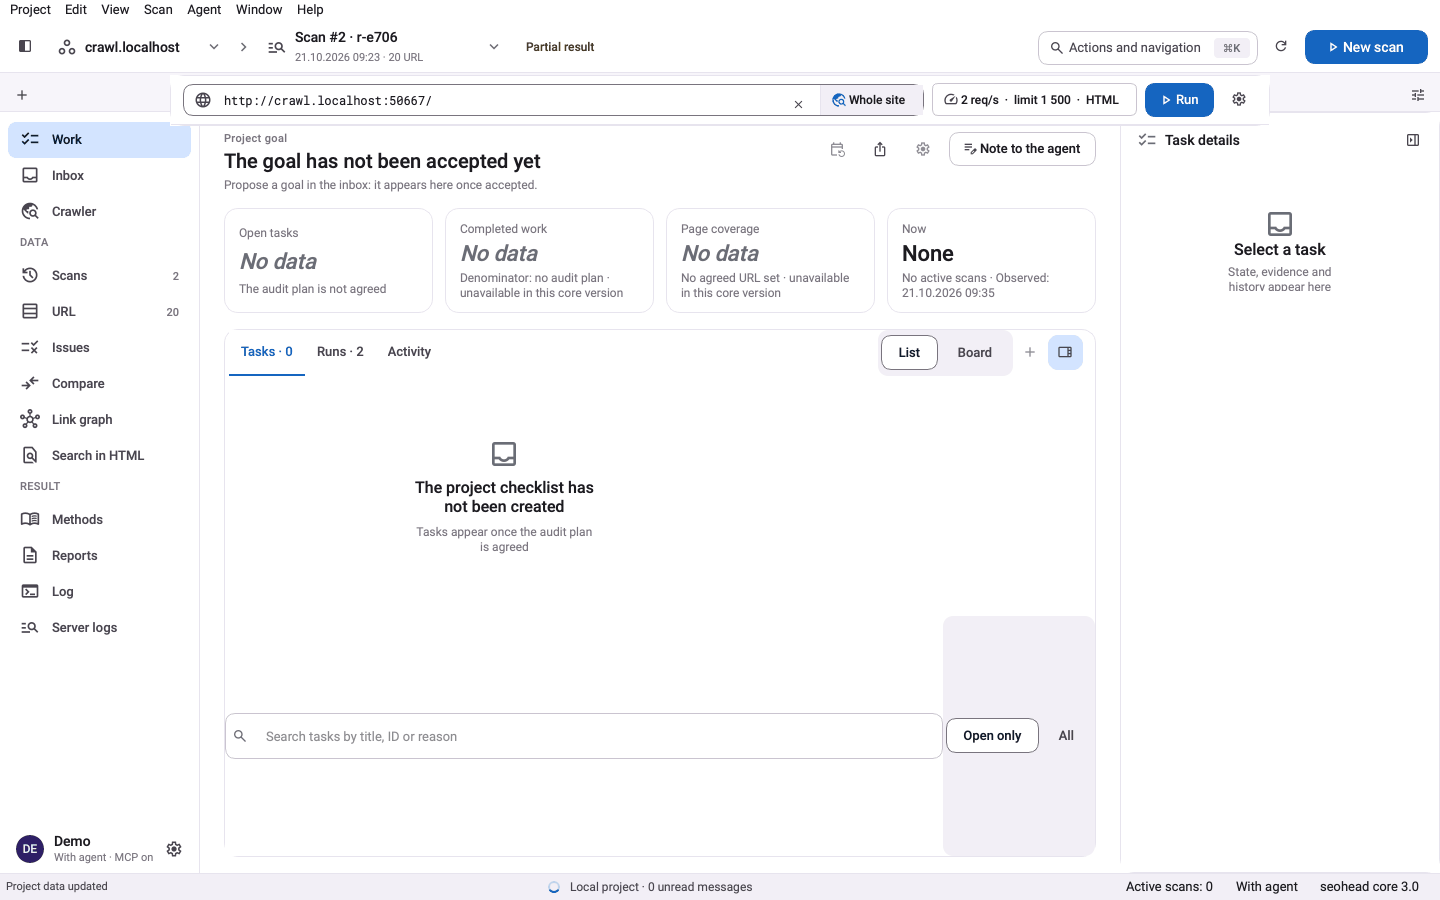
デスクトップアプリでは、URLを入力してStartを押すだけです。結果は、あとからプロジェクトとして保存できます。ターミナルでは、crawl-siteが開始URLからリンクをたどり、ネイティブのSQLiteスキャンを1つ書き出します。スキャンは、オフラインで開き直し、エクスポートし、再分析できます。同じクロールを、ローカルのMCPサーバー経由でseo_crawl_siteとしてAIエージェントからも使えます。

  • 既定は同一ホストのみ。サブドメインを含めるのは、オプトインの設定(scope.internal)です
  • robots.txtは既定で守ります
  • 無料でローカル動作:ホスト型アカウントもScreaming Frogのライセンスも不要です

実行できないチェックは、そう表示する

ネイティブのクロールは、すべての種類の証拠データを集めるわけではありません。クロールで集めていないデータが必要なチェックは、誤って問題なしとはせず、理由付きでスキップとして返します。各チェックの結果は、検出あり、検出なしで実行済み、スキップ、失敗のいずれかです。

  • チェックごとに4種類の結果があるため、抜けが隠れることはありません
  • 完全なクロールが必要なリンク関連のチェックは、途中までのクロールでは保留されます

3ステップで、スキャンを1件保存

  1. 1つのURLから始める

    デスクトップアプリで開始URLを入力するか、ターミナルでcrawl-siteを実行します。同一ホストのリンクをたどり、開き直せるネイティブのSQLiteスキャンを1つ書き出します。

  2. 既定でサイトに配慮する

    ホストあたり毎秒約2リクエストで、遅延は状況に応じて調整されます。URLの上限は自分で設定でき、既定は200 URLです。

  3. 同じ証拠データを監査する

    クロール結果は、インポートしたエクスポートと同じ182項目のチェックレジストリで確認します。ネイティブのクロールでは集められないデータが必要なチェックは、問題なしではなく、理由付きでスキップと表示されます。

この機能のチェック項目

チェック項目意味重要度根拠
BROKEN_PAGE_4XXクロールしたページが4xxのレスポンスを返すCriticalURLとレスポンスのステータス
SERVER_ERROR_5XXクロールしたページが5xxのレスポンスを返すCriticalURLとレスポンスのステータス
NO_RESPONSE応答がない:タイムアウト、DNS、または接続の失敗CriticalURLと失敗の理由
BROKEN_INTERNAL_LINK内部リンクが4xxのURLを指しているCriticalリンク元ページとリンク位置
REDIRECT_LOOPリダイレクトチェーンが、すでに通ったURLに戻るCriticalループの経路
REDIRECT_CHAIN最終URLに着くまでに2ホップ以上のリダイレクトがあるImportant各ホップとそのステータス
BLOCKED_BY_ROBOTSrobots.txtがURLをブロックしているため、クロールで取得しなかったImportantURLと、一致したrobots.txtのルール

コマンド1つで実行

bash
seohead crawl-site --url https://example.com --max-urls 500 --scan-out ./scans/audit.sqlite

先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。

必要なもの

  • 開始URL(または--urlsか--urls-fileで指定するURLのリスト)
  • スキャンファイルのパス(--scan-out)、またはプロジェクトフォルダ
  • 任意:クローラーの設定ファイル(JSON)。crawl-site --config-helpですべての設定を一覧できます

制限事項

  • コアのクロールが読むのは静的なHTMLで、JavaScriptのレンダリングは任意の追加機能です
  • 既定では200 URLで止まります。--max-urlsは意図して引き上げてください(上限は1,000,000)
  • Screaming Frogの完全な代替ではありません。一部のチェックはスキップされます
  • スコープを広げない限り、たどるのは1つのホストのリンクだけです

よくある質問

Screaming Frogのライセンスは必要ですか?
いいえ。ネイティブのクロールはローカルで動作し、ホスト型アカウントもScreaming Frogのライセンスも不要です。すでにScreaming Frogのエクスポートがあれば、それをインポートして使うこともできます。
Screaming Frogの完全な代替になりますか?
いいえ。同等であるとも主張していません。ネイティブのクロールで集めていない証拠データが必要なチェックはスキップとして報告され、summary.check_coverageでレジストリのどこまでが実行されたかを確認できます。
robots.txtに従いますか?
はい、既定で従います。robots.txtをまったく取得できない場合、クロールはアクセスできるものと見なさず、停止します(robots.unavailable_means_stop、既定でオン)。それでもクロールするには--robots report_onlyを指定します。ブロックされるはずのURLは一覧で報告されます。
何URLまでクロールしますか?
既定の上限は200 URLです。--max-urlsは1,000,000まで設定できます。0にするとURLの上限がなくなりますが、ほかのリソースの制限は引き続き適用されます。プロジェクトの予算を超えるクロールには、--approve-large-crawlが必要です。
JavaScriptのページもレンダリングできますか?
既定のクロールではできません。レンダリングは任意の機能です。renderの追加パッケージとPlaywrightのブラウザーをインストールし、クロールの設定でrendering.modeをjsにします。コアのクロールは、ブラウザーなしで動作します。