
SEO修正の確認

リリース後に、選んだ検出結果やURLを再チェックします。影響を受けるページだけを対象に、各検出結果を「解消」「継続」「変化」「確認不能」のいずれかに分類します。

できること

対象を絞った再チェック

確認する対象は、検出結果のID、影響を受けるURL、URLファイル、保存済みの確認ビューのいずれかで選びます。SpiderHeadは、そのページだけを、ベースラインに記録されたHTTP、robots、レンダリングのポリシーで取得し直します。サイト全体を対象とするチェックは再実行しません。

  • 1回の選択に含められるのは、クロール対象500件、検出結果5,000件までです。
  • 上限を超える選択は失敗し、サンプリングはしません。
  • --afterで既存の後の監査またはスキャンを使う場合、リクエストは送りません。

範囲を限った判定

一部だけの再チェックで、サイト全体が修正済みと断定することはできません。サイト全体を対象とするチェックや未計測のチェックは、確認不能として返ります。無効な後のクロールでは検出結果を解消扱いにできず、同じスキャンの再分析も新しい証拠にはなりません。

  • すべての判定に、理由と証拠を付けます。
  • 結果は、変更不可のJSONとMarkdownの新しいファイルとして書き出します。
  • 取得できなかったページは、確認不能のままです。

修正台帳

長期にわたる作業には、プロジェクトに紐づく修正台帳(remediation ledger)が、案件ごとにライフサイクルの状態を追跡します。タスクは再チェックの証拠に基づいて進むため、完了にしたタスクが修正済みのサイトと取り違えられることはありません。再チェックは、保留中の案件だけに限定されます。

  • remediation-ingestは、保存済みの監査をベースラインとして読み込みます。
  • remediation-recheckは、サイトをクロールせずに保留中の案件を確認します。
  • remediation-reportは、修正前後の証拠をオフラインで表示します。

3ステップで、スキャンを1件保存

  1. ベースラインから始める

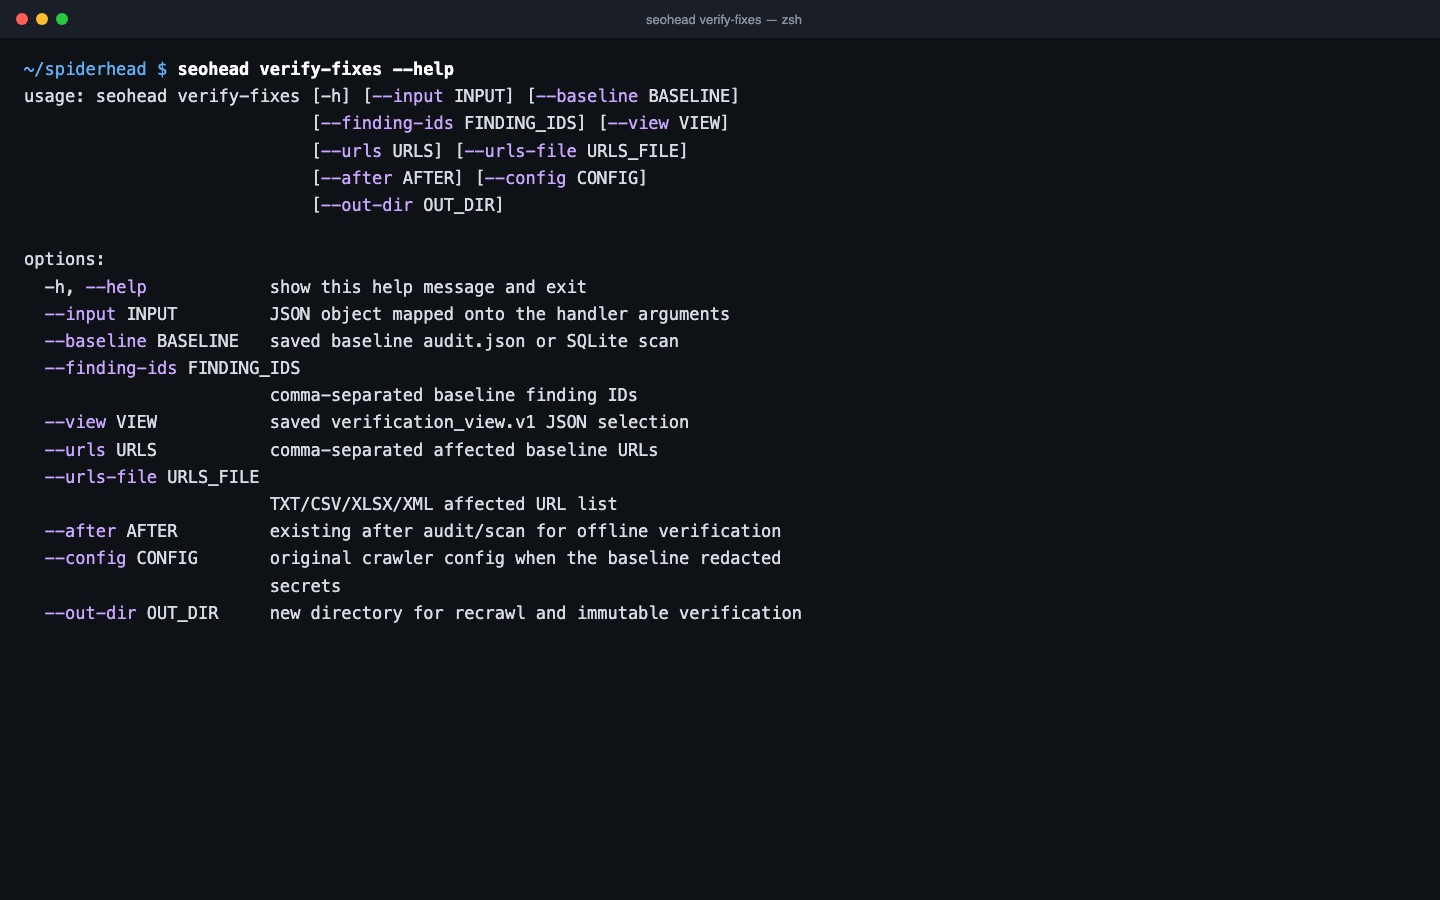
    手元のaudit.jsonまたはSQLiteスキャンをverify-fixesに指定し、検出結果のIDか影響を受けるURLを選びます。

  2. 影響を受けたページだけを再チェックする

    選んだURLを、ベースラインに記録されたHTTP、robots、レンダリングのポリシーで取得し直します。サイト全体を対象とするチェックは再実行しません。

  3. 検出結果ごとの判定を読む

    各検出結果は、解消、継続、変化、確認不能のいずれかになり、理由と証拠が新しい変更不可のJSONまたはMarkdownファイルに残ります。

この機能のチェック項目

チェック項目意味重要度根拠
BROKEN_PAGE_4XXページが4xxのステータスを返す。再チェックでURLが2xxを返せば、修正済みと確認できるCriticalURLごとの、修正前後のステータスコード
SERVER_ERROR_5XXページが5xxのステータスを返す。再チェックで2xxが返ったときだけ解消とするCriticalURLごとの、修正前後のステータスコード
TITLE_MISSINGページにtitle要素がない。修正すると、同じURLで解消と表示されるCriticalそのURLの、ベースラインと再チェックの検出結果の行
H1_MISSINGページにH1の見出しがないImportantそのURLの、ベースラインと再チェックの検出結果の行
CANONICAL_MISSINGページにcanonicalのlink要素がないImportantそのURLの、ベースラインと再チェックの検出結果の行
REDIRECT_CHAIN最終URLに着くまでに、2回以上のリダイレクトを経由するImportant再チェックで得た、各ホップのステータス
BAD_REDIRECT_TYPE恒久的な301が適切な場面で、302、303、307を使っているTip再チェックで得た、各ホップのステータス

コマンド1つで実行

bash
seohead verify-fixes --baseline ./report/audit.json --urls https://example.com/old-page --out-dir ./verification-1

先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。

必要なもの

  • ベースライン:保存済みのaudit.jsonまたはSQLiteスキャン
  • 対象の選択:検出結果のID、URL、URLファイル、または保存済みのビュー
  • 確認結果のファイルを出力する新しいフォルダ(--out-dir)
  • 任意:ベースラインで認証情報が伏せられている場合は、元のクローラー設定(--config)

制限事項

  • --afterを指定しない場合、選んだURLに読み取りリクエストを送ります。
  • 確認するのは選んだページだけです。サイトの再スキャンはしません。
  • --afterで使う後のスキャンは、ベースラインとは別のもので、ベースラインより後に観測したものでなければなりません。
  • サイト全体を対象とするチェックは、一部だけの再チェックでは確認できません。

よくある質問

サイトに変更を加えますか?
いいえ。選んだURLに読み取りリクエストを送るだけです。出力は、--out-dirで指定したフォルダに作られる新しい確認ファイルです。
解消と判定されたら、サイト全体が修正済みということですか?
いいえ。確認するのは、選んだ影響ページだけです。サイト全体を対象とするチェックや未計測のチェックは、一部だけの再チェックでは修正済みにならず、確認不能として返ります。
先にもう一度クロールする必要はありますか?
必要なのはベースラインです。保存済みのaudit.jsonまたはSQLiteスキャンを用意してください。ネットワークリクエストなしで確認するには、既存の後の監査を--afterに渡します。オフラインで動作します。
1回の実行でいくつの検出結果を確認できますか?
クロール対象は500件、検出結果は5,000件までです。これを超える選択はサンプリングされずに失敗するので、分けて実行してください。
compare-crawlsとの違いは?
compare-crawlsは、保存済みの2つのファイルを比較するだけで、何も取得しません。verify-fixesは、選んだページを取得し直し、検出結果ごとに判定を返します。リリース全体の概要にはcompare-crawls、特定のタスクを完了させるにはverify-fixesを使います。
AIアシスタントから使えますか?
はい。同じ処理をローカルのMCPサーバーでseo_verify_fixesとして利用できます。引数はCLIと同じです。