
Rastreador SEO local y gratuito

SpiderHead rastrea un sitio desde una URL de inicio en tu propia máquina, sigue los enlaces del mismo host, respeta robots.txt y audita el resultado con las mismas comprobaciones que usa para las exportaciones de Screaming Frog.

Qué hace

Rastrear sin proyecto

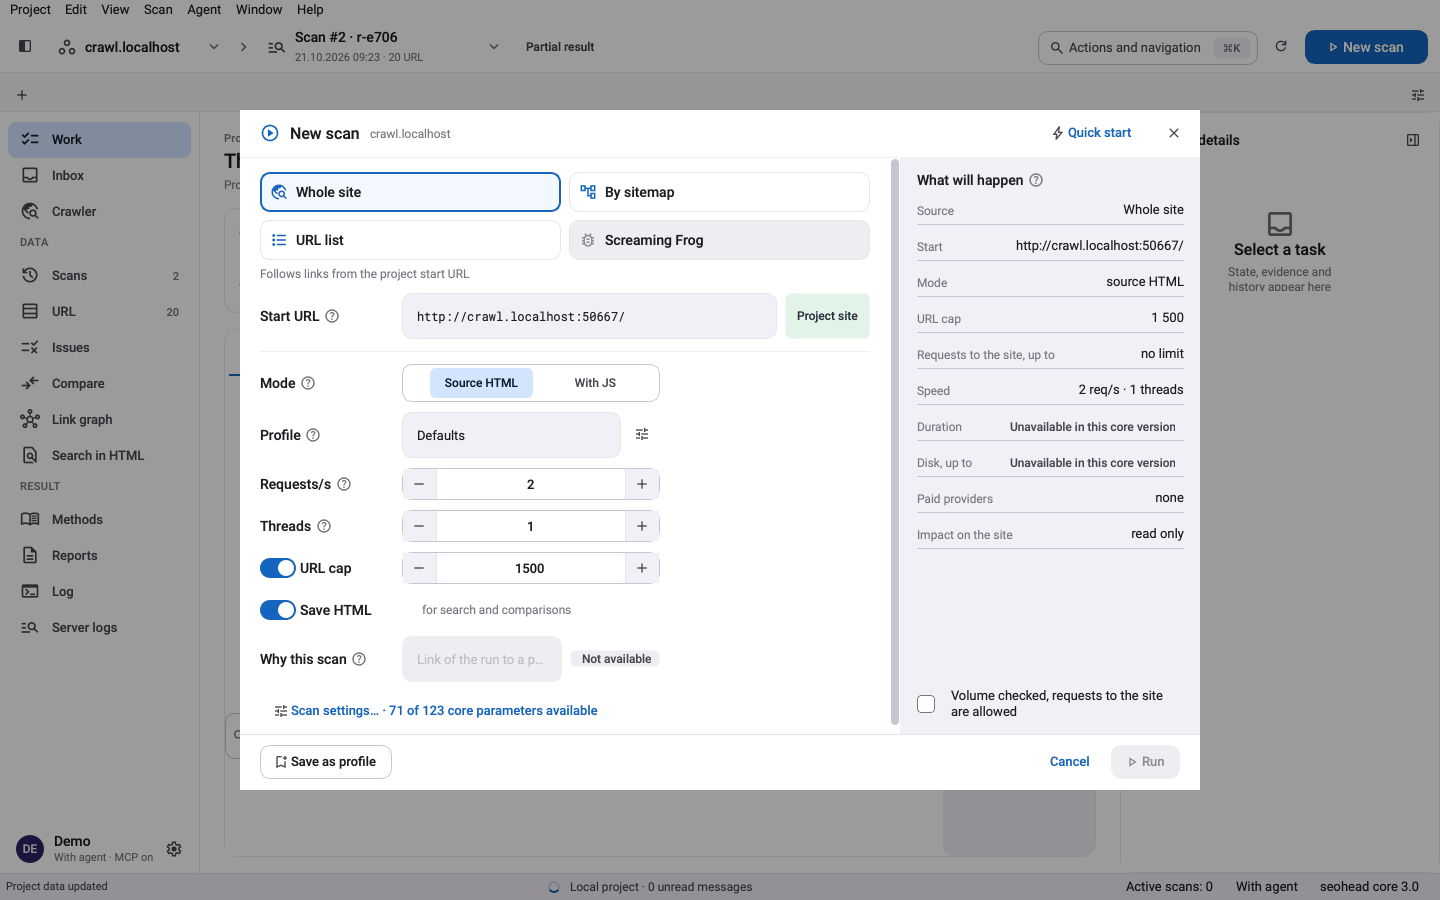
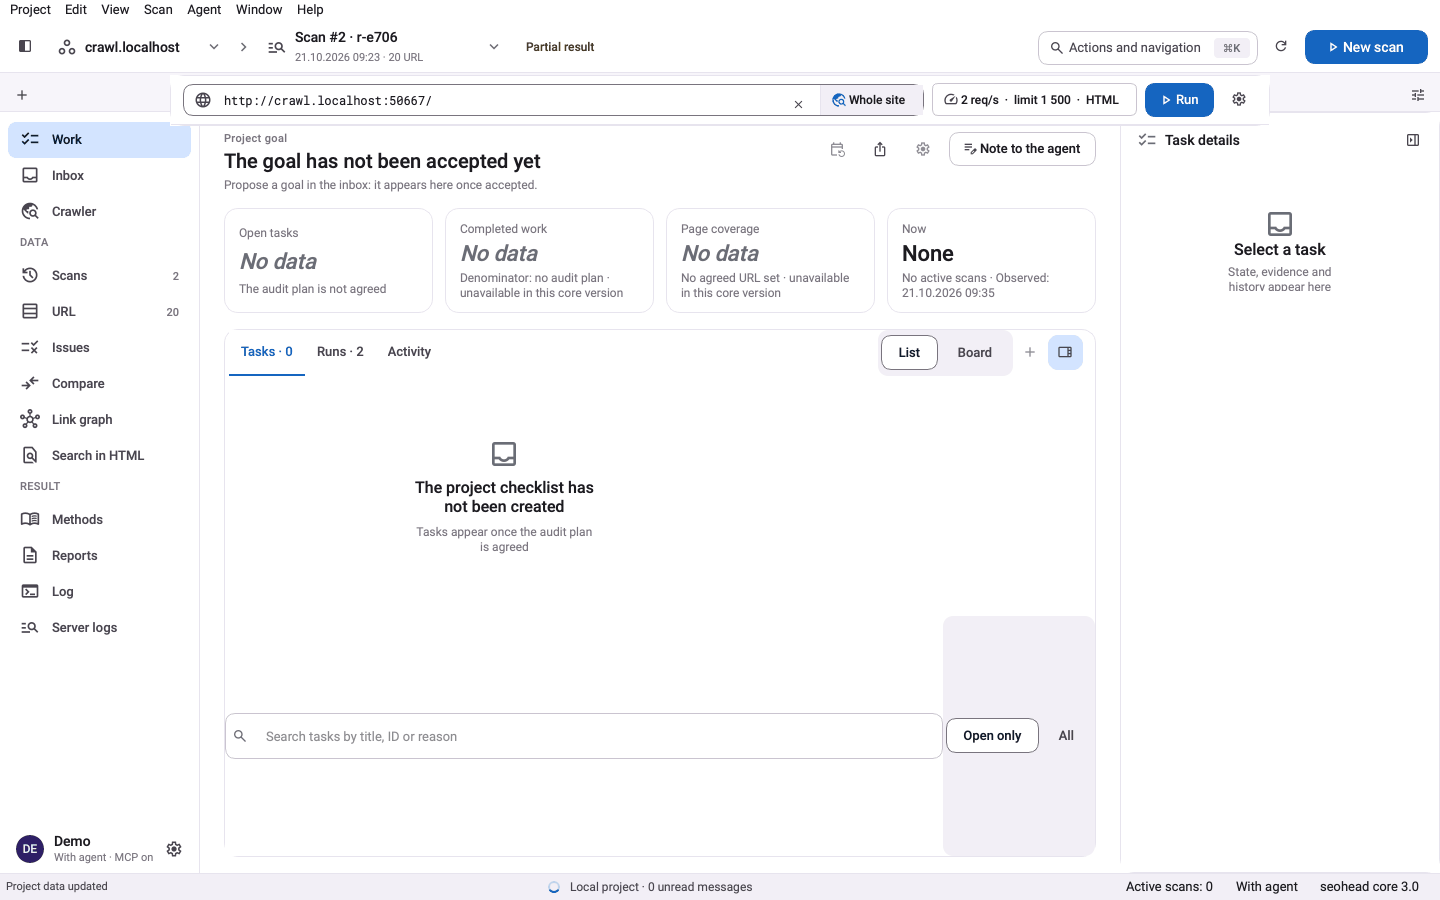
En la aplicación de escritorio, introduce una URL y pulsa Iniciar; el resultado puedes guardarlo como proyecto más tarde. En la terminal, crawl-site sigue los enlaces desde la URL de inicio y escribe un único escaneo nativo en SQLite que puedes reabrir, exportar y volver a analizar sin conexión. El mismo rastreo está disponible para un agente de IA a través del servidor MCP local como seo_crawl_site.

  • Mismo host por defecto; los subdominios son una opción (scope.internal)
  • robots.txt se respeta por defecto
  • Gratis y local: sin cuenta alojada ni licencia de Screaming Frog

Las comprobaciones que no pueden ejecutarse lo dicen

Un rastreo nativo no recoge todos los tipos de evidencia. Una comprobación que necesita datos que el rastreo no recogió sale como omitida, con un motivo, nunca como un falso «limpio». Cada comprobación termina como incidencia, se ejecutó sin incidencias, se omitió o falló.

  • Cuatro resultados por comprobación, para que ningún hueco quede oculto
  • Las comprobaciones basadas en enlaces que necesitan un rastreo completo se retienen en uno parcial

Tres pasos, un análisis guardado

  1. Empieza desde una URL

    Introduce una URL de inicio en la aplicación de escritorio o ejecuta crawl-site en la terminal. Sigue los enlaces del mismo host y escribe un único escaneo nativo en SQLite que puedes reabrir.

  2. Sé respetuoso por defecto

    Unas dos peticiones por segundo por host, con pausas adaptativas. Tú fijas el límite de URL; por defecto son 200 URL.

  3. Audita las mismas evidencias

    El rastreo se comprueba con el mismo registro que las exportaciones de Screaming Frog. Una comprobación que necesita datos que un rastreo nativo no puede recoger se marca como omitida, con un motivo, nunca como limpia.

Comprobaciones de esta función

ComprobaciónQué significaGravedadEvidencia
BROKEN_PAGE_4XXLa página rastreada devuelve una respuesta 4xxCriticalURL y código de estado
SERVER_ERROR_5XXLa página rastreada devuelve una respuesta 5xxCriticalURL y código de estado
NO_RESPONSESin respuesta: tiempo de espera agotado, fallo de DNS o de conexiónCriticalURL y motivo del fallo
BROKEN_INTERNAL_LINKUn enlace interno apunta a una URL 4xxCriticalPágina de origen y posición del enlace
REDIRECT_LOOPLa cadena de redirecciones vuelve a una URL ya visitadaCriticalRuta del bucle
REDIRECT_CHAINDos o más saltos de redirección antes de la URL finalImportantCada salto con su código de estado
BLOCKED_BY_ROBOTSrobots.txt bloquea la URL, así que el rastreo no la descargóImportantURL y regla de robots.txt que coincide

Un solo comando

bash
seohead crawl-site --url https://example.com --max-urls 500 --scan-out ./scans/audit.sqlite

Primero, instala SpiderHead: guía de instalación. Cada comando también funciona como herramienta MCP para agentes de IA.

Qué necesitas

  • Una URL de inicio (o una lista de URL con --urls o --urls-file)
  • Una ruta para el archivo de escaneo (--scan-out) o una carpeta de proyecto
  • Opcional: un archivo de configuración del rastreador (JSON); crawl-site --config-help muestra todos los ajustes

Límites

  • El rastreo básico lee HTML estático; el renderizado de JavaScript es un complemento opcional
  • Se detiene en 200 URL por defecto; sube --max-urls a propósito (hasta 1 000 000)
  • No sustituye por completo a Screaming Frog: algunas comprobaciones salen como omitidas
  • Sigue los enlaces de un solo host, salvo que amplíes el alcance

Preguntas

¿Necesito una licencia de Screaming Frog?
No. El rastreo nativo se ejecuta en local y no necesita cuenta alojada ni licencia de Screaming Frog. Las exportaciones de Screaming Frog se pueden importar si ya las tienes.
¿Es un sustituto completo de Screaming Frog?
No, y no pretende igualarlo. Las comprobaciones que necesitan evidencias que un rastreo nativo no recogió se informan como omitidas, y summary.check_coverage muestra cuánto del registro se ejecutó.
¿Respeta robots.txt?
Sí, por defecto. Si robots.txt no se puede obtener en absoluto, el rastreo se detiene en lugar de suponer acceso (robots.unavailable_means_stop, activado por defecto). Usa --robots report_only para rastrear igualmente y listar lo que se bloquearía.
¿Cuántas URL rastreará?
El límite por defecto es de 200 URL. Define --max-urls hasta 1 000 000, o 0 para no tener límite de URL, que sigue acotado por las demás protecciones de recursos. Los rastreos que superan los presupuestos del proyecto necesitan --approve-large-crawl.
¿Puede renderizar páginas con JavaScript?
No en el rastreo por defecto. El renderizado es opcional: instala el extra render y un navegador de Playwright, y después define rendering.mode como js en la configuración del rastreo. El rastreo básico funciona sin navegador.

Pruébalo en tu propio sitio