
リンク元と位置がわかるリンク切れチェッカー

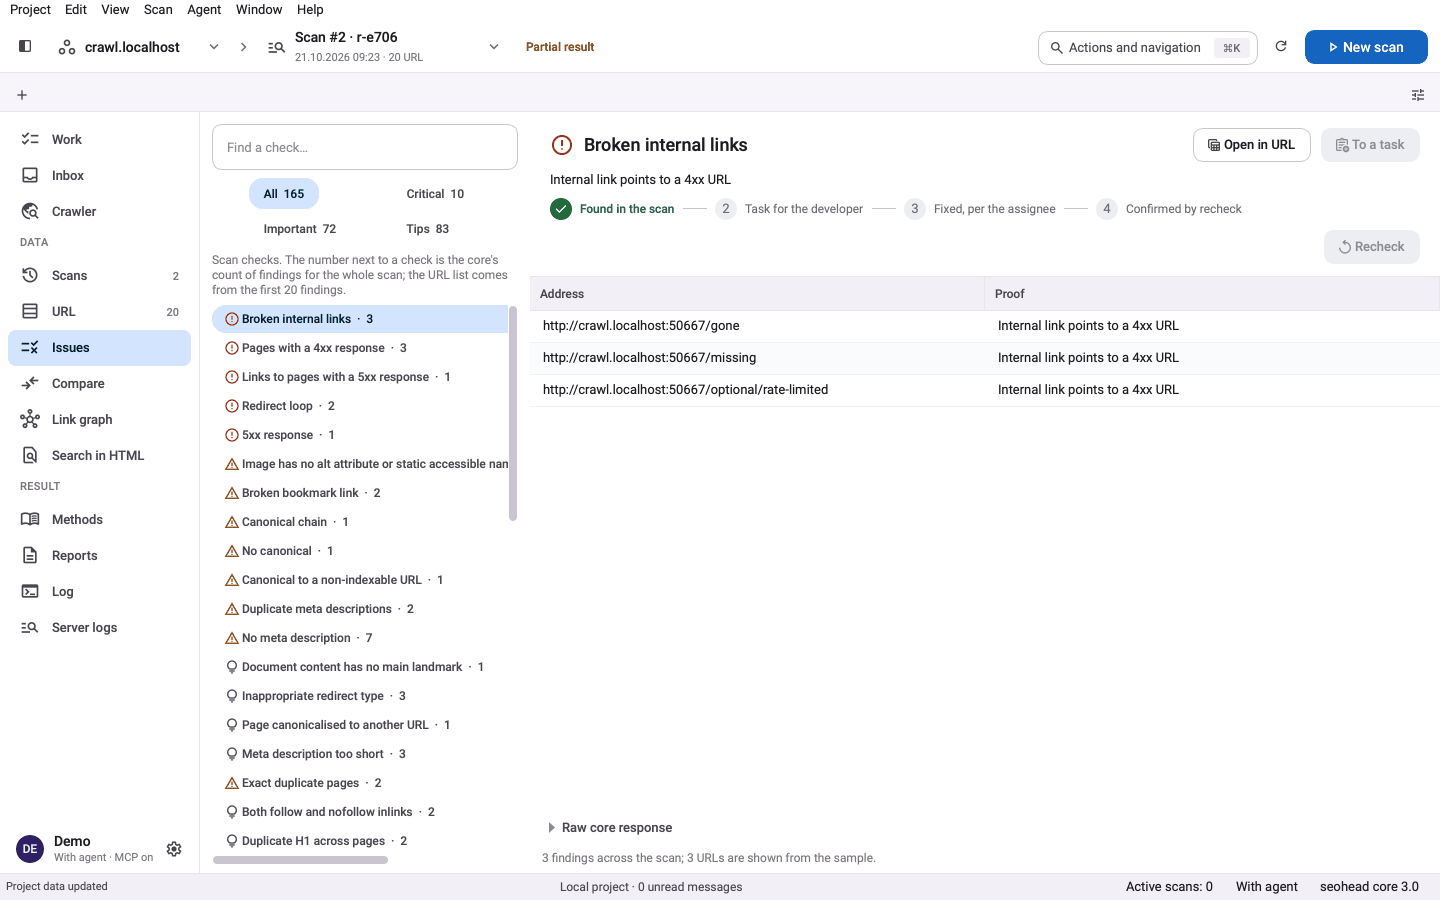
4xxや5xxのURLへの内部リンクと外部リンクを検出し、リンク元のページと、テンプレート内でリンクがある位置もあわせて示します。

できること

ページごとではなく、テンプレートを直す

リンク切れの宛先ごとに、リンクしているページと、リンクの位置(コンテンツ、ナビゲーション、フッターなど)を一覧にします。同じリンク切れが共通ブロックにあれば、テンプレートを1回直すだけで、該当するすべてのページが解消します。Screaming FrogのInlinksエクスポートには、リンクのXPathも含まれます。

  • すべてのリンク切れについて、リンク元ページを表示
  • リンクの位置:コンテンツ、ナビゲーション、フッターなど
  • ネイティブクロールで取得した各リンクのXPath
  • 内部の4xx、内部の5xx、外部のリンク切れを別々のチェックとして実行

リンクの健全性

リンク先が存在しない場合だけでなく、技術的に誤っているリンクもチェックします。宛先ページにその要素がないフラグメントや、noopenerもnoreferrerもないtarget=_blankのリンクを検出します。アンカーテキストも代替テキストもない画像リンクは、リンク先が訪問者に伝わらないため検出対象です。

  • どこにも対応しないフラグメント(#id)
  • 安全でないtarget=_blankのリンク
  • テキストのない画像リンク
  • アンカーテキストが空のリンク

1ページでもサイト全体でも

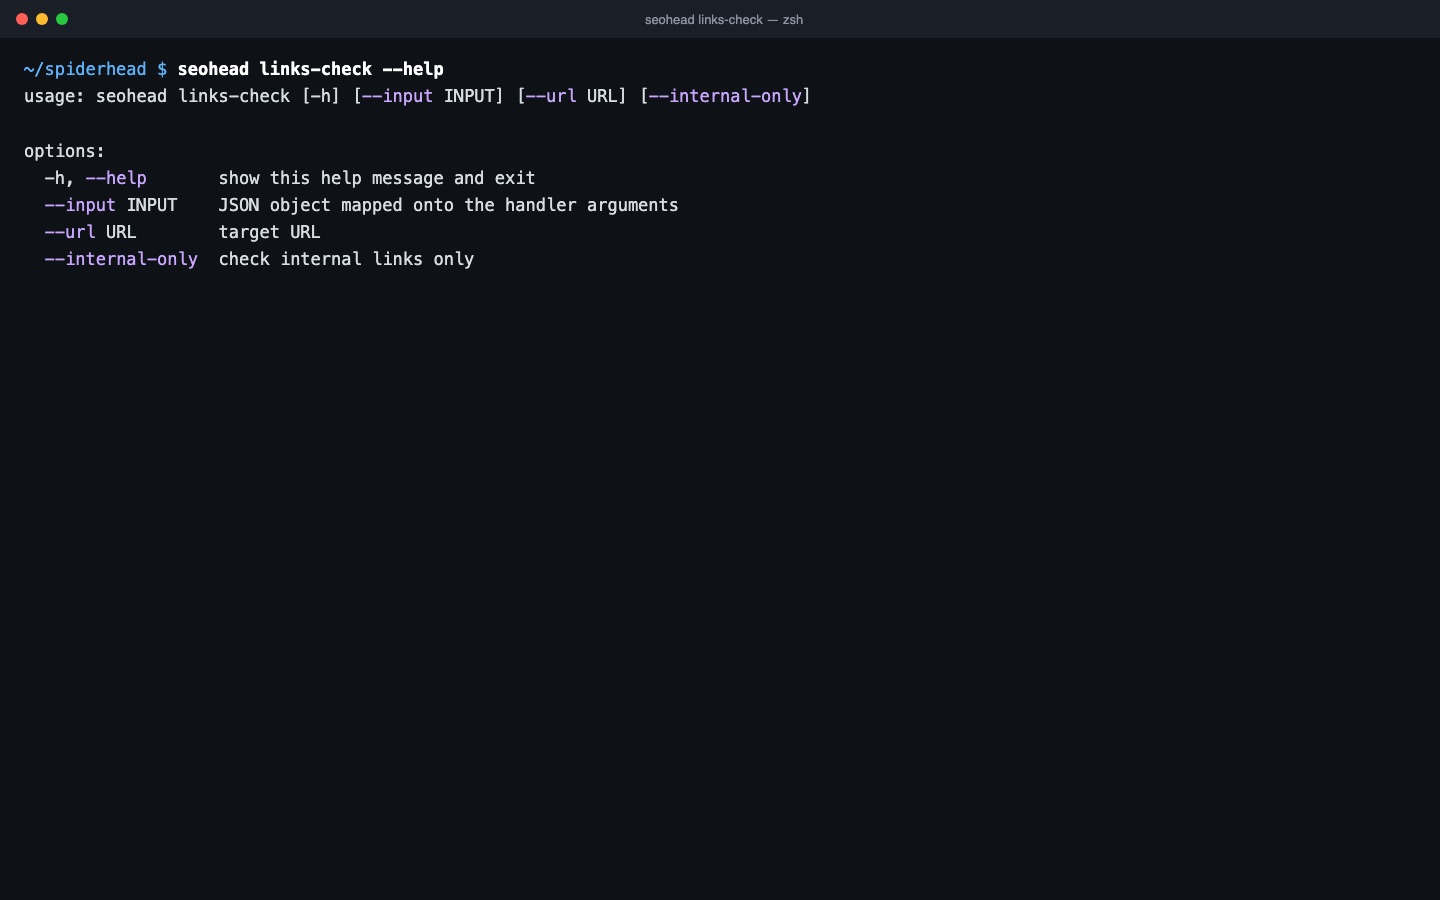
links-checkは、1ページのリンクをその場で確認し、結果をすぐに表示します。サイト全体を確認するときは、crawl-siteが開始URLからサイトをたどり、すべてのリンクをローカルのスキャンに保存します。監査はそのスキャンを読みます。宛先を取得できていないリンクは、リンク切れとは判定しません。

  • links-check:1ページをその場で確認
  • crawl-site:リンクグラフ全体を取得
  • --internal-onlyで外部リンクを除外

3ステップで、スキャンを1件保存

  1. 1ページかサイト全体を確認

    links-checkは、1ページのリンクをその場で確認します。crawl-siteは開始URLからサイトをたどり、結果を保存して、サイト全体の監査に使います。

  2. リンク切れの位置を確認

    ネイティブクロールでは、リンク切れごとに、リンク元ページ、リンクの位置、XPathが一覧に出ます。

  3. 共通ブロックを1回で修正

    リンク切れの宛先ごとに、リンクしているすべてのページが一覧に出ます。フッターやメニューのリンク切れは、テンプレート1か所の修正で解消します。

この機能のチェック項目

チェック項目意味重要度根拠
BROKEN_INTERNAL_LINK内部リンクが4xxのURLを指していますCriticalネイティブクロール:リンク元ページとリンクの位置(リンク先が4xx)
LINK_TO_5XX内部リンクが5xxのURLを指していますCriticalネイティブクロール:リンク元ページとリンクの位置(リンク先が5xx)
BROKEN_EXTERNAL_LINK外部リンクが切れたURL(4xxまたは5xx)を指していますImportantネイティブクロール:リンク元ページ(リンク切れの外部リンク先)
BROKEN_BOOKMARKリンクのフラグメント(#id)に対応する要素が、宛先ページにありませんImportant保存したページHTMLに対するクロールのフラグメントチェック
IMAGE_LINK_WITHOUT_TEXT画像リンクにアンカーテキストも代替テキストもなく、リンク先がわかりませんImportantクロールで取得したリンクの位置
UNSAFE_CROSS_ORIGIN_LINKtarget="_blank"のリンクに、rel="noopener"もrel="noreferrer"もありませんImportantクロールのリンク検出結果
チェック一覧にある関連項目
INTERNAL_LINK_NO_ANCHOR

コマンド1つで実行

bash
seohead links-check --url https://example.com/

先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。

必要なもの

  • links-check用のページURL
  • クロールの開始URL、または監査で使うScreaming FrogのInlinksエクスポート
  • APIキーは不要

制限事項

  • links-checkの対象は1ページで、初期設定ではユニークな宛先を最大200件まで確認します
  • 外部サイトの403は誤検出の場合があります。クローラーを意図的にブロックしているサイトがあるためです
  • リダイレクトは一覧に出ますが、チェーンとループはリダイレクトチェッカーの担当です
  • JavaScriptで追加されたリンクは、ページをレンダリングしないと見落とす場合があります

よくある質問

Screaming Frogは必要ですか?
不要です。links-checkは他のツールなしで1つのURLを確認でき、crawl-siteはSpiderHead独自のクローラーです。Screaming FrogのInlinksエクスポートは、監査で使える証拠のひとつで、リンクの位置とXPathがわかります。リンクのデータがまったくない場合、リンクのチェックは問題なしと返さず、理由を付けてスキップします。
サイト内のすべてのリンクを確認しますか?
links-checkの対象は、指定した1つのURLのリンクです。初期設定では、ページごとにユニークな宛先を最大200件まで確認します。サイト全体は、クロールしてスキャンを監査します。
403はリンク切れとして報告されますか?
報告されます。外部サイトの4xxは、外部のリンク切れとして報告します。サイトによっては、意図的にクローラーへ403を返します。削除する前に、該当リンクを手作業で確認してください。
リダイレクトはたどりますか?
たどりません。links-checkはリダイレクト(3xx)を、Locationとあわせて別枠で一覧にします。リダイレクトチェーンとループは、リダイレクトチェッカーの担当です。
サイトに変更を加えますか?
加えません。チェックで送るのは読み取り専用のリクエストです。クロールではローカルのマシンにSQLiteのスキャンファイルを書き出し、レポートはファイルとして残ります。
#pricingのようなアンカーのフラグメントも確認できますか?
できます。宛先ページにその要素がないフラグメントは、壊れたブックマークとして報告します。