
クロール範囲・robots.txt・ディレクティブ

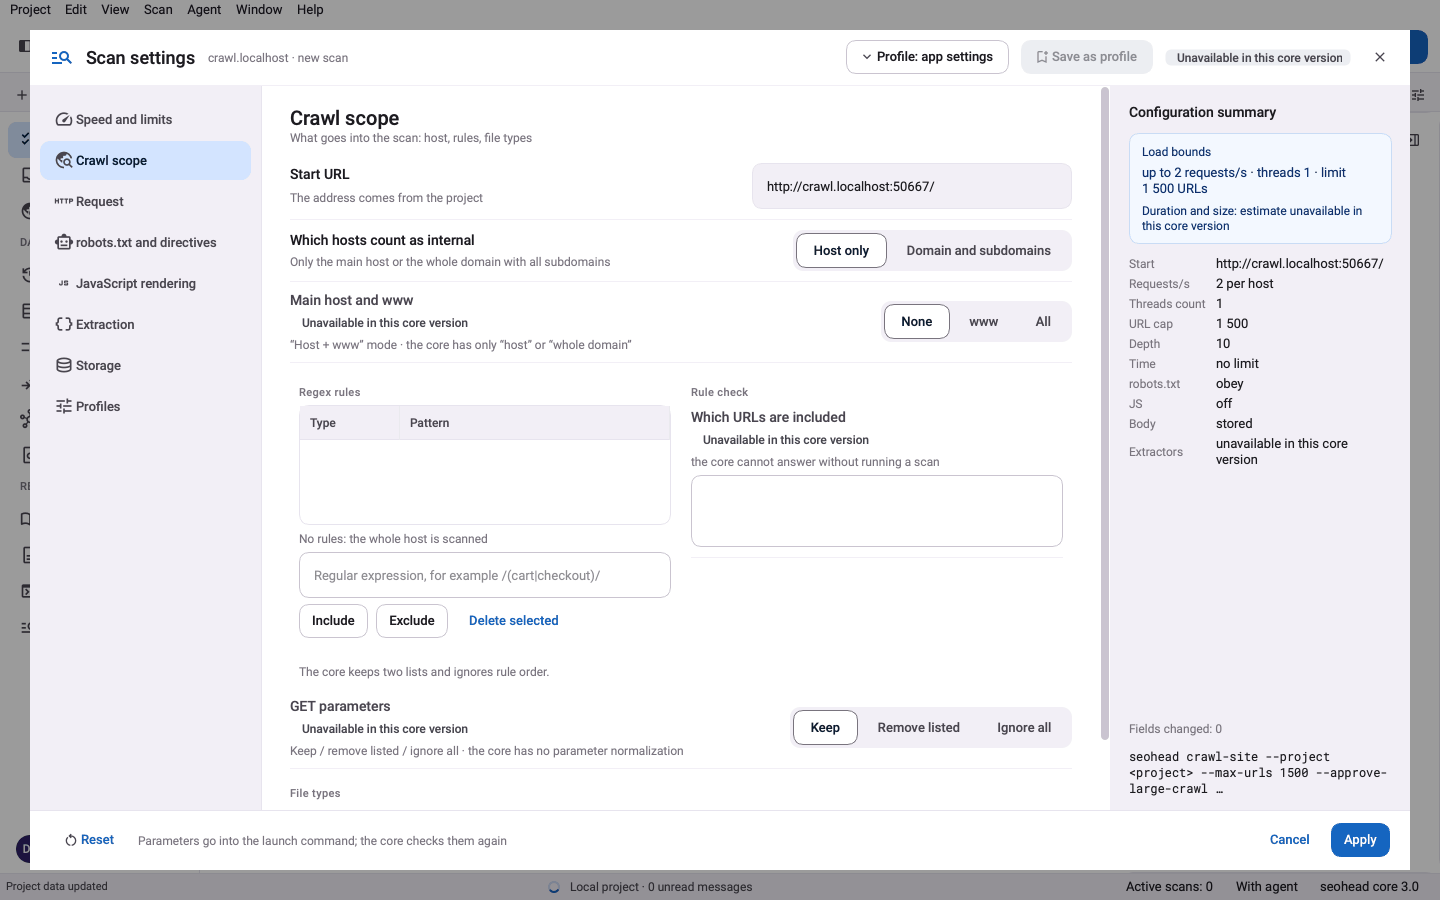
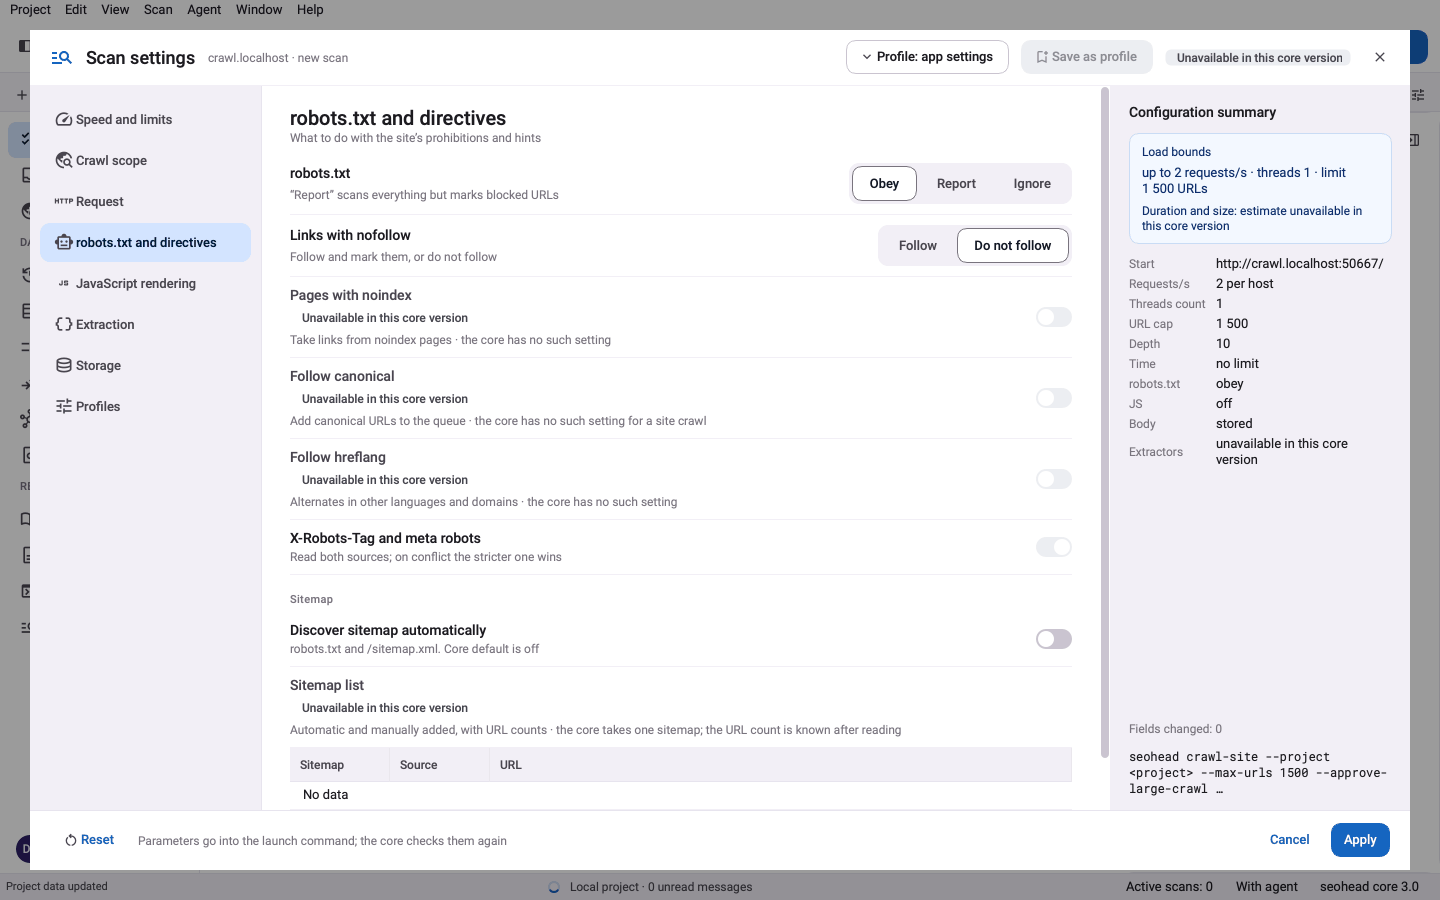
クロールで触れてよい範囲を決めます。範囲のルール、robotsポリシー、そしてどのルールがどのURLをブロックしているかを説明するrobots.txtのチェックを用意しています。

できること

robots.txtのチェック

robots-checkはrobots.txtを取得し、ユーザーエージェントのグループ、宣言されたサイトマップ、指定したパスがクロール可能かどうかを報告します。404などの4xxは、robots.txtがないものとして扱い、クロールを許可と判定します。429や5xxはエラーです。確認できなかったアクセスを、許可とは報告しません。

  • レンダリングに必要なJSやCSSがブロックされている場合は、監査で検出します(ROBOTS_BLOCKS_RESOURCES)
  • Sitemapディレクティブの有無(SITEMAP_NOT_IN_ROBOTS)

ディレクティブ

監査では、ページ単位のnoindex、nofollow、nosnippet、unavailable_afterを、X-Robots-Tagヘッダーとあわせて読み取ります。head要素の外に置かれたrobotsメタディレクティブも検出します。その位置では効果がないためです。robots.txtが制御するのはクロールで、インデックス登録ではありません。そのため、これらのディレクティブは別にチェックします。

3ステップで、スキャンを1件保存

  1. クロール範囲を設定

    含めるパターンと除外するパターン、名前付きセグメント、拡張子フィルター、深度の上限、URL数の上限で、クロールが取得するページを決めます。

  2. robotsポリシーを選ぶ

    クロールごとに、robots.txtに従う、ブロック内容を報告するだけにする、無視する、のいずれかを選べます。フラグは--robotsで、respect、report_only、ignoreを指定します。

  3. クロールの前にパスをテスト

    robots-checkは、1つのユーザーエージェントについてファイルを読み、グループとサイトマップを一覧にします。特定のパスをテストするには、--input JSONか、MCPツールのseo_robots_checkで渡します。

この機能のチェック項目

チェック項目意味重要度根拠
IMPORTANT_URL_BLOCKED_BY_ROBOTS内部リンクを受けている公開中のページが、robots.txtでブロックされています。リンクが発見に役立たず、クロールの経路からページが外れます。robots.txtがブロックするのはクロールで、インデックス登録ではありません。ImportantブロックされたURL、そのURLを指す内部リンク、該当するDisallowルール
BLOCKED_BY_ROBOTSURLがrobots.txtでブロックされています。意図したブロックか確認してください。ImportantブロックされたURLと、該当するルール
ROBOTS_BLOCKS_RESOURCESレンダリングに必要なJavaScriptやCSSがrobots.txtでブロックされており、検索エンジンがページを不完全にレンダリングする場合があります。Tipブロックされた.jsまたは.cssのURLと、ブロックしているルール
DIRECTIVES_OUTSIDE_HEADrobotsメタディレクティブがhead要素の外にあるため、適用されません。その位置にあるnoindexやnofollowは、効果がありません。Criticalドキュメント内で、ディレクティブの直前にある要素
UNAVAILABLE_AFTERページにunavailable_afterディレクティブがあり、指定の日付にインデックスから削除されます。Importantディレクティブの値と日付
NOINDEXページにnoindexディレクティブがあります。インデックスから外れることが意図どおりか確認してください。Tipディレクティブの出どころ:メタrobotsまたはX-Robots-Tag
SITEMAP_NOT_IN_ROBOTSrobots.txtにSitemapディレクティブがありません。サイトマップの絶対URLで追加すると、クローラーが見つけやすくなります。Tiprobots.txtで見つかったSitemapディレクティブ
チェック一覧にある関連項目
NOSNIPPET

コマンド1つで実行

bash
seohead robots-check --url https://example.com/

先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。

必要なもの

  • robots-check用のサイトまたはページのURL
  • パスとユーザーエージェントを指定する場合:MCPツールのseo_robots_check、または--input JSONオプション
  • クロールの場合:--robotsポリシーと、設定ファイルに書く任意の範囲ルール

制限事項

  • コマンドラインのrobots-checkが受け取るのはURLだけです。パスとユーザーエージェントは、--inputまたはMCPで渡します
  • robots.txtのルールは、一度に1つのユーザーエージェントについてテストします
  • ignoreでは、robots.txtをまったく取得しません
  • 範囲のルールは取得するページを決めます。検出結果の除外は、クロール後に検出結果を非表示にするだけです

よくある質問

robots.txtを設定すれば、ページはGoogleに表示されませんか?
表示される場合があります。robots.txtが止めるのはクロールです。ブロックされたページでも、リンクをもとにインデックスに登録されることがあります。ページがブロックされている間は、そのページのnoindexも読まれません。インデックスに登録したくないページは、クロールを許可したうえでnoindexを使います。
robots.txtがない場合、robots-checkはどう動きますか?
404などの4xxは、robots.txtが存在しないという意味です。レポートでは、クロールを許可と判定します。429や5xxはエラーとして返り、クロール許可とは報告しません。
サイトの一部のセクションだけをクロールできますか?
できます。範囲のincludeまたはexcludeパターン、名前付きセグメントだけを取得するsegments_only、拡張子やメディアタイプのフィルターを使います。深度とURL数の上限で、クロールが設定した範囲に収まります。
クロールは、初期設定でrobots.txtに従いますか?
従います。初期設定のポリシーはrespectです。report_onlyは、従わずに、robots.txtがブロックする内容だけを記録します。ignoreはrobots.txtを読み飛ばします。どのユーザーエージェントのルールを照合するかは、robots.user_agent_tokenの設定で選びます。