
Crawler sans projet
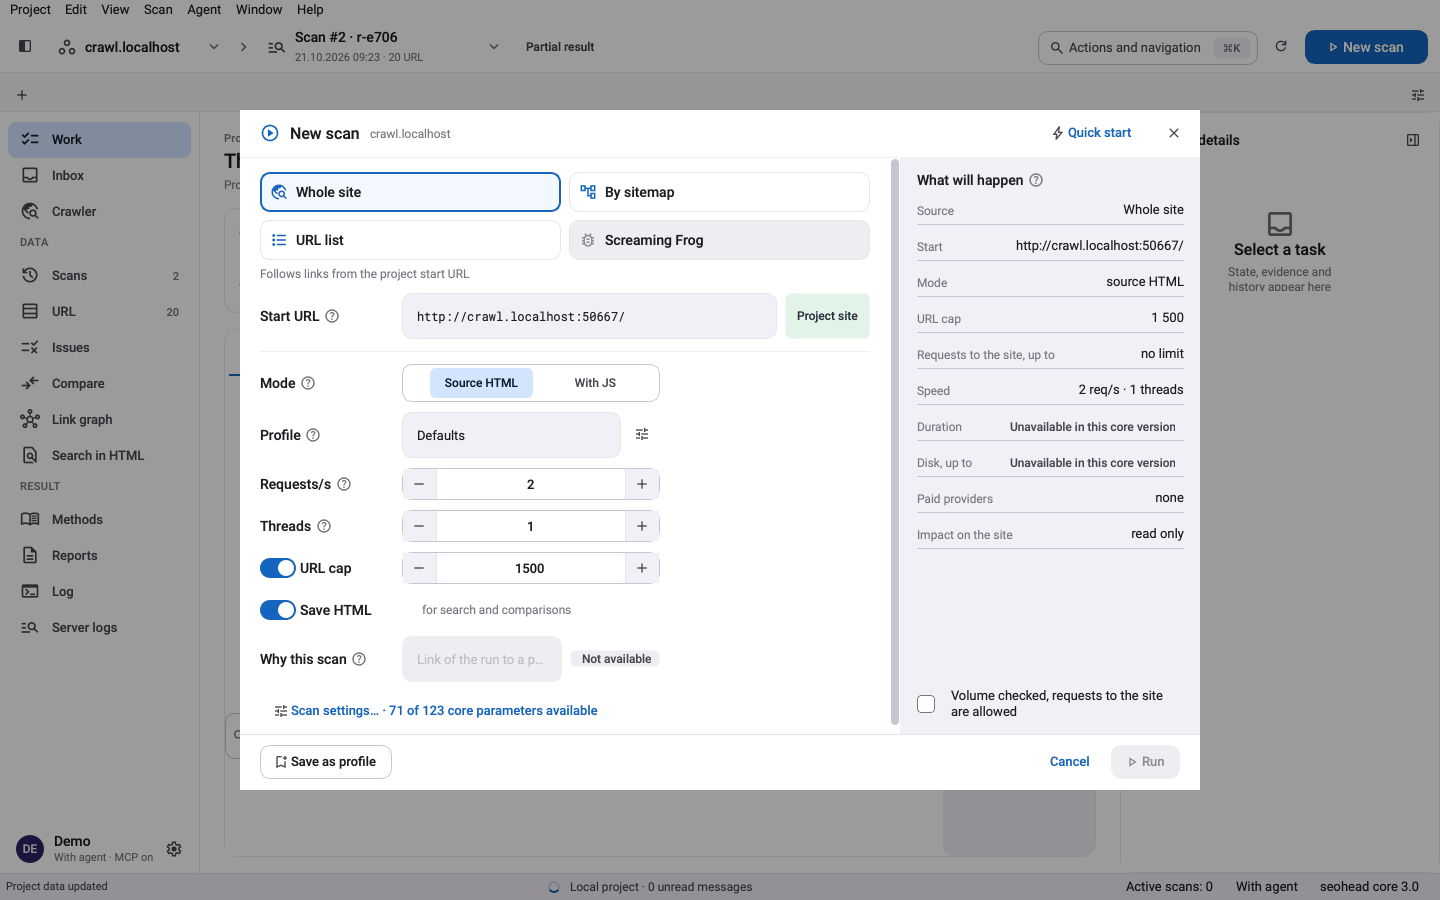
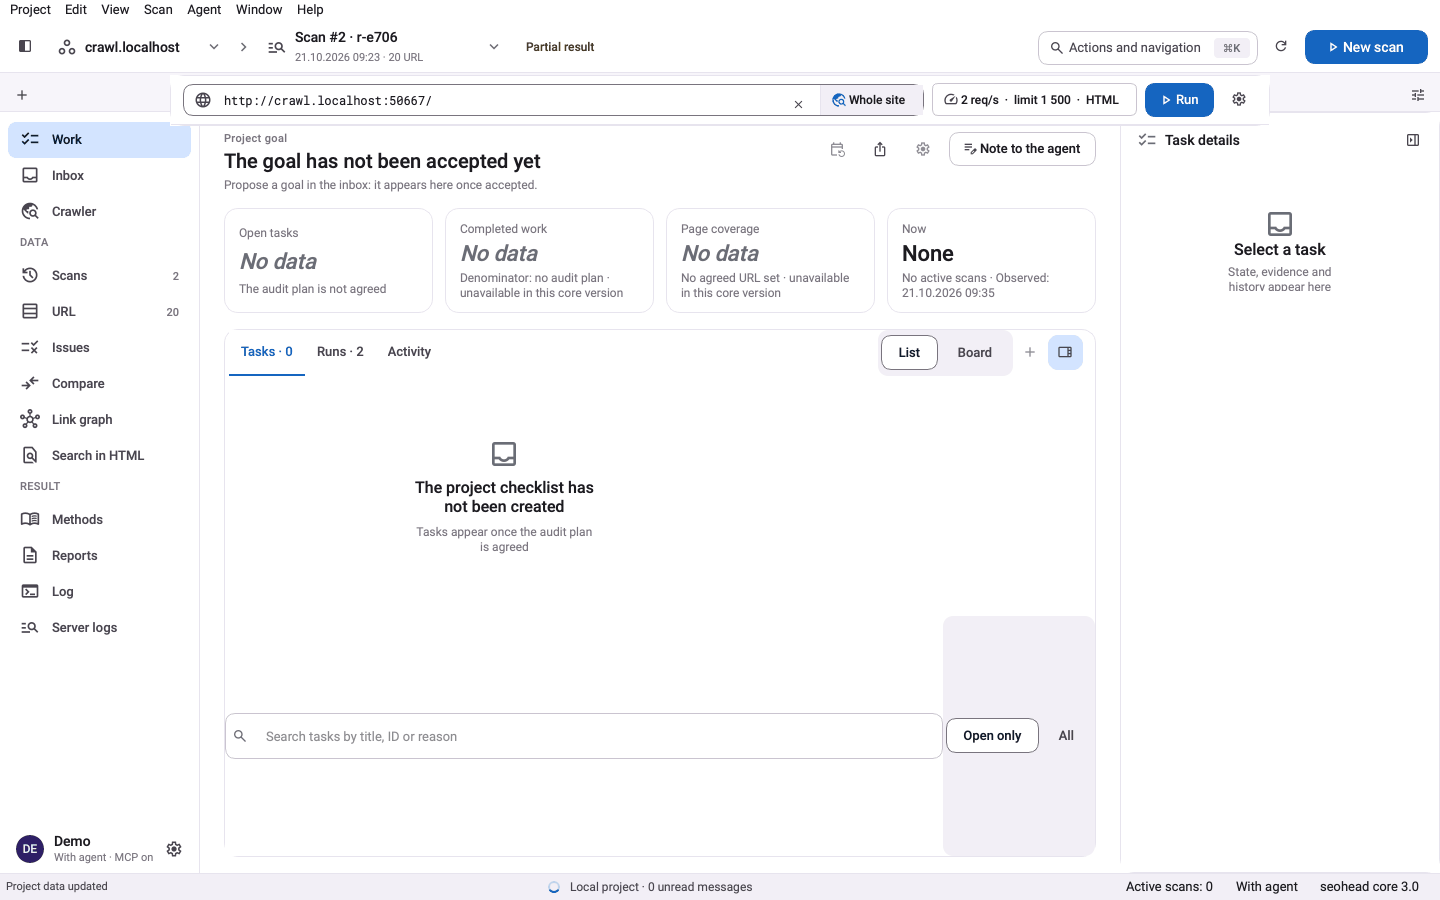
Dans l'application de bureau, saisissez une URL et lancez le scan ; vous pourrez enregistrer le résultat comme projet plus tard. Dans le terminal, crawl-site suit les liens depuis l'URL de départ et écrit un seul scan SQLite natif que vous pouvez rouvrir, exporter et réanalyser hors ligne. Le même crawl est accessible à un agent IA via le serveur MCP local, sous le nom seo_crawl_site.
- Même hôte par défaut ; les sous-domaines sont une option à activer (scope.internal)
- robots.txt est respecté par défaut
- Gratuit et local : ni compte hébergé ni licence Screaming Frog