
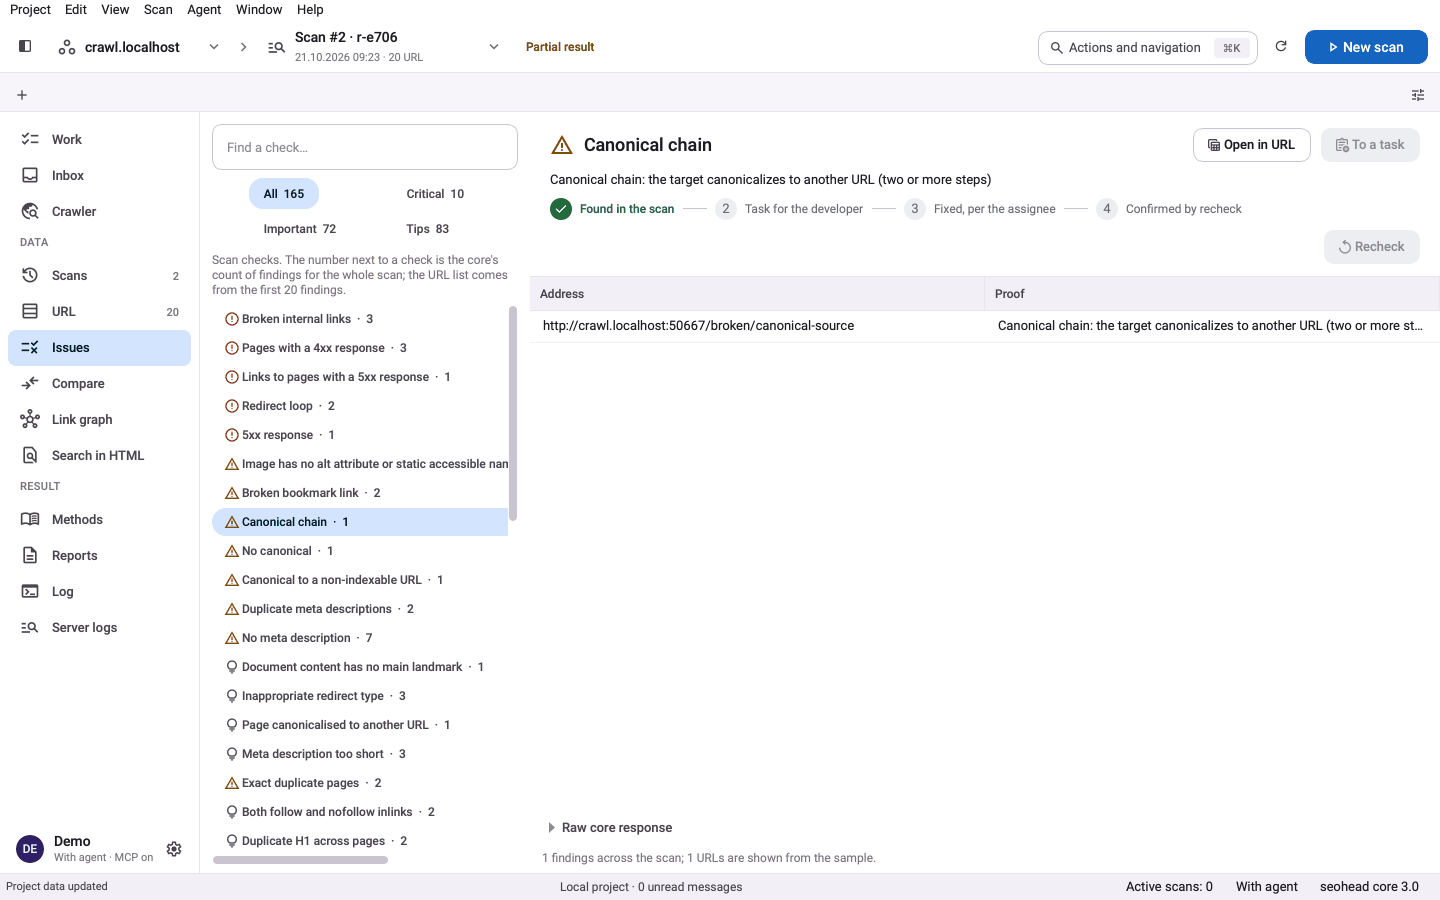
canonicalタグチェッカー

canonicalのチェックは、ページ単位と、クロール全体のグラフの両方で行います。チェーン、リダイレクトやエラーを指すcanonical、相対パス・フラグメント・複数指定のcanonical、どこからもリンクされていない宛先を検出します。

できること

ページ単位のタグ

各ページのcanonicalを読み取り、ページごとに検証します。canonicalがない場合、相対パス、複数指定、フラグメント付きの場合を検出します。headの外に置かれたcanonicalリンクや、そこにあるべきでない属性が付いたものも検出します。別のURL、別のホスト、インデックス不可のページを指すcanonicalは、それぞれ別の検出結果になります。意図したものかどうかは、見て判断できます。

  • canonicalがない、複数ある、相対パス、フラグメント付き
  • headの外にあるcanonical、または無効な属性が付いたcanonical
  • 別ホストの宛先と、インデックス不可の宛先

canonicalグラフ

クロール全体のcanonicalの宛先から、グラフを作ります。宛先のページがさらに別のURLを正規化しているチェーン、リダイレクトやエラーを指すcanonical、異なるセクションの複数のページがすべてトップページに正規化されているグループが見つかります。内部リンクが1本もない宛先も検出します。

  • 2段階以上のチェーン
  • 3xx、4xx、5xxのURLを指すcanonical
  • 複数のセクションのページが、トップページに正規化されている
  • 内部リンクのない宛先

ポリシー

ページネーションとフィルターのページには、専用のルールが必要です。最初のページへのcanonicalは、あるサイトでは正しく、別のサイトでは誤りになるためです。プロジェクトのポリシーで期待する状態を設定すると、検出結果ごとに、期待する宛先と実際の宛先が並んで表示されます。

  • ページネーションのcanonicalポリシー
  • フィルターのcanonicalポリシー
  • 証拠に、期待する宛先を表示

3ステップで、スキャンを1件保存

  1. すべてのcanonicalタグを読み取る

    各ページのcanonicalを読み取り、canonicalがない、複数ある、相対パス、#フラグメント付きの値を確認します。

  2. canonicalグラフを作る

    クロール全体のcanonicalの宛先からグラフを作ります。チェーンとループは、ページ間の経路として表れます。

  3. 各宛先をテストする

    宛先ごとに、リダイレクト、4xxや5xxのエラー、内部リンクの有無を確認します。

この機能のチェック項目

チェック項目意味重要度根拠
CANONICAL_MISSINGインデックス可能なページに、canonical URLがありませんImportantページのURL
CANONICAL_MULTIPLEページが、複数のcanonical URLを宣言していますImportantページのURLと、すべてのcanonicalの値
CANONICAL_CHAINcanonicalの宛先が、さらに別のURLに正規化されています(2段階以上)Importantcanonical URLのチェーン全体
CANONICAL_TO_REDIRECTcanonicalが、3xxのリダイレクトを返すURLを指していますImportantcanonicalの宛先と、そのリダイレクトのステータス
CANONICAL_TARGET_ERRORcanonicalが、4xxまたは5xxを返すURLを指していますImportantcanonicalの宛先と、そのステータスコード
CANONICAL_HOMEPAGE_GROUP複数のセクションにある別々のインデックス可能ページが、すべてトップページに正規化されていますImportantトップページを指しているページの一覧
UNLINKED_CANONICALクロール内のどこからも、canonicalの宛先への内部リンクがありませんImportantcanonicalの宛先URL
チェック一覧にある関連項目
CANONICAL_RELATIVECANONICAL_FRAGMENTPAGINATION_CANONICAL_POLICYFILTER_CANONICAL_POLICY

コマンド1つで実行

bash
seohead parse --url https://example.com/page

先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。

必要なもの

  • canonicalを読み取るための、parse用のURL 1件
  • グラフのチェックに使う、クロール結果またはScreaming FrogのInternal:Allエクスポート
  • 任意:ページネーションとフィルターページ用のプロジェクトポリシー

制限事項

  • URL 1件では、チェーン、エラーの宛先、トップページのグループは確認できません。クロールのグラフが必要です
  • canonicalは検索エンジンへのヒントです。チェックでわかるのは宣言された内容で、GoogleがどのURLを選んだかではありません
  • ポリシーのチェックには、プロジェクトでのポリシー設定が必要です
  • クロールに含まれないページは、宛先としてチェックできません

よくある質問

URL 1件でも問題は見つかりますか?
seohead parseでURL 1件を調べると、そのcanonicalの値がわかります。チェーン、リダイレクトの宛先、エラーの宛先、トップページのグループのチェックには、クロール全体から作ったグラフが必要です。
サイトに変更を加えますか?
加えません。チェックはページを読み取るだけです。canonicalタグの修正は自分で行います。
Screaming Frogは必要ですか?
不要です。グラフのチェックはクロールデータで動きます。データは、Screaming FrogのInternal:Allエクスポート(sf run --exports-dir)でも、SpiderHead独自のcrawl-siteでも取得できます。ライセンス版のScreaming Frog CLIが必要なのは、--crawlでScreaming Frogのクロールを実行する場合だけです。
ページネーションやフィルターのページはどうなりますか?
PAGINATION_CANONICAL_POLICYとFILTER_CANONICAL_POLICYの2つのチェックが、各canonicalをプロジェクトのポリシーと照合し、期待する宛先を表示します。
Googleが選んだcanonicalはわかりますか?
Search Consoleを連携している場合のみわかります。GSC_USER_CANONICAL_NOT_SELECTEDが、宣言したcanonicalと、URL検査でGoogleが選択したcanonicalを比較します。連携していない場合、チェックでわかるのはページの宣言内容です。