
保持されるスキャン
ネイティブのスキャンは、証拠データ、キュー、すべての設定をまとめて保持する1つのSQLiteファイルです。サイトに再アクセスせず、オフラインで検査、エクスポート、スナップショット、固定、削除、再キュー、本文の差分比較、再分析ができます。完了したスキャンは変更されません。
- scan-reanalyzeは保持したHTMLを再解析
- ベースライン用のスナップショットと固定
ネイティブのスキャンは、証拠データ、キュー、すべての設定をまとめて保持する1つのSQLiteファイルです。サイトに再アクセスせず、オフラインで検査、エクスポート、スナップショット、固定、削除、再キュー、本文の差分比較、再分析ができます。完了したスキャンは変更されません。
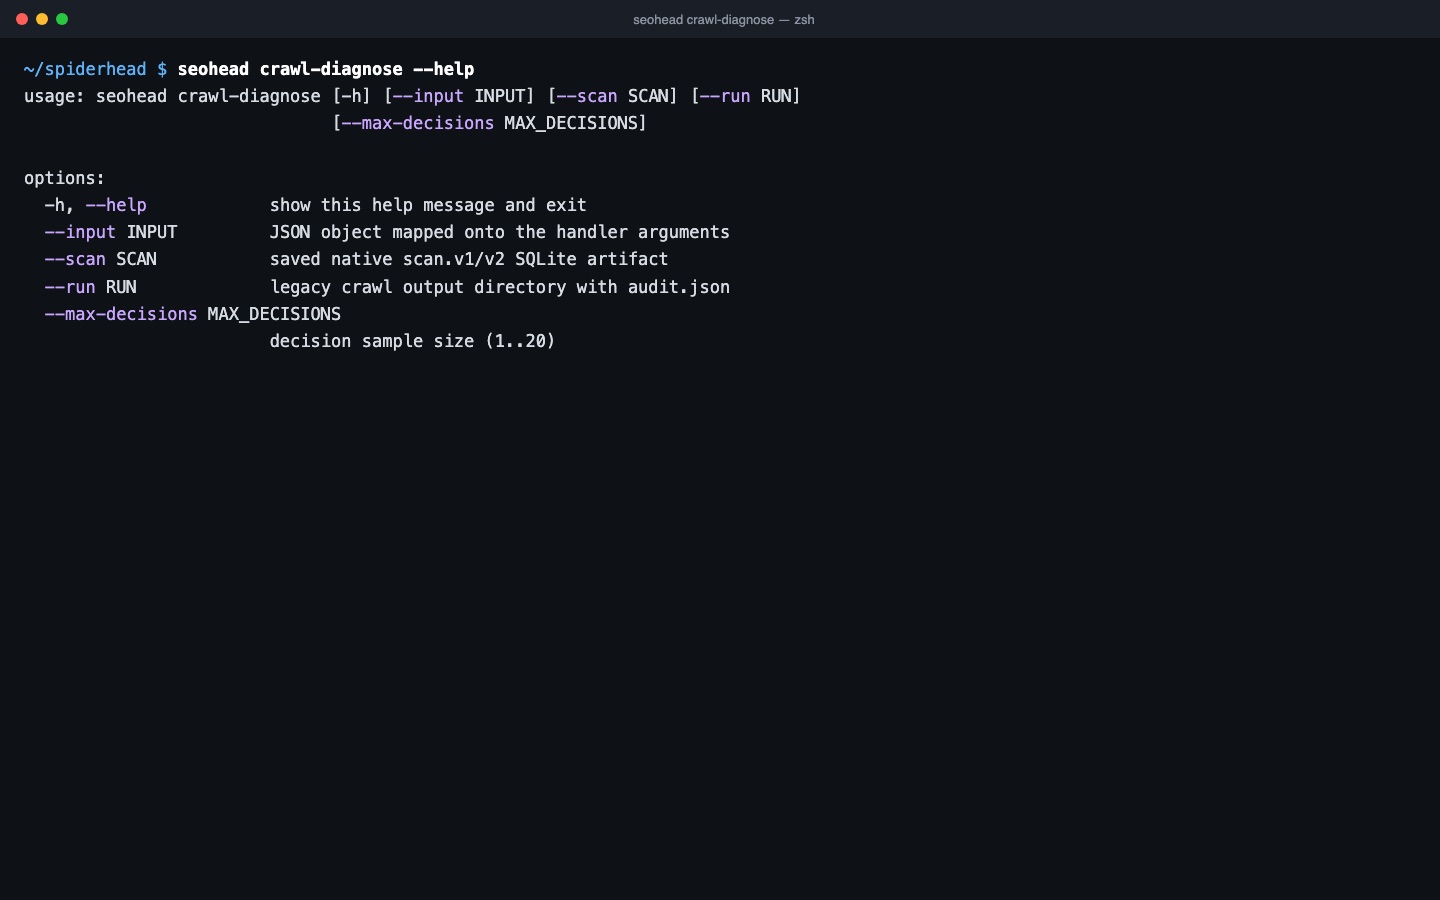
スキャンのパスを指定してcrawl-site --resumeを実行すると、保存されたキューから、保存されたルールのままクロールを再開します。crawl-siteは終了時に、実行が完了したか、途中で止まったか、前回の続きだったかを表示します。crawl-diagnoseはスキャンをオフラインで読み、通信なしで停止の原因を説明します。
SQLiteのスキャンには、キュー、証拠データ、すべての設定が1つのファイルに入っています。書き込みは同じトランザクションで行われるため、停止してもデータが食い違うことはありません。
スキャンのパスを指定してseohead crawl-site --resumeを実行します。開始URLと設定はファイルから読み込むので、同じルールのままクロールを続けられます。
crawl-diagnoseはスキャンをオフラインで読み、キュー、robots、スコープ、上限の状態、コンテンツタイプ、記録された失敗を、通信なしで表示します。
| チェック項目 | 意味 | 重要度 | 根拠 |
|---|---|---|---|
NO_RESPONSE | URLがタイムアウトしたか、DNSの解決に失敗したか、接続を拒否された。配信元の停止はここに現れることが多い | Critical | スキャンに記録されたURLと失敗の種類 |
SERVER_ERROR_5XX | ページが5xxのステータスを返す。たとえば、負荷で配信元が応答しなくなった場合 | Critical | URLとステータスコード |
BROKEN_PAGE_4XX | ページが4xxのステータスを返す。ユーザーにもクローラーにも壊れたページ | Critical | URLとステータスコード |
BLOCKED_BY_ROBOTS | robots.txtがURLをブロックしている。再開前に、意図したブロックか確認する | Important | URLとrobots.txtのルール |
seohead crawl-diagnose --scan ./scans/audit.sqlite先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。