
Crawler SEO locale gratuito

SpiderHead scansiona un sito da una URL di partenza sul tuo computer, segue i link sullo stesso host, rispetta robots.txt e verifica il risultato con gli stessi controlli che usa per gli export di Screaming Frog.

Cosa fa

Scansiona senza progetto

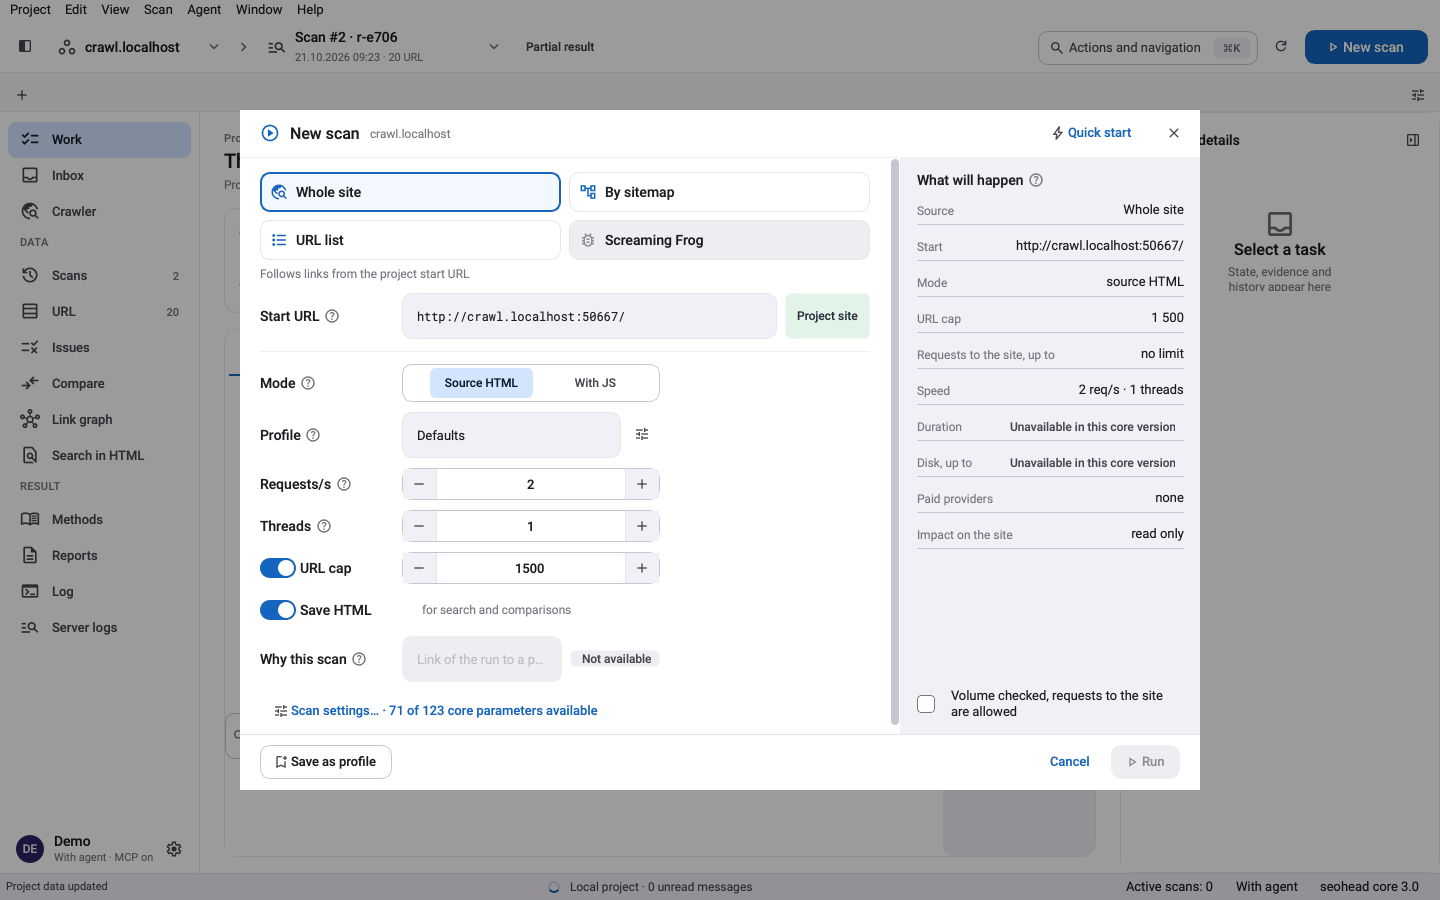
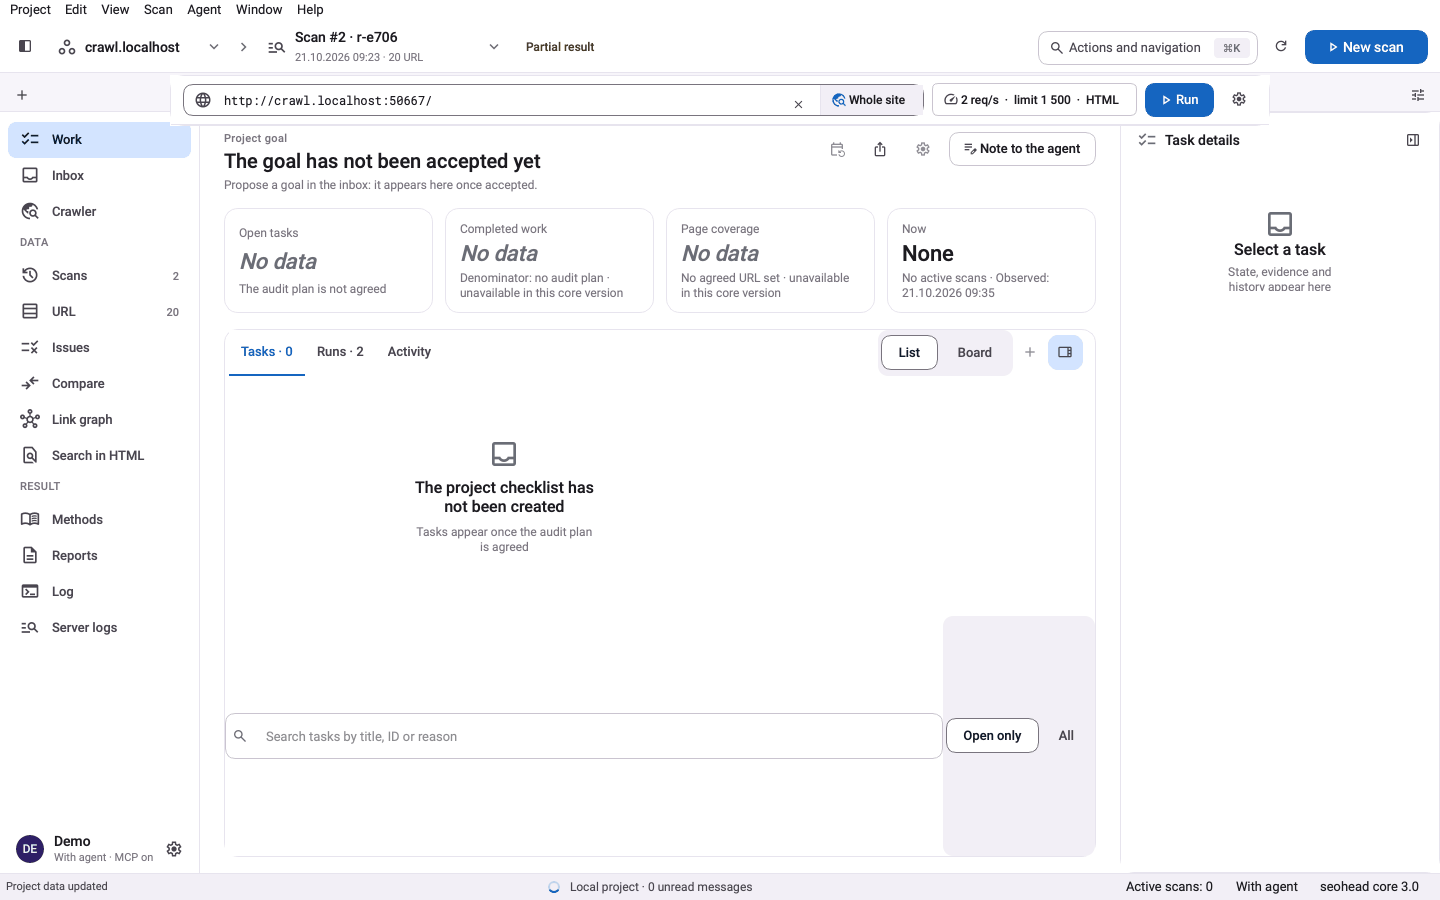
Nell'app desktop inserisci una URL e premi Avvia; il risultato puoi salvarlo come progetto più tardi. Nel terminale, crawl-site segue i link dalla URL di partenza e scrive un'unica scansione nativa in SQLite che puoi riaprire, esportare e rianalizzare offline. La stessa scansione è disponibile per un agente AI attraverso il server MCP locale come seo_crawl_site.

  • Stesso host per impostazione predefinita; i sottodomini sono un'opzione da attivare (scope.internal)
  • robots.txt è rispettato per impostazione predefinita
  • Gratuito e locale: nessun account ospitato e nessuna licenza Screaming Frog

I controlli che non possono girare lo dicono

Una scansione nativa non raccoglie ogni tipo di evidenza. Un controllo che serve dati non raccolti dalla scansione torna skipped con un motivo, mai come falso positivo pulito. Ogni controllo finisce come segnalazione, eseguito senza segnalazioni, skipped o fallito.

  • Quattro esiti per controllo, così un buco non resta mai nascosto
  • I controlli basati sui link, che richiedono una scansione completa, sono trattenuti su una parziale

Tre passaggi, una scansione salvata

  1. Parti da una URL

    Inserisci una URL di partenza nell'app desktop, oppure esegui crawl-site nel terminale. Segue i link sullo stesso host e scrive un'unica scansione nativa in SQLite che puoi riaprire.

  2. Rispettoso per impostazione predefinita

    Circa due richieste al secondo per host, con pause adattive. Il limite di URL lo fissi tu; il predefinito è 200.

  3. Audita le stesse evidenze

    La scansione viene verificata con lo stesso registro da 182 controlli degli export importati. Un controllo che richiede dati non raccoglibili da una scansione nativa è marcato skipped con un motivo, mai pulito.

Controlli di questa funzionalità

ControlloCosa significaGravitàEvidenza
BROKEN_PAGE_4XXLa pagina scansionata restituisce una risposta 4xxCriticalURL e codice di stato
SERVER_ERROR_5XXLa pagina scansionata restituisce una risposta 5xxCriticalURL e codice di stato
NO_RESPONSENessuna risposta: timeout, fallimento DNS o di connessioneCriticalURL e motivo del fallimento
BROKEN_INTERNAL_LINKUn link interno punta a una URL 4xxCriticalPagina di origine e posizione del link
REDIRECT_LOOPLa catena di redirect torna a una URL già visitataCriticalPercorso del loop
REDIRECT_CHAINDue o più hop di redirect prima della URL finaleImportantOgni hop con il suo codice di stato
BLOCKED_BY_ROBOTSrobots.txt blocca la URL, quindi la scansione non l'ha scaricataImportantURL e regola di robots.txt corrispondente

Un solo comando

bash
seohead crawl-site --url https://example.com --max-urls 500 --scan-out ./scans/audit.sqlite

Prima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.

Cosa ti serve

  • Una URL di partenza (o una lista di URL con --urls o --urls-file)
  • Un percorso per il file di scansione (--scan-out) oppure una cartella di progetto
  • Opzionale: un file di configurazione del crawler (JSON); crawl-site --config-help elenca ogni impostazione

Limiti

  • La scansione base legge l'HTML statico; il rendering JavaScript è un extra opzionale
  • Si ferma a 200 URL per impostazione predefinita; alza --max-urls di proposito (fino a 1.000.000)
  • Non sostituisce del tutto Screaming Frog: alcuni controlli tornano skipped
  • Segue i link di un solo host, salvo che tu allarghi l'ambito

Domande

Serve la licenza di Screaming Frog?
No. La scansione nativa gira in locale e non richiede account ospitati né la licenza di Screaming Frog. Gli export di Screaming Frog si possono comunque importare se li hai già.
È un sostituto completo di Screaming Frog?
No, e non pretende di essere alla pari. I controlli che richiedono evidenze non raccolte da una scansione nativa vengono segnalati come skipped, e summary.check_coverage mostra quanta parte del registro è girata.
Rispetta robots.txt?
Sì, per impostazione predefinita. Se robots.txt non può essere scaricato, la scansione si ferma invece di presumere l'accesso (robots.unavailable_means_stop, attivo per impostazione predefinita). Usa --robots report_only per scansionare comunque ed elencare cosa verrebbe bloccato.
Quante URL scansiona?
Il limite predefinito è 200 URL. Imposta --max-urls fino a 1.000.000, oppure 0 per nessun limite di URL, che resta comunque vincolato dalle altre protezioni di risorsa. Le scansioni oltre i budget di progetto richiedono --approve-large-crawl.
Può renderizzare le pagine JavaScript?
Non nella scansione base. Il rendering è opzionale: installa l'extra render e un browser Playwright, poi imposta rendering.mode su js nella configurazione. La scansione base funziona senza browser.