
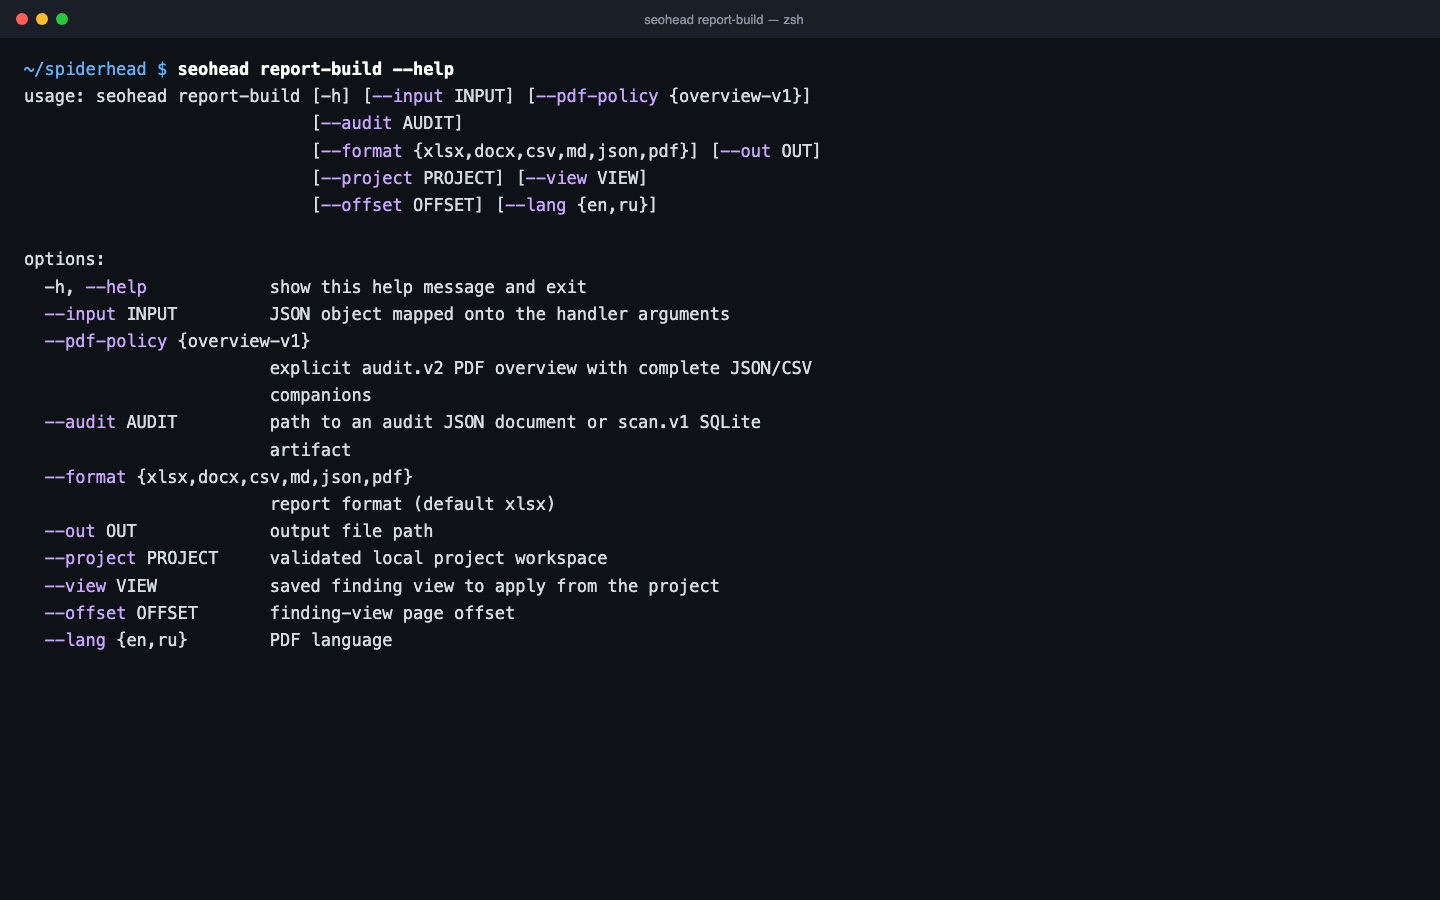
SEOレポート生成:XLSX・DOCX・PDF

report-buildは、保持している証拠データを、XLSX、DOCX、CSV、Markdown、JSON、または上限付きのPDF概要に整形します。整形するだけで、検出結果を作り出すことはありません。

できること

形式

1つの監査から、作業用のスプレッドシート、クライアント向けの文書、機械で読めるJSONを作れます。XLSXには検出結果、ページ、スコープのシートが入り、大きなシートはハッシュ付きの索引とともに分割されます。DOCXの冒頭には、件数と取得不可のチェックを載せたエグゼクティブサマリーがあり、そのあとに証拠データが続きます。独自の結論や推奨は加えません。

  • xlsx:チーム向けの、事実に基づく監査ワークブック
  • docx:クライアントや上長向けの文書
  • csv:検出結果、スコープの証拠データ、ページを別々の表として出力
  • mdとjson:リポジトリや別のエージェント向け

PDF概要

PDFは、件数を絞った閲覧用のビューです。1ページ目に、検出結果とページの総数、表示した件数、省いた件数を記載します。完全なJSON、CSVファイル、ハッシュ付きのマニフェストがすぐ隣に書き出されるので、失われるデータはありません。PDFはChrome、Edge、Chromiumでローカルにレンダリングされ、ネットワークにはアクセスしません。

  • ストリーミング形式のaudit.v2を入力にするには、--pdf-policy overview-v1を明示する必要があります
  • PDFとペアのフォルダは、どちらも新しいパスにします
  • PDFの言語は--lang enまたは--lang ruで選びます

BIパッケージ

多数のサイトやダッシュボード向けには、bi-exportが保存済みのスキャンや監査を、型付きのCSVパーティションと、行数やSHA-256ハッシュを含むバージョン付きのマニフェストに変換します。オフラインで動作します。別のplanコマンドが、Googleにアクセスせずに、Google SheetsやBigQuery向けのパッケージを検証します。出力先への書き込みは、独立した明示的な手順です。

  • bi-sheets-planとbi-bigquery-planは、オフラインで動作し、読み取り専用
  • 不明または取得不可の値はその旨を示し、測定した0は0のまま
  • bi-destination-applyにはホストの承認が必要で、認証情報は受け付けません

3ステップで、スキャンを1件保存

  1. 保持している監査を渡す

    report-buildに、監査JSONまたはscan.v1のSQLiteファイルを指定します。保存済みの証拠データを読み、サイトはクロールしません。

  2. 形式を選ぶ

    xlsx、docx、csv、md、jsonを書き出せます。PDFは件数を絞った概要で、ストリーミング形式の監査には明示的なポリシーが必要です。

  3. 保存したビューを適用する

    --projectと--viewを指定すると、検出結果が上限付きの1ページ分だけ表示されます。合計は監査全体を対象にします。

この機能のチェック項目

チェック項目意味重要度根拠
BROKEN_PAGE_4XXページが4xxのレスポンスを返すCriticalURLとステータスコード
REDIRECT_LOOPリダイレクトチェーンが、すでに通ったURLに戻るCriticalリダイレクトの経路
TITLE_MISSINGtitle要素がないCriticalURL
H1_MISSINGページにH1の見出しがないImportantURL
DESC_MISSINGメタディスクリプションがないImportantURL
CANONICAL_MISSINGインデックス可能なページに正規URLがないImportantURL
REDIRECT_CHAINリダイレクトチェーンが2ホップ以上あるImportant順に並べたホップ
URL_NOT_IN_SITEMAPインデックス可能なページがサイトマップにないTipURL

コマンド1つで実行

bash
seohead report-build --audit ./scans/audit.sqlite --format xlsx --out audit.xlsx

先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。

必要なもの

  • 保存済みの監査JSON、またはネイティブのスキャン(scan.v1のSQLiteファイル)
  • --outで指定する出力パスと、--formatで指定する形式
  • XLSXとDOCXには、reportsの追加パッケージ(openpyxl、python-docx)
  • PDFのみ、ローカルにインストールしたChrome、Edge、またはChromium

制限事項

  • 整形するのは保存済みの監査です。クロールも再チェックも、検出結果の追加も行いません
  • PDFは概要で、全件の一覧ではありません。完全なデータは、ペアで出力されるJSONとCSVにあります
  • --projectと--viewを指定すると、検出結果は上限付きの1ページ分だけが表示されます。合計は監査全体を対象にします
  • CSVはフラットなエクスポートで、グループ化したタスクリストではありません。タスクが必要な場合は、タスクリストを使ってください

よくある質問

report-buildはサイトをクロールしますか?
いいえ。すでに作成済みの監査を、監査JSONまたはscan.v1のSQLiteファイルから整形するだけです。先にsite-audit、crawl-site、またはSF runを実行してください。
監査に記録されていない検出結果を追加できますか?
いいえ。証拠データを整形するだけで、検出結果を作り出すことはありません。レポートには、スキップされたチェックや取得不可のチェックも含め、監査に保存された内容が表示されます。
PDFは作れますか?
はい。完全なJSONとCSVをペアで出力する、件数を絞った概要として作れます。ストリーミング形式のaudit.v2を入力にするには、--pdf-policy overview-v1が必要です。PDFにはローカルのChrome、Edge、またはChromiumが必要です。言語は--lang enまたはruで選びます。
長いレポートが、巨大な1枚のシートになりますか?
いいえ。XLSXは、大きなFindingsシートとPagesシートを分割し、ハッシュ付きの索引を書き出します。
クライアントには、どの形式を送ればよいですか?
DOCXは読みやすい文書、XLSXは行を絞り込みたい人向けのワークブックです。どちらも、同じ保存済みの証拠データを示します。送る前に、どちらのファイルも内容を確認してください。
キーは必要ですか?費用はかかりますか?
いいえ。report-buildはオフラインで動作し、プロバイダーを使いません。書き出すのは、--outで指定したファイルと、PDFの場合のペアのフォルダだけです。

他の機能も見る