
Screaming Frogエクスポート分析

Screaming FrogのCSVまたはXLSXエクスポートのフォルダをSpiderHeadに渡すと、監査と優先度付きのタスクリストが得られます。既定の実行はオフラインで、Screaming Frogのインストールもライセンスも、サイトへのリクエストも不要です。

できること

2つのモード

モードBは、Screaming Frogで作成済みのエクスポートを分析します。ディスク上のファイルを読むだけで、ライセンスは不要です。モードAは、別途インストールしたライセンス付きのScreaming Frog CLIを動かしてクロールさせ、その結果を分析します。

  • モードB:sf runに--exports-dirを指定。完全にオフラインで動作します。
  • モードA:--crawl URL、--crawl-list FILE、または--load-crawl FILE.seospider。Screaming Frogのライセンスは各自でご用意ください。
  • 開始前に、sf doctorでローカルの環境を確認できます。

得られるもの

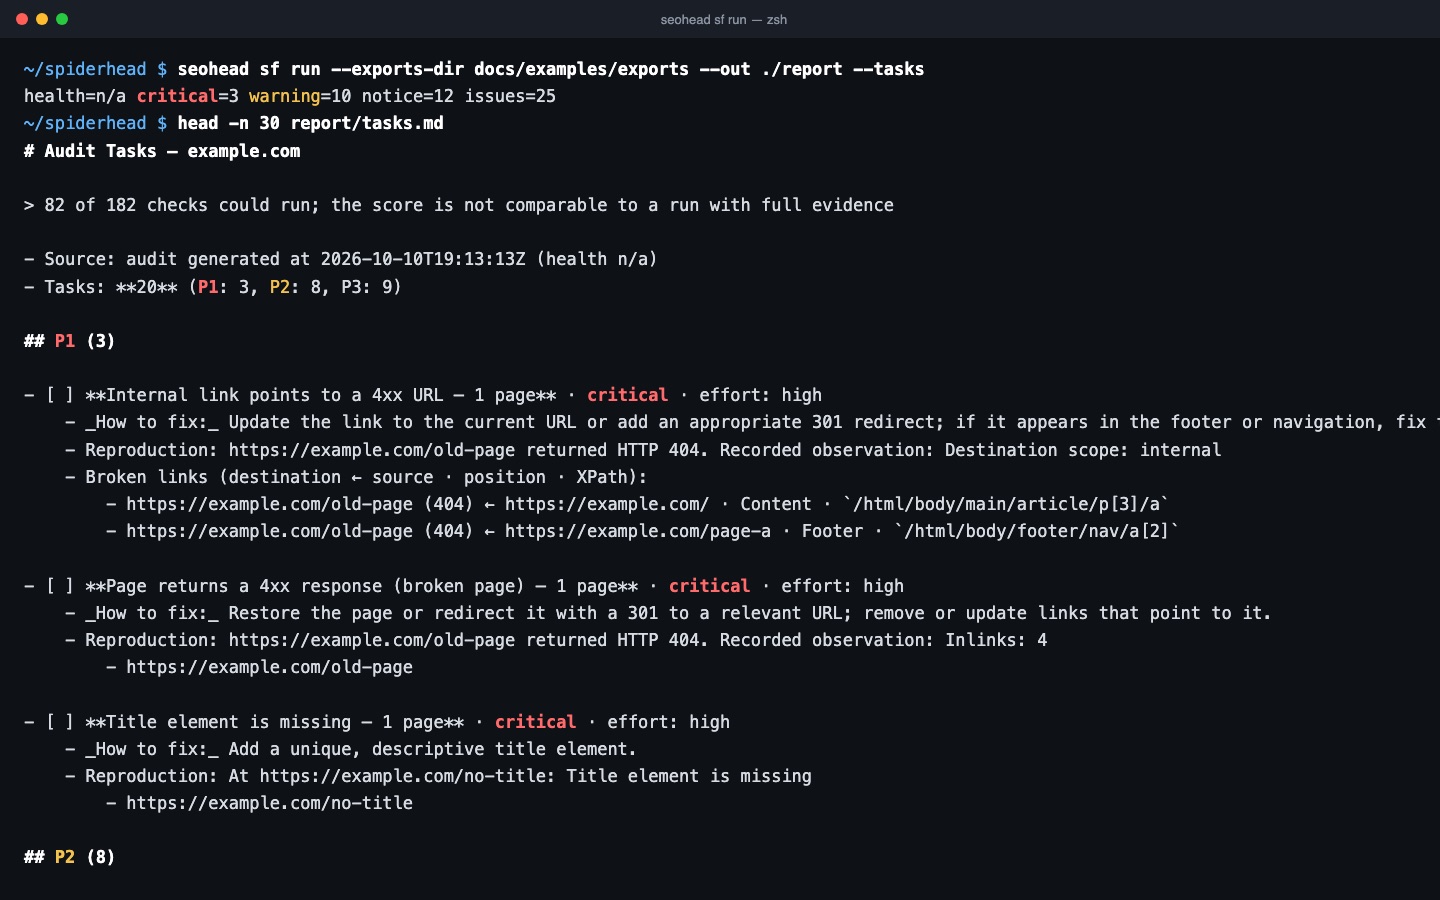
レポートフォルダには、audit.jsonとaudit.mdが入ります。--tasksを付けると、優先度付きのタスクリストであるtasks.jsonとtasks.mdも作られます。各タスクには、再現手順、ページ内でのリンク位置、修正案が載ります。

  • --format json,mdでレポート形式を選べます。
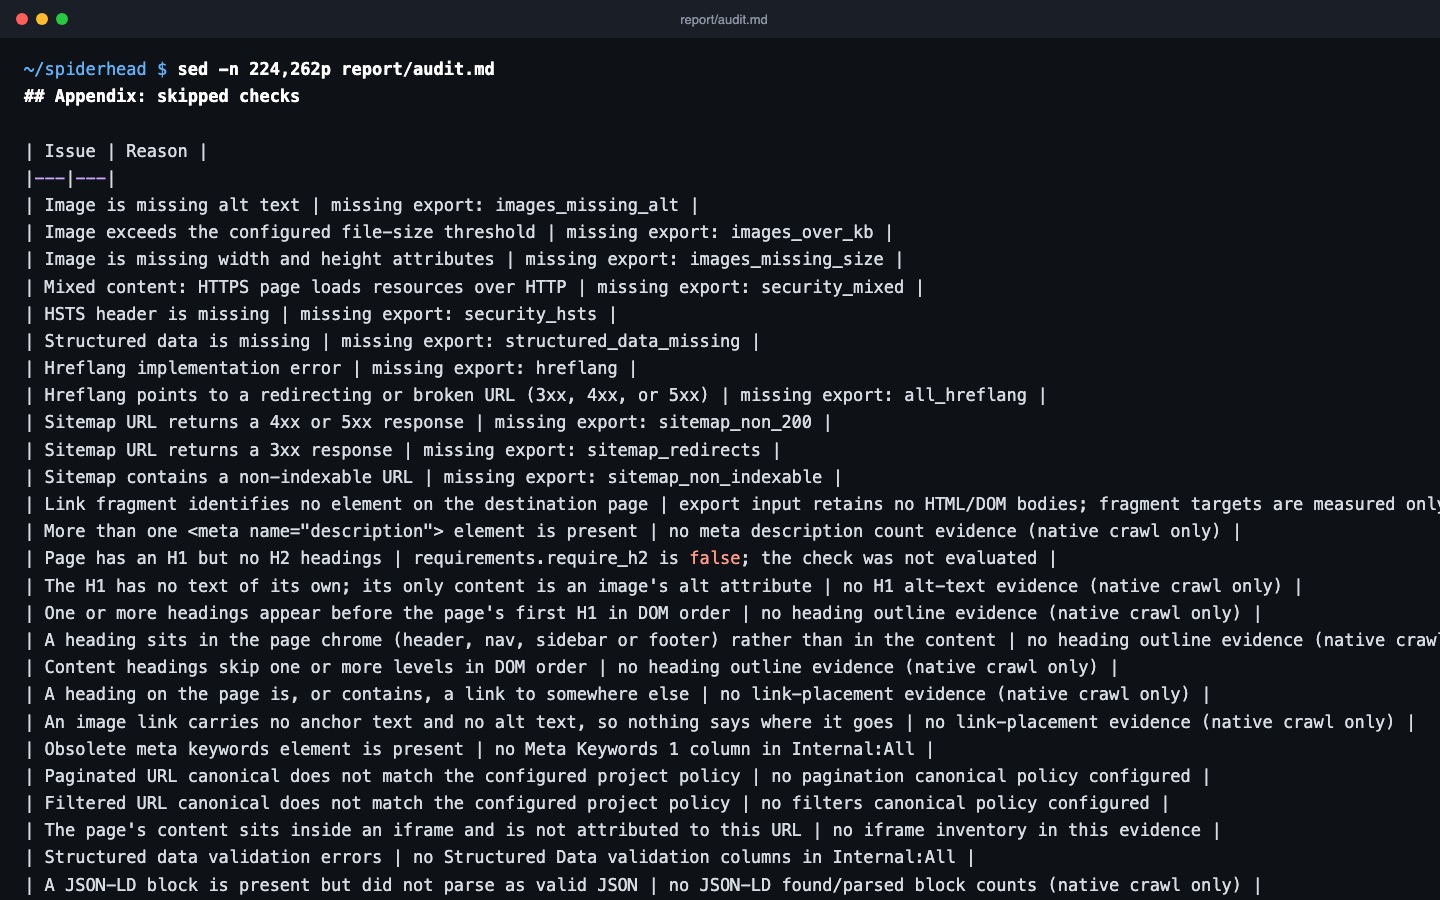
  • エクスポートがないチェックは、理由付きでスキップとして扱い、合格には数えません。
  • --fail-on criticalまたはwarningを指定すると、CI向けに終了コードが0以外になります。

検索データとトラフィックデータの追加

--project DIRを指定すると、sf runはそのプロジェクトに保存された、直近の完全な28日分のSearch Console、GA4、Metrikaの履歴を、監査対象のページに結び付けます。この間、どのプロバイダーにもアクセスしません。別途オプトインで使う--gsc-inspectは、最大50件のURLのサンプルについて、Googleのインデックス状況を読み取ります。

  • プロバイダー由来の検出結果は、audit.jsonとaudit.mdに取得元が残ります。
  • 紐付けのないデータや、件数上限で打ち切られた読み取りは、取得不可または一部のみとして扱います。
  • 孤立ページのような否定的な検出結果には、プロバイダーのデータとクロールの両方が完全であることが必要です。

3ステップで、スキャンを1件保存

  1. エクスポートを指定する

    Screaming FrogのCSVまたはXLSXエクスポートのフォルダを渡します。分析はオフラインで動作し、サイトへのリクエストは送りません。

  2. チェックのレジストリを実行する

    すべてのエクスポートを同じレジストリで評価します。データがないチェックは、理由付きでスキップとして扱い、合格には数えません。

  3. 優先度付きのタスクリストを得る

    audit.json、audit.md、tasks.md/tasks.jsonに、各問題の再現手順、リンク位置、修正案が載ります。

この機能のチェック項目

チェック項目意味重要度根拠
BROKEN_PAGE_4XXページが4xxのレスポンスを返すCriticalResponse Codesの4xxエクスポート
BROKEN_INTERNAL_LINK内部リンクが4xxのURLを指しているCriticalInlinksエクスポート:リンク元ページとリンク位置
REDIRECT_LOOPリダイレクトチェーンが、すでに通ったURLに戻るCriticalRedirect Chainsレポート
TITLE_MISSINGページにtitle要素がないCriticalページタイトルのデータから算出
REDIRECT_CHAIN最終URLに着くまでに2ホップ以上のリダイレクトがあるImportantRedirect Chainsレポート
DESC_DUPLICATE複数のページで同じメタディスクリプションが使われているImportantメタディスクリプションのデータから算出
TITLE_TOO_LONGtitleが設定した文字数のしきい値を超えているTipページタイトルのデータから算出

コマンド1つで実行

bash
seohead sf run --exports-dir ./exports --out ./report --tasks

先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。

必要なもの

  • Screaming FrogのCSVまたはXLSXエクスポートのフォルダ(--exports-dir)
  • 任意:しきい値を指定するconfig.json(--config)
  • モードAのみ:ライセンスのあるScreaming Frog CLIと、開始URL、URLリスト、または保存済みの.seospiderファイル

制限事項

  • 監査で見られるのは、エクスポートに含まれる内容だけです。対応するエクスポートがないチェックはスキップされます。
  • モードAにはScreaming Frogのライセンスが必要です。SpiderHeadはライセンスを提供も同梱もしません。
  • サイトマップとrobotsのデータをネットワークで再チェックするのは、--live-recheckを指定した場合だけです。
  • 提案した修正は、サイトには適用されません。

よくある質問

使うにはScreaming Frogのインストールが必要ですか?
分析だけなら不要です。モードBは、Screaming Frogで作成済みのエクスポートを読み、サイトにはリクエストを送りません。Screaming Frogとそのライセンスが必要なのは、SpiderHeadがScreaming Frog CLIを動かしてクロールするモードAだけです。SpiderHead自体には、キーもアカウントも不要です。
データがないチェックはどう扱われますか?
理由付きでスキップとして扱います。問題なしの合格として報告されることはないので、問題が0件なら、そのチェックは実行されています。
サイトやファイルに変更を加えますか?
いいえ。エクスポートを読み、指定した出力フォルダにレポートを書き出すだけです。提案した修正を適用するのは、ご自身です。
audit.mdとtasks.mdの違いは何ですか?
audit.mdは検出結果の一覧です。tasks.mdは優先度付きのタスクリストで、問題ごとに再現手順、リンク位置、修正案が載ります。得るには--tasksを指定します。
CIで使えますか?
はい。--fail-on critical(またはwarning)を指定すると、その重要度の問題があるときにコマンドが0以外の終了コードを返します。
ほかのクローラーのエクスポートも分析できますか?
sf runはScreaming Frogのエクスポートが前提なので、できません。ほかのツールには、マニフェストで対応付けたCSVバンドルを読み込むcrawl-importがあります。出力は監査ではなく、別形式のサードパーティ製クロールのドキュメントです。