
推測ではなく証拠
検出結果ごとに、URL、観測した内容、修正方法を示します。リンクに関する検出結果では、ページ内のどこにリンクがあるかも表示します。実行に必要なデータがないチェックは、合格ではなく、理由つきのスキップとして報告します。
- 重要度のレベル:critical、warning、notice
- リンクに関する検出結果には、リンクの位置とXPathを表示(Screaming FrogのInlinksエクスポートから取得)
- すべての検出結果に、レジストリ由来の修正案を添付
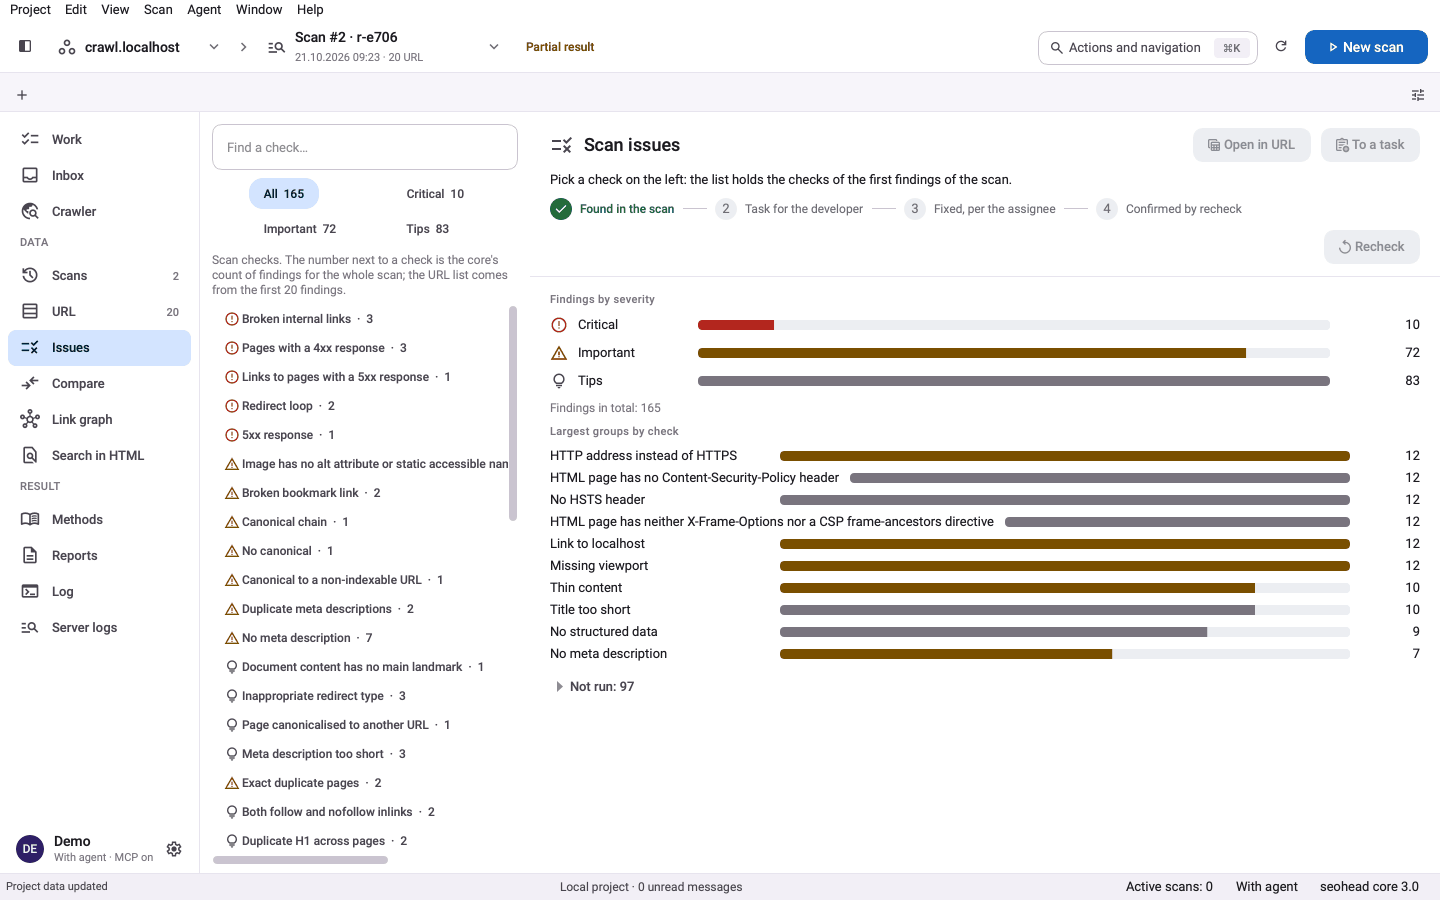
検出結果ごとに、URL、観測した内容、修正方法を示します。リンクに関する検出結果では、ページ内のどこにリンクがあるかも表示します。実行に必要なデータがないチェックは、合格ではなく、理由つきのスキップとして報告します。
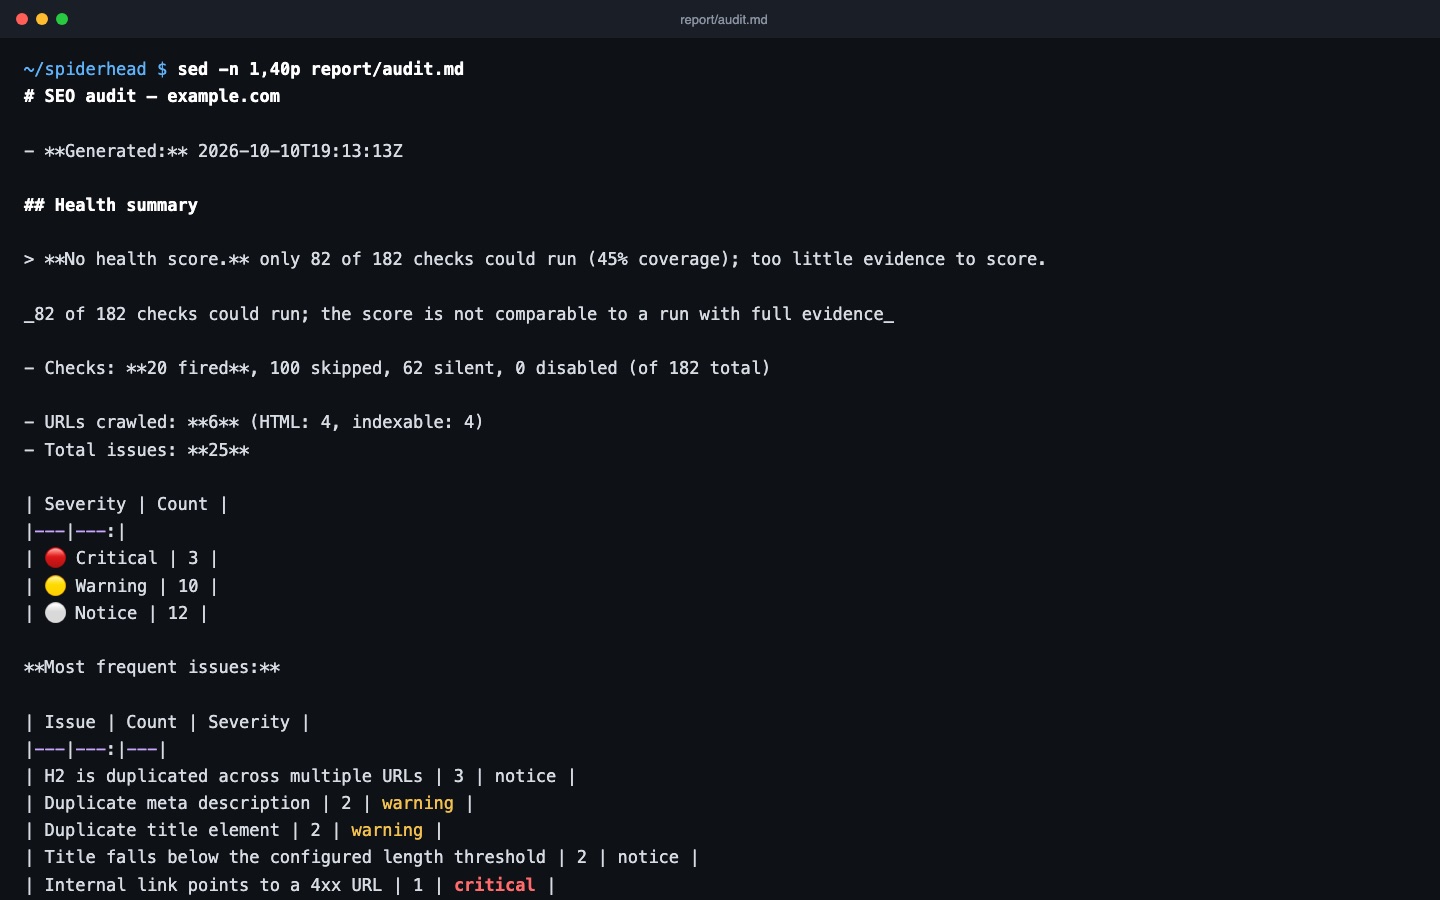
レポートには、渡された証拠でいくつのチェックを実行できたかが表示されます。カバレッジが半分未満のときは、健全性スコアを表示しません。カバレッジが低いスコアには、証拠が十分にそろった実行とは比較できないという印が付きます。
tasksフラグを付けると、監査はtasks.jsonとtasks.mdも書き出します。検出結果ごとに修正方法を添えた、開発者向けの優先順位つきリストです。同じ監査で、指定した重要度の検出結果があればCIのビルドを失敗させることもできます。
Screaming FrogのCSVまたはXLSXのエクスポートを入れたフォルダを指定します。証拠をどの方法で集めても、すべてのチェックが同じレジストリを参照します。
各チェックの結果は、検出結果あり、問題なし、または必要なデータがないための理由つきスキップのいずれかです。
--tasksを付けると、tasks.jsonとtasks.mdが出力されます。検出結果ごとに修正方法を添えた、開発者向けの優先順位つきタスクリストです。
| チェック項目 | 意味 | 重要度 | 根拠 |
|---|---|---|---|
BROKEN_PAGE_4XX | ページが4xxのステータスを返す | Critical | Response Codes 4xxのエクスポート、URLとステータス |
SERVER_ERROR_5XX | ページが5xxのステータスを返す | Critical | Response Codes 5xxのエクスポート、URLとステータス |
TITLE_MISSING | ページにtitle要素がない | Critical | ページのURL |
BROKEN_INTERNAL_LINK | 内部リンクが4xxのURLを指している | Critical | Inlinksエクスポートのリンク元ページとリンクの位置 |
H1_MISSING | ページにH1の見出しがない | Important | ページのURL |
CANONICAL_MISSING | インデックス可能なページにcanonical URLがない | Important | ページのURL |
THIN_CONTENT | ページの単語数が少ない | Important | URLと単語数 |
HEADING_BEFORE_H1 | ページ最初のH1より前に見出しがある | Tip | ページの見出し構造 |
seohead sf run --exports-dir ./exports --out ./report --tasks先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。