
内部リンクグラフの可視化

保存したスキャンから、内部リンクグラフを読み取ります。ノード、エッジ、孤立ページ、ページへの最短経路、そのページへのリンクが分かります。デスクトップアプリで表示でき、CLIとMCPは監査と同じスキャンを読みます。

できること

スキャン全体のグラフ

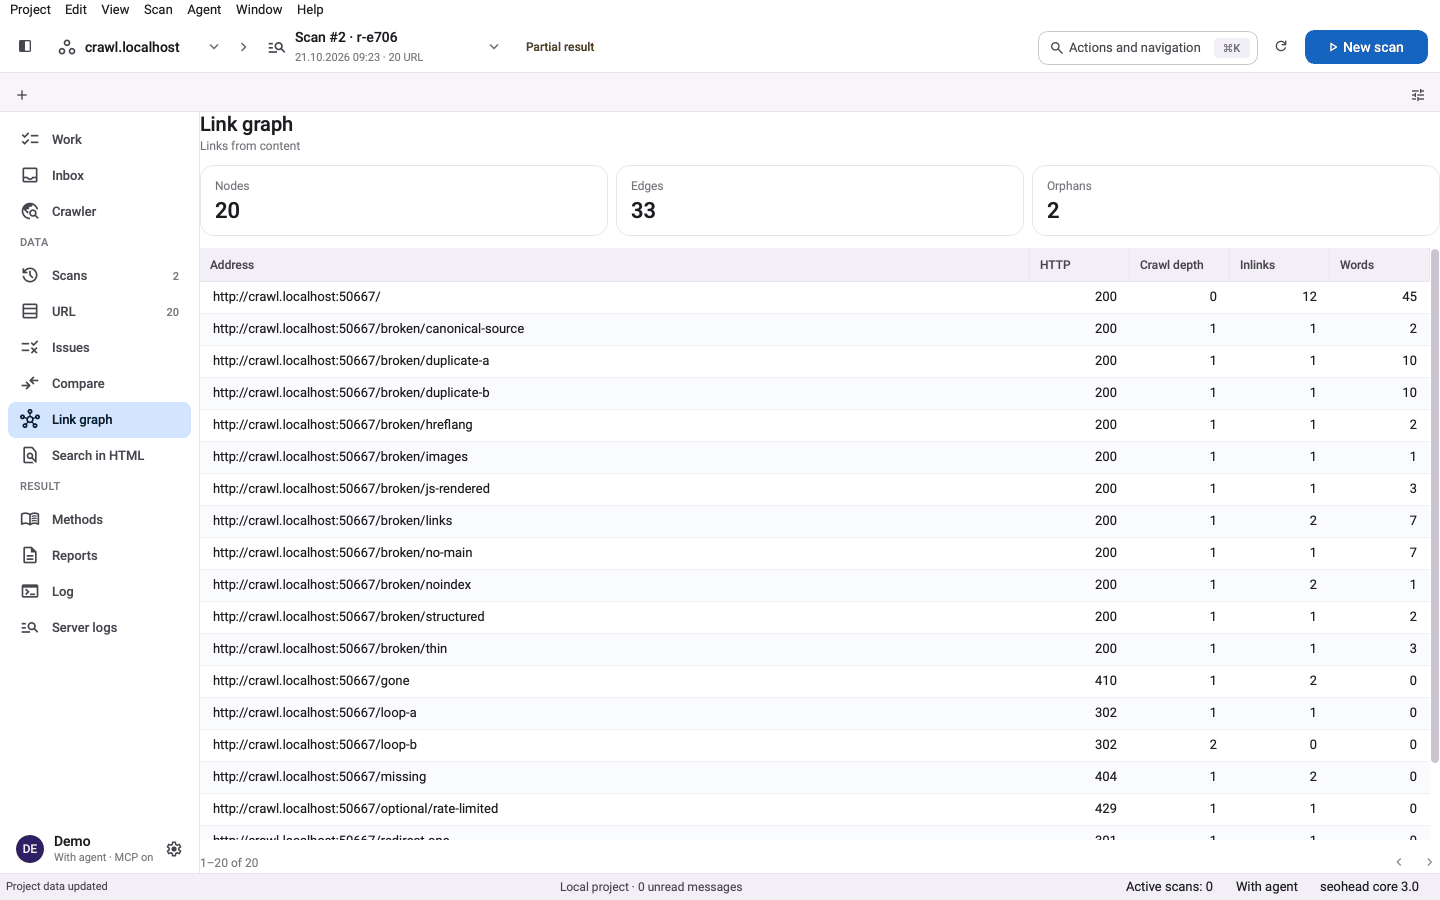
scan-graphは、保存済みのスキャンに残っている内部リンクを、ネットワークへのリクエストなしで読み取ります。ノード、エッジ、孤立ページを報告し、大きなサイトはセクションごとにまとめられます。デスクトップのリンクグラフ画面にも同じカウンターが表示され、URLごとのHTTPステータス、クロール深度、被リンク数、語数がページ送り付きの表で見られます。

  • リンク位置(nav、header、sidebar、footer、content、other)またはセクションで絞り込み
  • グラフが大きすぎて一覧にできない場合は、セクションごとに集計
  • 2つのスキャンを比べて、追加・削除されたリンクと新しい孤立ページを確認

ローカルグラフ

1ページに絞ると、その周辺のページが分かります。デスクトップのURLカードのグラフタブでは、保存済みのスキャンから、選択したURLの周囲のリンクを1〜3階層まで描画します。スキャンにないリンクは描画されません。CLIでは、scan-graphに--aroundと--depthを付けると、同じ周辺情報をデータで取得できます。

  • 深度は3階層までで、描画のサイズにも上限がある
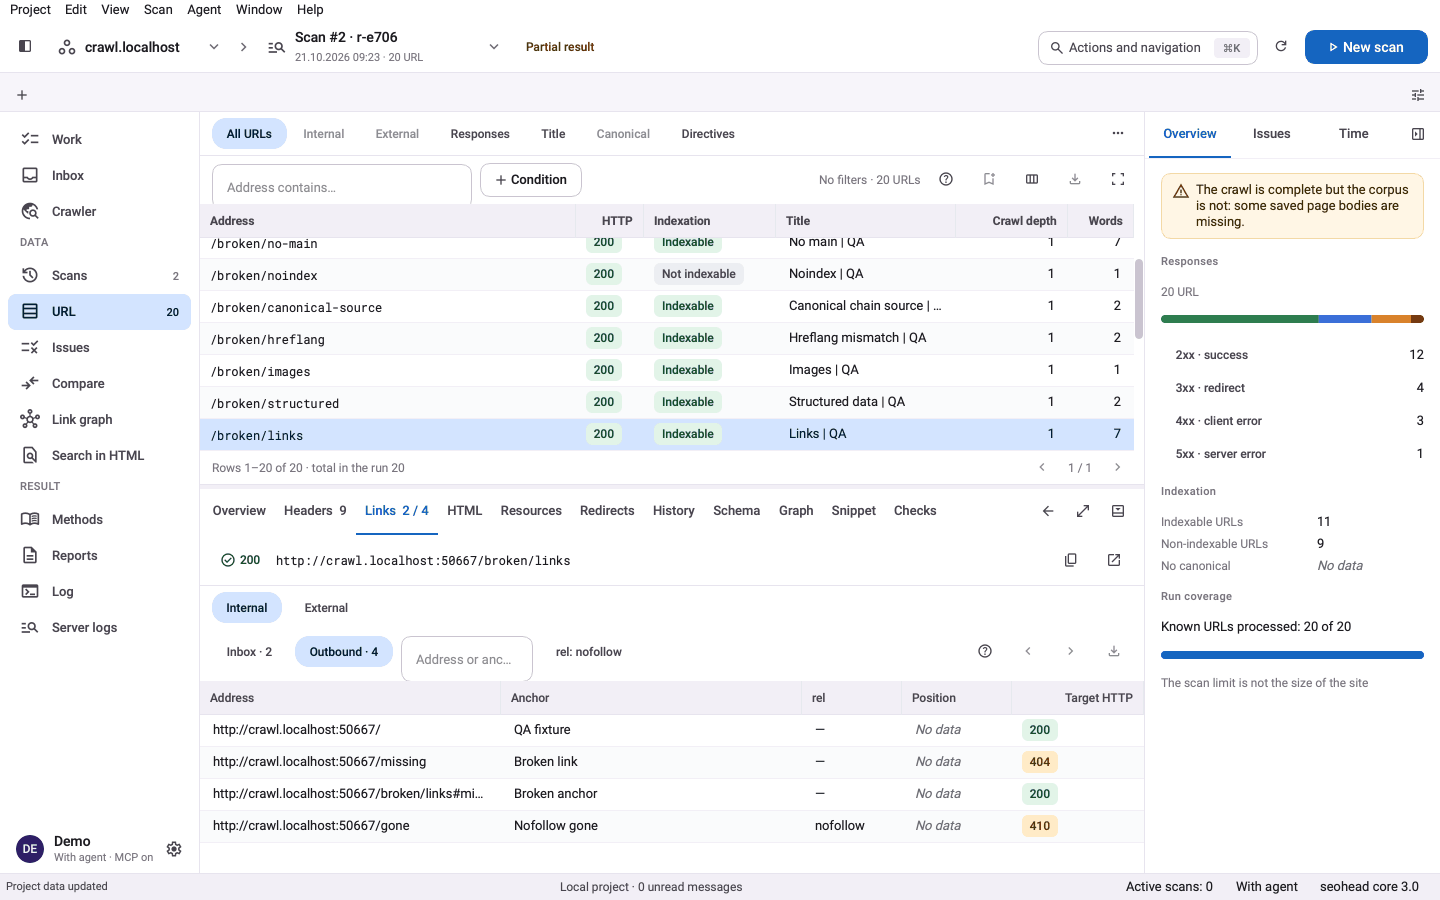
  • ページから出るリンクと入るリンクを一覧にできる
  • 読み取り専用:プロジェクトにもサイトにも何も書き込まない

経路と被リンク

scan-link-inspectは、グラフを見て出てくる疑問に答えます。開始URLからページまでの最短経路(確認できたもの)、そのページにリンクしているページ、各リンクの位置を返します。リンクは、followの種類、ステータスの区分、内部か外部かで絞り込めます。

  • ビュー:経路、被リンク、コンテキスト、ページ送り付きのリンク一覧
  • 内部リンクの被リンクと、内部リンク先のリンク切れ用のプリセット
  • nofollow、sponsored、ugcのリンクは、followのリンクとは分けて扱う

3ステップで、スキャンを1件保存

  1. サイトを1回クロールする

    crawl-siteは同じホスト内のリンクを辿り、各内部リンクをアンカーと位置つきで記録した、SQLiteのスキャンを1つ保存します。

  2. 保存したスキャンからグラフを調べる

    scan link-inspectは、サイトに再アクセスせずに、ページへの最短経路、そのページへのリンク、または1つのURLにあるリンクを読み取ります。

  3. グラフで分かった問題を直す

    孤立ページ、深い階層のページ、内部のリンク切れは監査の検出結果になり、それぞれに修正方法が添えられます。

この機能のチェック項目

チェック項目意味重要度根拠
ORPHAN_PAGEページへの内部リンクがなく、ユーザーもクローラーも、URLの直接指定かサイトマップからしかたどり着けない。ImportantページのURLと、被リンク数が0であること
DEEP_CLICK_DEPTHクロールの開始URLからのクリック数が、設定した下限を超えている。Importantクリック深度と開始URL
DEEP_DISCOVERY_PATH開始ページからの最短のハイパーリンク経路が、設定した深度より長い。Tip開始ページからの最短経路
LOW_LINK_SCOREページの内部リンクスコアが、サイトの中央値を大きく下回っている。Tipページのスコアとサイトの中央値
ONLY_NOFOLLOW_INLINKSページへの内部リンクがすべてnofollowで、リンク評価が届かない。Important被リンクとそのrel属性の値
BROKEN_INTERNAL_LINK内部リンクのリンク先が4xxを返している。Criticalリンク元のページ、リンク位置とアンカー、リンク先のステータス
DUPLICATE_INTERNAL_LINK同じリンク先に同じアンカーのリンクが、1ページ内に複数ある。Tip重複したリンク先、アンカー、件数

コマンド1つで実行

bash
seohead-desktop --project ./shop

先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。

必要なもの

  • 保存済みのスキャン:crawl-siteで作成したscan.v1のSQLiteファイル、またはデスクトップアプリで開いているスキャン
  • そのスキャンに保持されているリンク(古いスキャンでリンク位置を取得するには、scan-reanalyzeが必要な場合があります)
  • 経路の検索用の開始URLと、ローカルグラフ用のページURL

制限事項

  • 表示するのはクロールで確認できたリンクです。検索エンジンがそれをどう評価するかは分かりません
  • 一部だけのクロールでは、孤立ページの数は確認できたグラフ内で到達できないページを指します。サイト全体のことではありません
  • ページ本文を保持していない場合、リンク位置はnot_classifiedのままになります
  • デスクトップの概要は、カウンター付きの表です。グラフが描画されるのは、1つのURLを中心にしたローカルグラフだけです

よくある質問

リンクグラフを使うのにScreaming Frogは必要ですか?
いいえ。グラフが読み取るのは、crawl-siteが書き出した保存済みスキャンで、監査と同じものです。Screaming Frogのエクスポートは、任意の入力です。
グラフを使うとサイトに変更が加わりますか?
いいえ。読み取るのは保存済みのスキャンファイルだけです。サイトには何も書き込まず、チェックもクロールで見つかったことを報告するだけです。
サイトマップにあるページが、孤立ページとして検出されたのはなぜですか?
ORPHAN_PAGEは、そのページへの内部リンクがないことを意味します。SITEMAP_ORPHANは、同じ問題のサイトマップ版です。関連するページからリンクを追加するか、サイトマップからそのURLを削除します。
クロールが一部だけだった場合はどうなりますか?
一部だけのクロールでは、サイト全体についての結論を出しません。孤立ページと連結成分の数には対象範囲が明記され、経路や被リンク一覧が欠けている場合は、一部のみ、または利用不可と表示されます。問題なしとして表示されることはありません。
デスクトップアプリなしでもグラフを使えますか?
はい。scan-graphとscan-link-inspectはCLIのコマンドであり、MCPのツールでもあります。スクリプトやエージェントが、同じグラフをJSONで読み取れます。
どのくらい大きなグラフを読み取れますか?
読み取りには上限があります。1回の呼び出しで読むノード数とエッジ数には厳密な上限があり、それを超える大きなサイトはセクションごとに集計され、切り詰めた内容も結果で報告されます。