Yandex Wordstat
collect · synonymsYandex Cloud APIによる基本頻度、絞り込み、関連クエリ。APIキーとフォルダーIDが必要で、1時間あたりのクォータがあります。
プロジェクトごとにキーワードプールを収集、クリーニング、クラスタリング、拡大します。Yandex Wordstatの需要、SERPクラスター、完全一致頻度、競合マイニングに対応し、有料の呼び出しの前にオフラインでプランを確認できます。
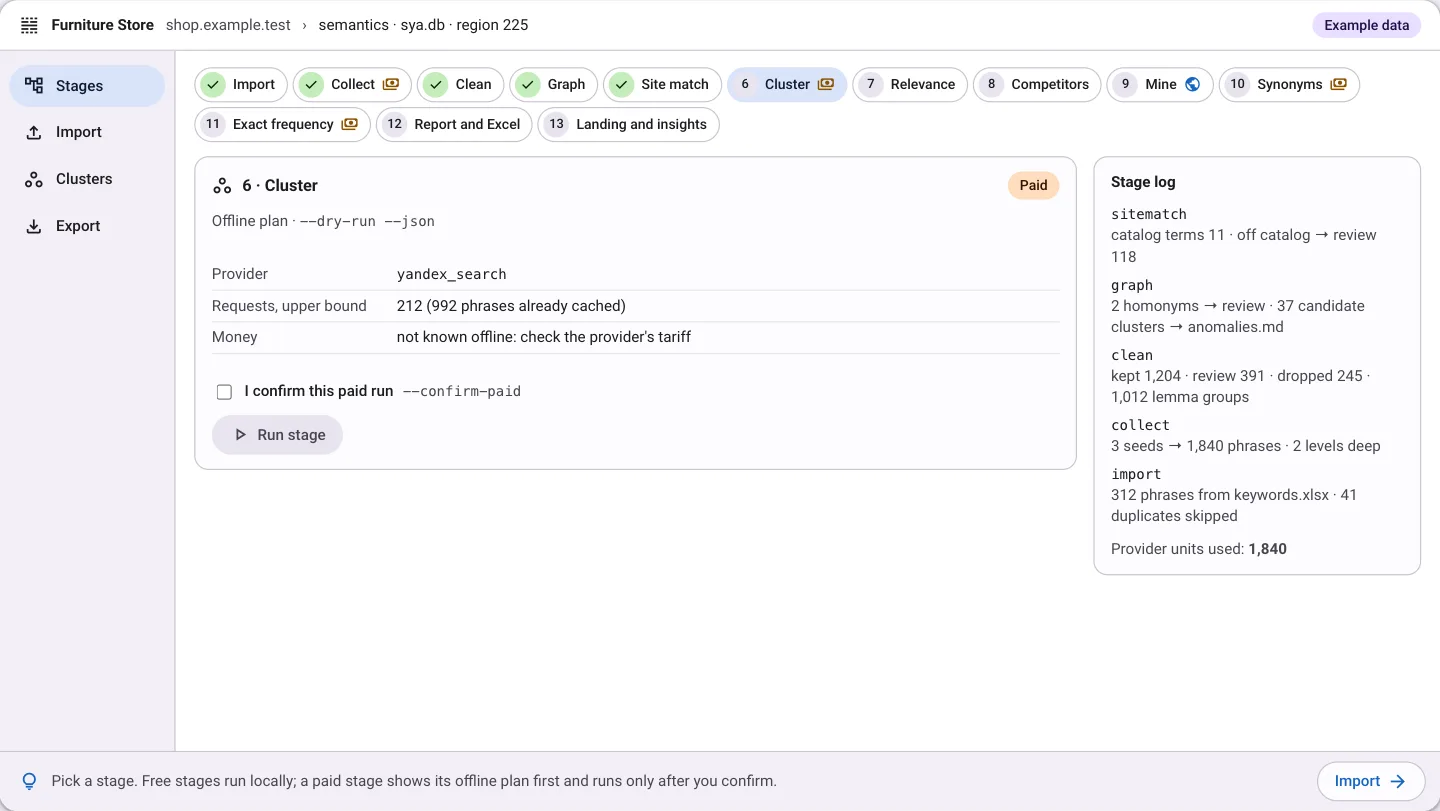
各ステージはステータスを変更して理由を記録するため、フレーズが削除されることはなく、すべての判断を説明できます。無料のステージを有料のステージの間に挟むので、次の回答を購入する前にプールを確認できます。
手元にあるデータを取り込みます。CSVまたはXLSXの1シートが対象です。query、frequency、group、subgroup、URL、commentを対応付け、add、update、replaceのいずれかで反映します。プレビューでは、書き込む前に新規、既存、重複の行を確認できます。
phrases地域ごとにシードを展開し、頻度の高いフレーズを指定した深さまで再展開します。キューは重複排除され、--resumeで中断した実行を、同じフレーズを再度取得せずに続けられます。
phrases, expansions, provenanceプロジェクトのフィルター(意図、ストップワード、情報系パターン)を適用し、頻度の外れ値にフラグを付け、フレーズをレンマ単位でグループ化します。インプレッションや順位が観測されているフレーズは、頻度のルールで除外されません。
status, route, lemma groupプールの単語グラフを作成します。同音異義語の候補はレビューに回り、候補クラスターはanomalies.mdに出力されます。追加の支払いより前の段階です。
anomalies.mdフレーズは、サイトが扱っている場合にのみコアに入ります。catalog.txtの語を1つも含まないフレーズは、カタログ外としてレビューに回ります。
review listフレーズごとに上位10件を1回取得してキャッシュするため、再実行では新しいフレーズ分だけ課金されます。ページを共有するフレーズが1つのクラスターになります。--method louvainはキャッシュ済みの結果を再グループ化し、長い連鎖を断ち切ります。
SERP cache, clusters, landing candidatesフレーズの上位10件に、vendors.txtにある同種のサイトが1つも出ない場合、そのトピックは対象外の可能性が高いです。フレーズはレビューに回り、削除はされません。
review listキャッシュ済みの結果を読み取り、どのドメインがクラスターを占めているか、タイトルでどんな語を使っているかを調べます。候補はsynonyms.txtに入ります。
competitors.md, synonyms.txt収集した結果から最も頻出する競合ページを開き、title、description、H1、最初のH2見出しを読み取ります。トピックに合う2語・3語のフレーズはsynonyms.txtに入ります。
competitor_mining.md, synonyms.txtsynonyms.txtの候補を確認します。需要のあるフレーズだけがコアに加わり、その後collect --resumeでそこからプールを拡大します。
checked phrases完全一致の!W頻度を、プールが変化しなくなった最後の段階で、レンマグループごとに1回購入します。プロジェクトの予算ゲートを超える場合は--yesが必要です。
exact frequency, task receipts読み取り用にreport.mdとclusters.csv、クライアント向けにXLSXブック(Summary、Core、Info、Clusters、Rejected)、他のツール向けにpool.csvとpool.jsonを出力します。
report.md, XLSX, CSV, JSON公開後、計測済みの候補から各クラスターのランディングページを選びます。ローカルのSearch Console、Webmaster、Metrikaのデータから週次のクラスターシグナルを読み取り、選んだものをチェックリストのタスクにします。
landing, weekly signals, tasksコアは一度で集め終わるものではありません。競合とマイニングが新しい候補を供給し、類義語で確認し、収集を再開して、クラスタリングをもう一度実行します。完全一致頻度は最後に購入します。
collectclean · graph · site matchclustercompetitors · minesynonymscollect --resumeexact, oncereport収集パイプラインはYandexのデータで動作します。Googleの需要、順位追跡、検索アナリティクスは、コアと並行して使う別のツールキットコマンドです。
collect · synonymsYandex Cloud APIによる基本頻度、絞り込み、関連クエリ。APIキーとフォルダーIDが必要で、1時間あたりのクォータがあります。
clusterフレーズと地域ごとに上位10件を、取得時刻と地域つきでキャッシュします。非同期エンドポイントのみ対応です。
exactWordstat APIでは得られない完全一致の!W頻度。課金はタスク作成時で、task_idを保持するため、タイムアウトした結果は再購入ではなく再取得になります。
google-keywordsGoogleの検索ボリューム、競合性、シードの展開。デフォルトはサンドボックスです。
keywords-expand · keywords-seasonality · regions-tree1つのフレーズの展開、月ごとの需要の確認、地域ツリーの閲覧(地域ツリーは無料)。
topvisor-read既存のアカウントから、プロジェクト、キーワード、記録済みの順位履歴を読み取ります。有料のチェックはツールキットから起動できません。
semantics insightsツールキットがローカルに同期済みのデータから、クラスターごとの週次シグナルを作成します。インサイトの処理自体はプロバイダーを呼び出しません。
有料のステージにはすべてオフラインのプランがあり、地域、エンジン、クエリの取得元、リクエストまたはタスク数の上限を示します。プランがプロバイダークライアントを作成することはありません。
--dry-run --jsonでプランを出力します。実行本体には、見積もりがゼロでも--confirm-paidが必要です。
Wordstatの試行、SERPの取得、Arsenkinのタスクは、呼び出しの前に予約されます。結果が不明なリクエストが自動で再送されることはありません。
キャッシュ済みのSERPと有料の受領記録は、プールを置換しても残るため、再クラスタリングでは新しいフレーズ分だけの支払いで済みます。
すべての課金は、対応するセマンティックプロジェクトとステージとともにspend-reportに記録されます。
プロバイダーの料金をオフラインで確定できない場合、プランは数字を推測せず、その旨を示します。
ツールキットに同梱されている合成のサンプルプロジェクトから取得しました。フレーズはYandexの需要に合わせてロシア語で、頻度は架空の値です。有料の呼び出しは行っていません。
$ seohead semantics clean --project ./core
$ seohead semantics graph --project ./core
$ seohead semantics sitematch --project ./core
clean: kept=34 review=4 dropped=3 | lemma groups=41 (median base=720, outlier>36000)
graph: homonyms=0, to review=0, candidate clusters=7 -> anomalies.md
sitematch: catalog terms=11 | off-catalog->review=8 | kept and matching the site=26$ seohead semantics cluster --project ./core --dry-run
"mode": "estimate", "stage": "cluster", "paid": true,
"provider": "yandex_search",
"request_estimate": {"unit": "requests", "count": 26, "kind": "upper_bound"},
"money_estimate": null,
"money_unavailable_reason": "provider pricing is not available from this offline preflight",
"paid_calls_made": 0$ seohead semantics status --project ./core
dropped=3 | kept=26 | review=12 | _total=41 | _exact=0 | _expanded=0 | _clusters=0
provider units: {'yandex_requests': 0, 'arsenkin': 0}
next: seohead semantics exact --project ./core$ seohead semantics export --project ./core --scope no-landing --dry-run
"mode": "preview", "scope": "no-landing", "rows": 41,
"planned_files": ["core/semantics/pool.csv", "core/semantics/pool.json"]seohead semantics status --project ./my-core先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。
10個のMCPツールが、同じステージと読み取りを提供します。有料の呼び出しはプランを返し、作業を送信するにはconfirm_paid=trueが必要です。
seo_semantics_statusカウンター、プロバイダー単位、次のステージseo_semantics_run無料のステージseo_semantics_mine競合ページ、プロバイダーのクォータは不要seo_semantics_paid有料のステージ:まずプラン、次にconfirm_paid=trueseo_semantics_clustersページ分割されたクラスター一覧seo_semantics_cluster_showランディングの根拠つきの1つのクラスターseo_semantics_cluster_queriesクラスターのフレーズと、保持している上位10件seo_semantics_set_landingランディングページの割り当てまたは解除seo_semantics_insightsクラスターとソースごとの週次シグナルseo_semantics_insights_tasks選んだシグナルをチェックリストへ