
Yandex Webmaster連携

所有権を確認済みのホストについて、Yandex WebmasterのURL別検索クエリを取得し、クロール結果と並べて保存します。読み取り専用で、OAuthトークンを使い、Webmaster APIの割り当て内なら無料です。

できること

URL別のクエリ

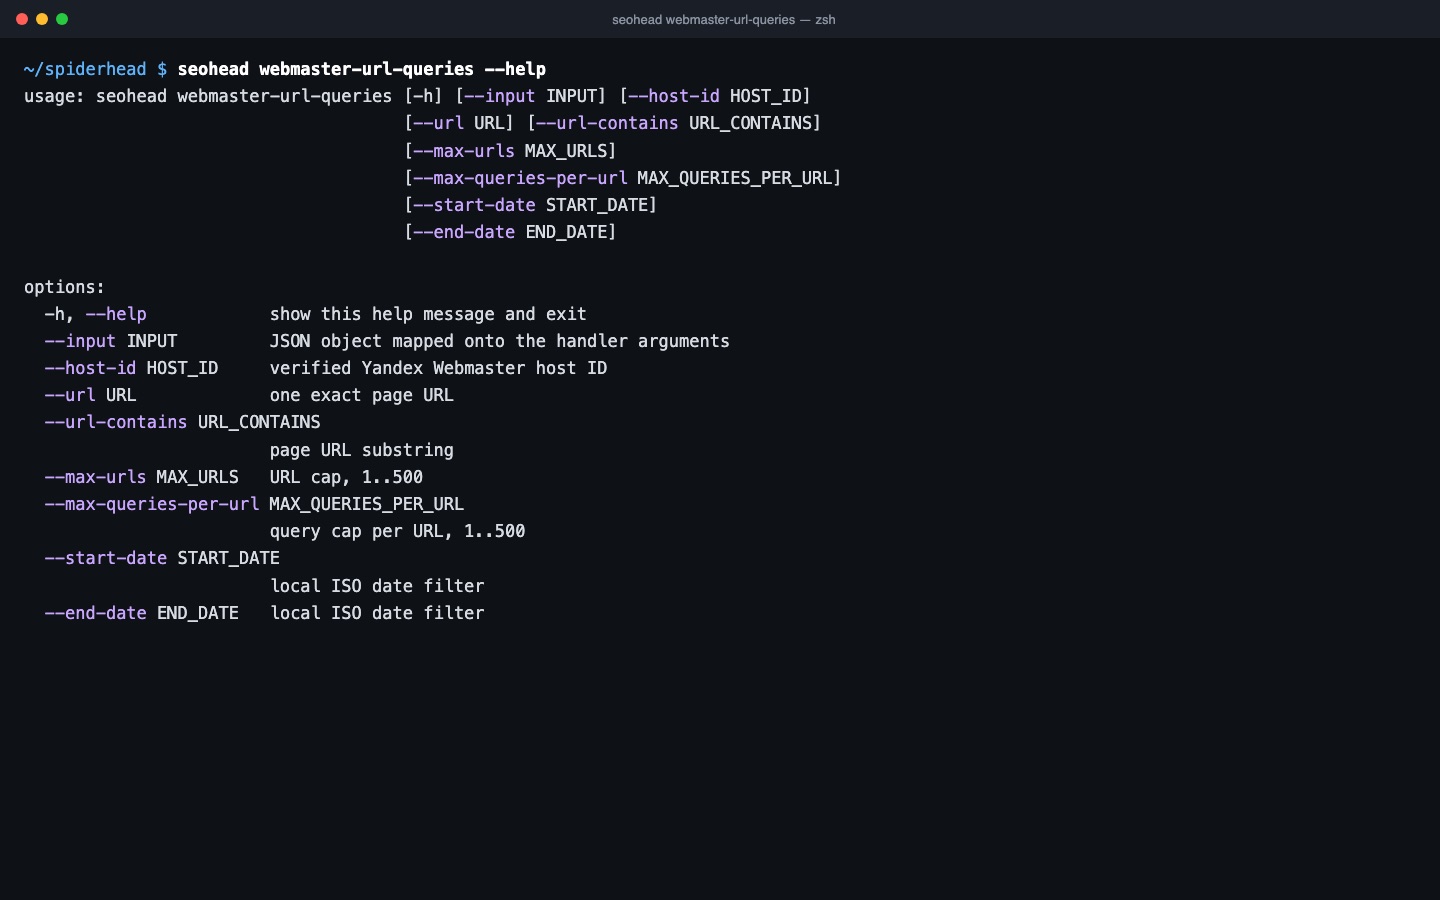
webmaster-url-queriesは、特定の1ページ(--url)またはページのグループ(--url-contains)の検索クエリを返します。URLの行とクエリの行は別々のまま保持し、CTRと平均掲載順位をページ間で合算することはありません。

  • --max-urlsと--max-queries-per-urlで上限を明示でき、切り捨てた場合はレスポンスに記載されます。
  • --start-dateと--end-dateで、日別の行を絞り込めます。
  • Yandex側に独自の保持期間があるため、古い期間は取得不可として拒否されます。

アクセス

必要なのは、Yandex Webmasterのアカウントで所有権を確認済みのホストのIDと、そのアカウントのOAuthトークンです。トークンは環境変数YANDEX_WEBMASTER_TOKENかトークンファイルに設定します。SpiderHeadがアカウントを作成したり、代わりにサインインしたりすることはありません。provider-discoverで、トークンから見えるホストを一覧にできます。

  • リクエストは読み取り専用で、Yandexには何も書き戻しません。
  • ホストIDがないとコマンドは実行されません。
  • クエリを取得する前に、SpiderHeadがそのホストをアカウントと照合します。

クロール結果と並べて保存する

sources-syncを使うと、Webmasterの日別データをローカルのSQLite履歴に保存できます。APIが一度に返す範囲を超えて、データを蓄積できます。evidence-joinは、URLをキーとする行をクロール結果に紐づけ、孤立ページの候補をレビュー用に一覧にします。どちらの手順も、クロール結果は変更しません。

  • sources-syncでは--source webmasterまたはwebmaster_historyを指定します。
  • クロールだけにあるURL、外部だけにあるURL、キーにできないURLは、名前を付けて別々に保持します。
  • 保存した行にクエリやURLが含まれる場合があるため、ファイルはGitに入れないでください。

3ステップで、スキャンを1件保存

  1. 所有権を確認済みのホストを指定する

    コマンドに必要なのは、所有権を確認済みのサイトのYandex WebmasterホストIDと、ローカルに設定したOAuthトークンです。ホストIDがないと実行されません。

  2. URLのクエリを取得する

    --urlで特定の1ページ、--url-containsでページのグループを指定します。上限は--max-urlsと--max-queries-per-urlで明示し、必要に応じて--start-dateと--end-dateも指定します。

  3. 取得した行をクロール結果に紐づける

    URLの行とクエリの行は別々のままにします。evidence-joinの手順で、URLをキーとする行をクロール結果に紐づけ、孤立ページの候補をレビュー用に一覧にします。クロール結果は変更しません。

コマンド1つで実行

bash
seohead webmaster-url-queries --url https://example.com/

先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。

必要なもの

  • 所有権を確認済みのYandex WebmasterのホストID(--host-id)
  • そのホストにアクセスできるYandexのOAuthトークン
  • 正確なURL、またはURLの一部

制限事項

  • 読み取れるのは、ご自身のアカウントで所有権を確認したホストだけです。
  • Yandexがクエリデータを保持する期間は限られています。終了日が14日より前の期間は拒否されます。
  • 結果には上限があり、切り捨てられた場合はその旨が表示されます。
  • インデックス登録や診断など、Webmasterのほかの操作は、このコマンドではなくprovider-collectで実行します。

よくある質問

所有権を確認済みのYandex Webmasterホストは必要ですか?
はい。コマンドには、所有権を確認済みのホストID(--host-id)と、マシンに設定したOAuthトークンが必要です。SpiderHeadがアカウントを作成したり、代わりにサインインしたりすることはありません。
Yandexやサイトに変更を加えますか?
いいえ。読み取り専用のリクエストです。指定したURLのクエリ統計を返すだけで、Yandexにもサイトにも何も書き戻しません。
クリック数や掲載順位はページ間で合算されますか?
いいえ。URLごとにクエリの行を別々に保持します。CTRと平均掲載順位をページ間で合算することはなく、適用した上限もレスポンスに記載されます。
料金はかかりますか?
Yandex Webmaster APIの割り当て内であれば、無料です。ツールキットでも、このプロバイダーは割り当て内で無料と扱っています。
APIの保持期間を超えて履歴を残せますか?
はい。sources-syncを使うと、Webmasterの日別データをローカルのSQLite履歴に保存でき、時間をかけて蓄積できます。ただし、Yandexがすでに返さなくなった日のデータは取り戻せません。
AIアシスタントから使えますか?
はい。ローカルのMCPサーバーが、同じ処理をseo_webmaster_url_queriesとして提供しています。