
Crawl ohne Projekt
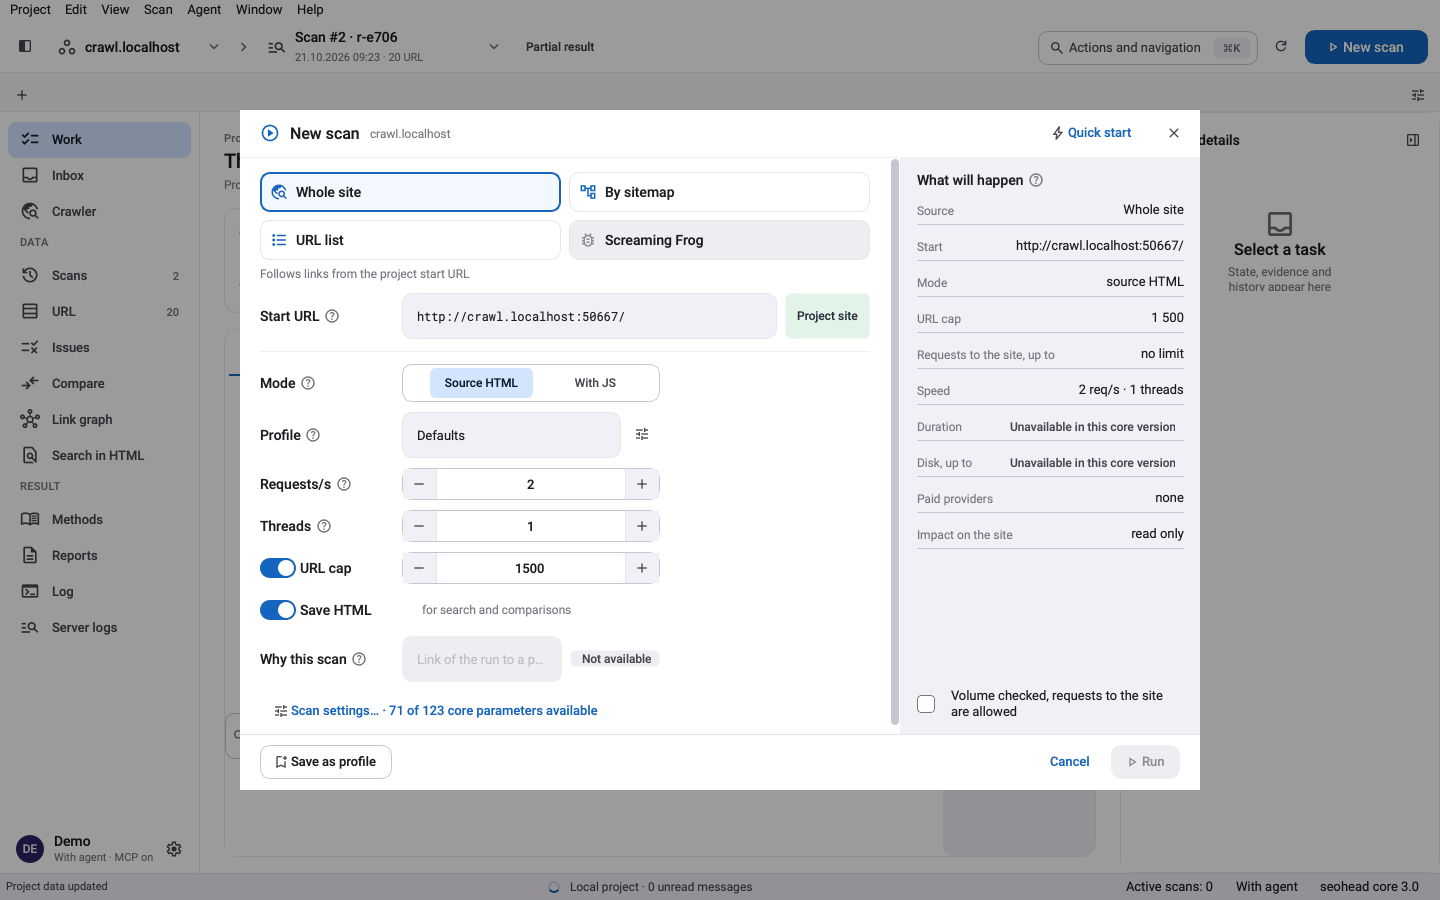
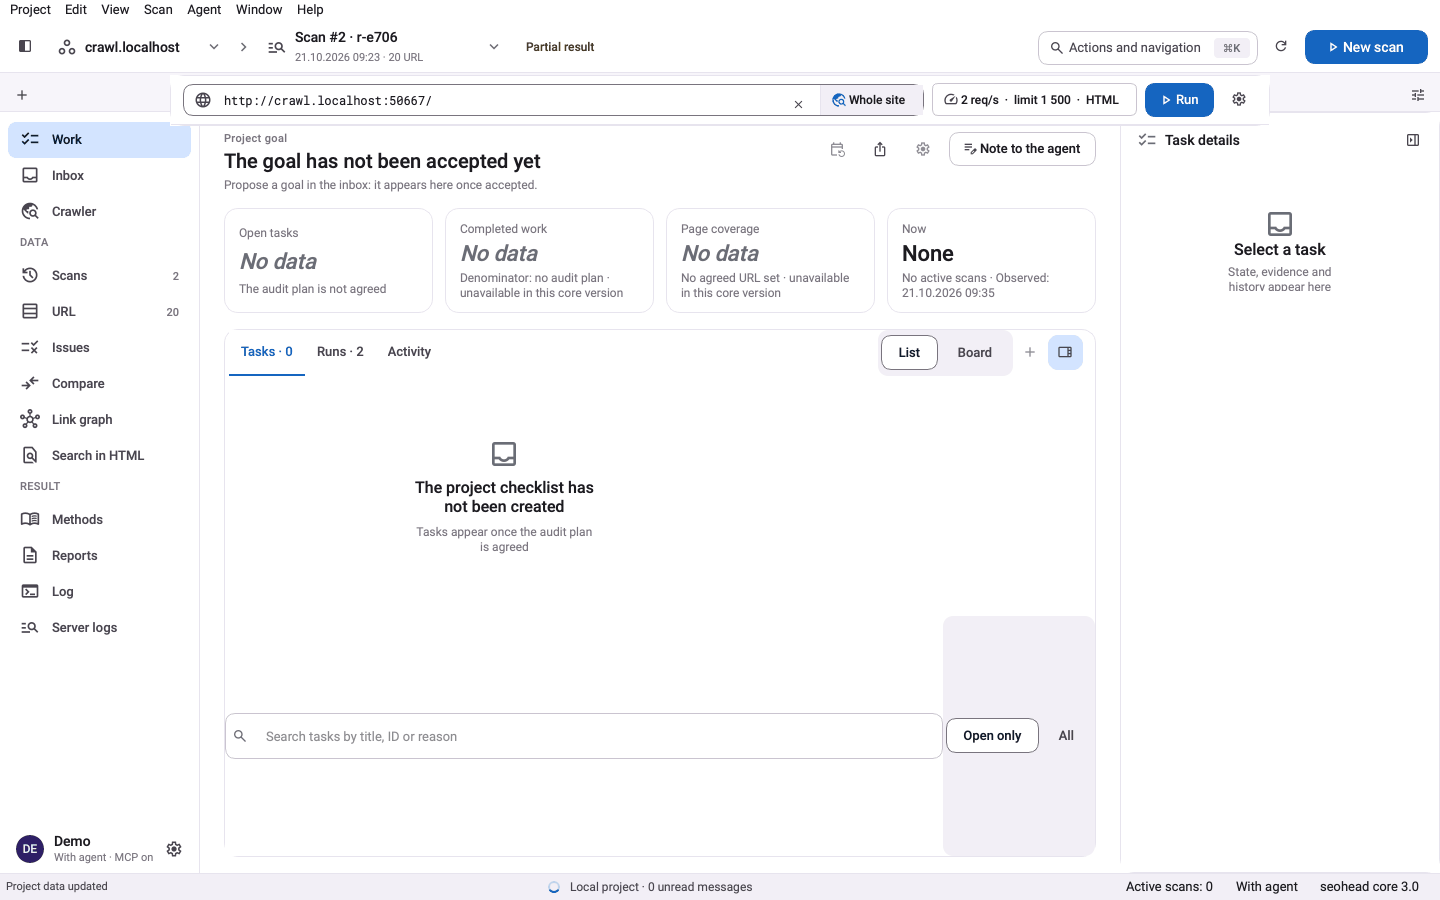
In der Desktop-App geben Sie eine URL ein und klicken auf Starten; das Ergebnis können Sie später als Projekt speichern. Im Terminal folgt crawl-site den Links ab der Start-URL und schreibt einen nativen SQLite-Scan, den Sie erneut öffnen, exportieren und offline neu auswerten können. Derselbe Crawl steht einem KI-Agenten über den lokalen MCP-Server als seo_crawl_site zur Verfügung.
- Standardmäßig derselbe Host; Subdomains sind eine Option (scope.internal)
- robots.txt wird standardmäßig beachtet
- Kostenlos und lokal: kein gehostetes Konto und keine Screaming-Frog-Lizenz