
Rastreador de SEO local e gratuito

O SpiderHead rastreia um site a partir de uma URL inicial na sua própria máquina, segue os links do mesmo host, respeita o robots.txt e audita o resultado com as mesmas verificações que usa para as exportações do Screaming Frog.

O que faz

Rastreamento sem projeto

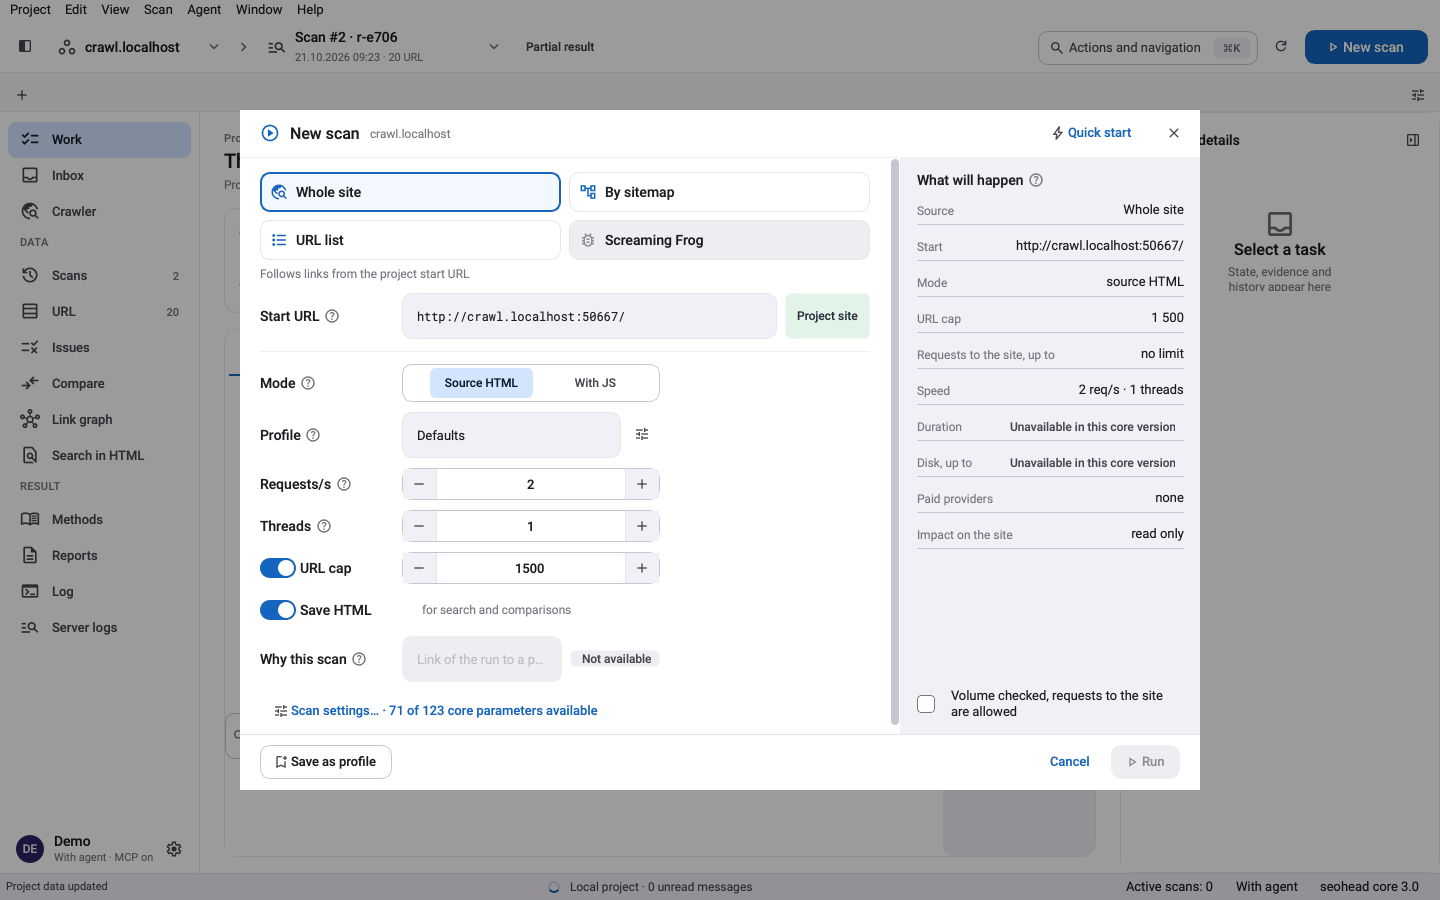
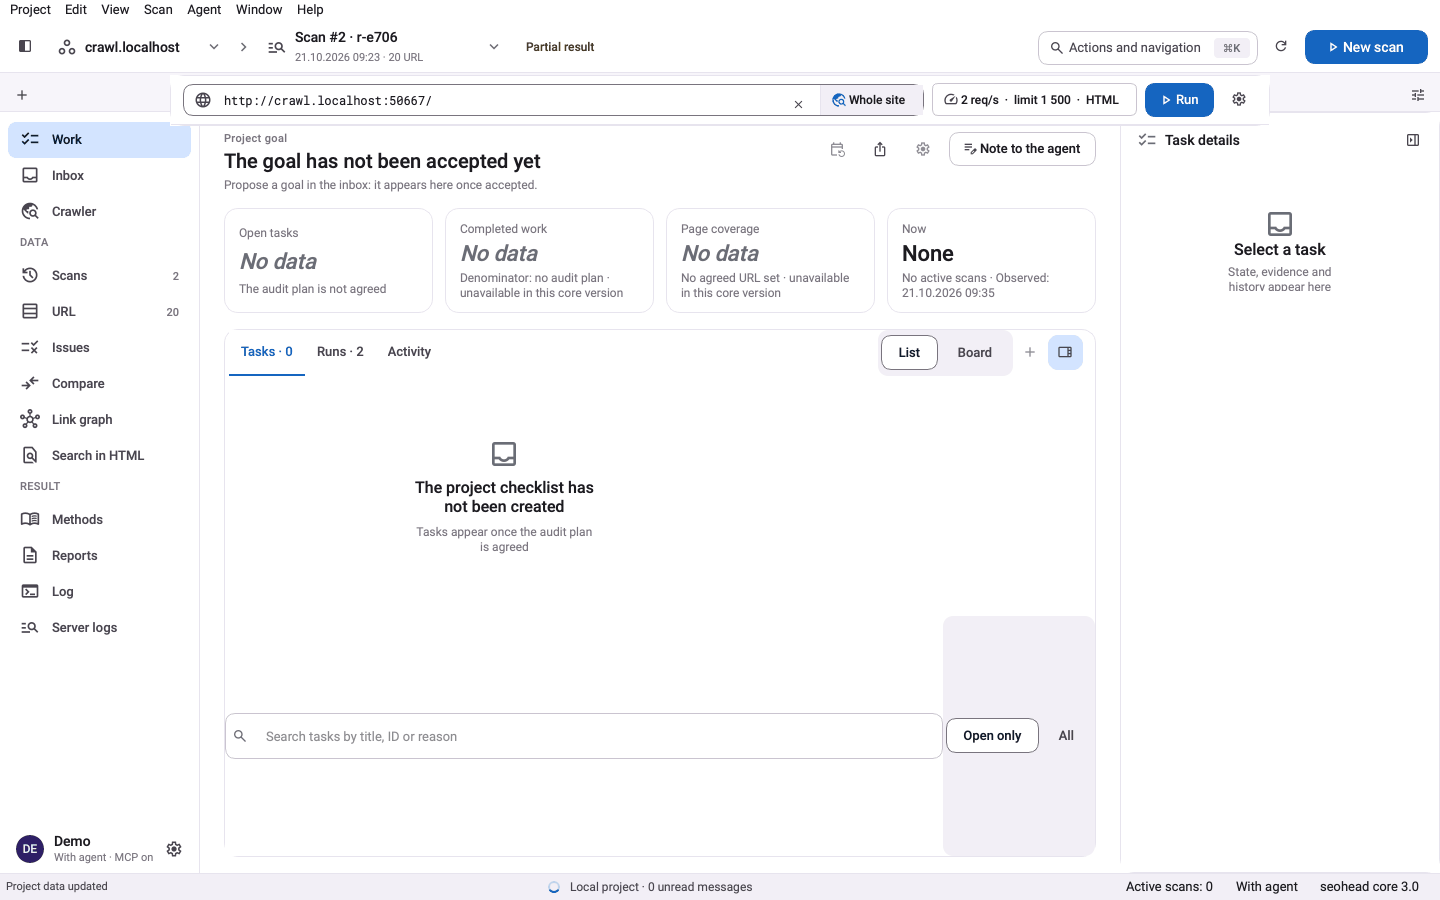
No app para desktop, digite uma URL e clique em “Start”; depois você pode salvar o resultado como projeto. No terminal, o crawl-site segue os links a partir da URL inicial e grava um único scan SQLite nativo, que você pode reabrir, exportar e reanalisar offline. O mesmo rastreamento fica disponível para um agente de IA pelo servidor MCP local, como seo_crawl_site.

  • Mesmo host por padrão; subdomínios são uma opção (scope.internal)
  • O robots.txt é respeitado por padrão
  • Gratuito e local: sem conta hospedada e sem licença do Screaming Frog

Verificações que não podem rodar são sinalizadas

Um rastreamento nativo não coleta todos os tipos de evidência. Uma verificação que precisa de dados que o rastreamento não coletou volta como ignorada, com o motivo, nunca como um falso “sem problemas”. Cada verificação termina como problema encontrado, executada sem problemas, ignorada ou com falha.

  • Quatro resultados por verificação, para que nenhuma lacuna fique escondida
  • Verificações baseadas em links que exigem um rastreamento completo são suprimidas em um rastreamento parcial

Três passos, um rastreamento salvo

  1. Comece com uma URL

    Digite uma URL inicial no app para desktop ou rode o crawl-site no terminal. Ele segue os links do mesmo host e grava um único scan SQLite que você pode reabrir.

  2. Seja educado por padrão

    Cerca de duas requisições por segundo por host, com pausas adaptativas. Você define o limite de URLs; o padrão é 200.

  3. Audite as mesmas evidências

    O rastreamento é verificado pelo mesmo registro usado nas exportações do Screaming Frog. Uma verificação que precisa de dados que um rastreamento nativo não consegue coletar é marcada como ignorada, com o motivo, nunca como sem problemas.

Verificações deste recurso

VerificaçãoO que significaGravidadeEvidência
BROKEN_PAGE_4XXA página rastreada responde com 4xxCriticalURL e código de resposta
SERVER_ERROR_5XXA página rastreada responde com 5xxCriticalURL e código de resposta
NO_RESPONSESem resposta: tempo esgotado, falha de DNS ou de conexãoCriticalURL e motivo da falha
BROKEN_INTERNAL_LINKUm link interno aponta para uma URL 4xxCriticalPágina de origem e posição do link
REDIRECT_LOOPA cadeia de redirecionamentos volta para uma URL já visitadaCriticalCaminho do loop
REDIRECT_CHAINDois ou mais redirecionamentos antes da URL finalImportantCada redirecionamento com o status
BLOCKED_BY_ROBOTSO robots.txt bloqueia a URL, então o rastreamento não a buscouImportantURL e regra do robots.txt correspondente

Um comando

bash
seohead crawl-site --url https://example.com --max-urls 500 --scan-out ./scans/audit.sqlite

Instale primeiro: guia de instalação. Todo comando também funciona como ferramenta MCP para agentes de IA.

O que você precisa

  • Uma URL inicial (ou uma lista de URLs com --urls ou --urls-file)
  • Um caminho para o arquivo do scan (--scan-out) ou uma pasta de projeto
  • Opcional: um arquivo de configuração do rastreador (JSON); o crawl-site --config-help lista todas as configurações

Limites

  • O rastreamento básico lê HTML estático; a renderização de JavaScript é um complemento opcional
  • Para em 200 URLs por padrão; aumente --max-urls de forma intencional (até 1.000.000)
  • Não substitui o Screaming Frog por completo: algumas verificações voltam como ignoradas
  • Segue os links de um único host, a menos que você amplie o escopo

Perguntas

Preciso de licença do Screaming Frog?
Não. O rastreamento nativo roda localmente e não exige conta hospedada nem licença do Screaming Frog. As exportações do Screaming Frog ainda podem ser importadas, se você já as tiver.
É um substituto completo do Screaming Frog?
Não, e não afirma paridade. Verificações que precisam de evidências que o rastreamento nativo não coletou são informadas como ignoradas, e o summary.check_coverage mostra quanto do registro foi executado.
Ele respeita o robots.txt?
Sim, por padrão. Se o robots.txt não puder ser obtido de jeito nenhum, o rastreamento para em vez de presumir acesso (robots.unavailable_means_stop, ativo por padrão). Use --robots report_only para rastrear mesmo assim e listar o que seria bloqueado.
Quantas URLs ele vai rastrear?
O limite padrão é de 200 URLs. Defina --max-urls até 1.000.000, ou 0 para não ter limite de URLs, que continua restrito pelas outras proteções de recursos. Rastreamentos acima dos orçamentos do projeto exigem --approve-large-crawl.
Ele consegue renderizar páginas com JavaScript?
Não no rastreamento padrão. A renderização é opcional: instale o extra render e um navegador do Playwright, e depois defina rendering.mode como js na configuração do rastreamento. O rastreamento básico funciona sem navegador.

Teste no seu próprio site