Бесплатный локальный SEO-краулер
SpiderHead обходит сайт со стартового URL на вашей машине, следует ссылкам в пределах хоста, уважает robots.txt и проверяет результат теми же проверками, что и выгрузки Screaming Frog.
Бесплатный локальный SEO-краулер
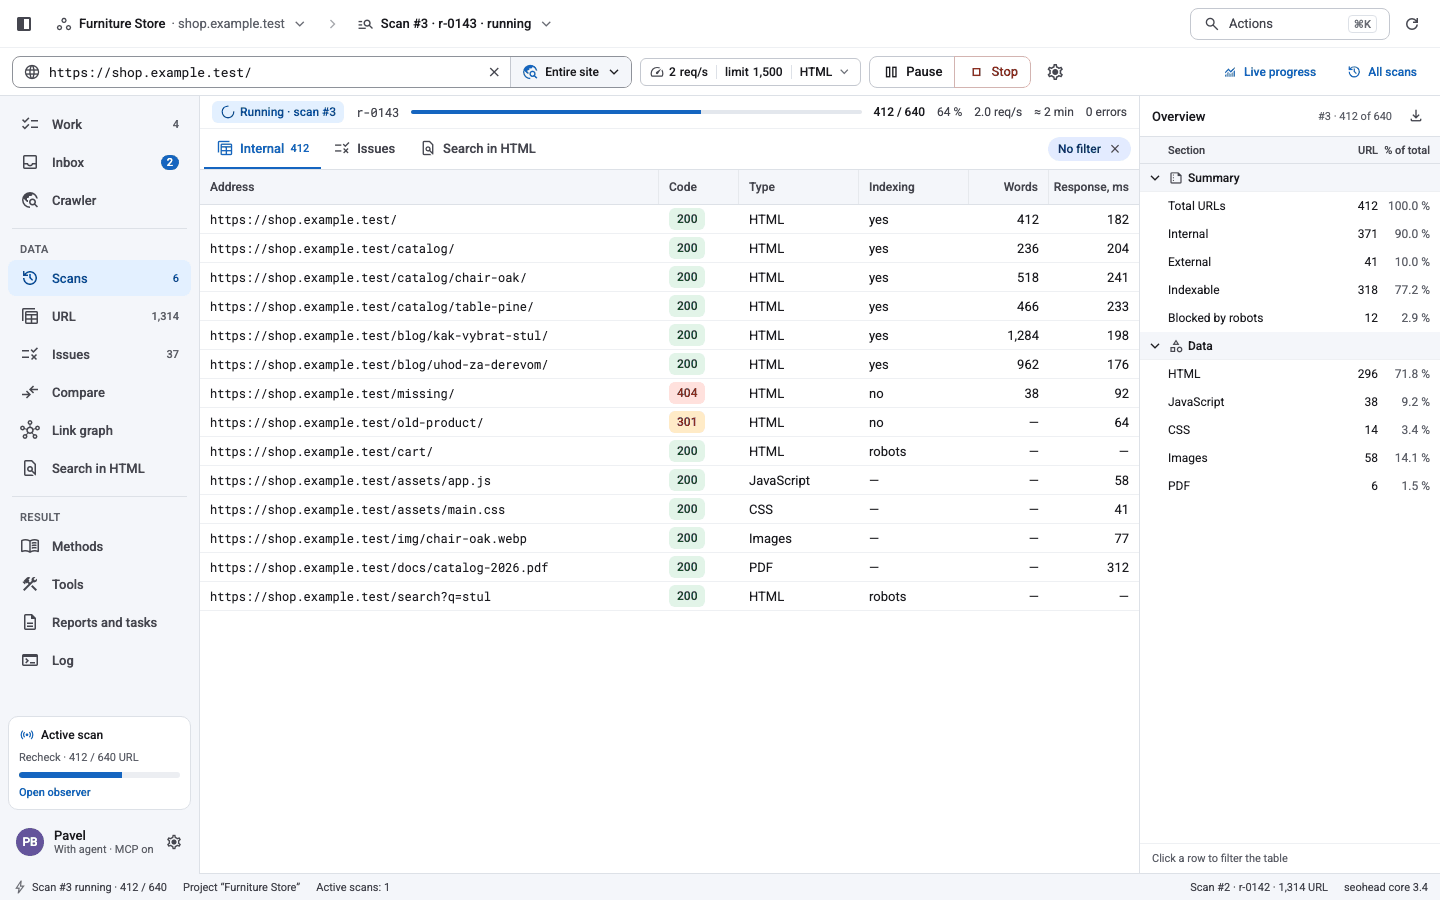
Обход без проекта
В десктоп-приложении введите URL и нажмите «Старт»; результат сохраните как проект позже. В терминале crawl-site пишет один нативный SQLite-скан, который можно переоткрыть, выгрузить и пересчитать.
- Ссылки в пределах того же хоста
- robots.txt уважается
- Бесплатно и локально: без облачного аккаунта
Бесплатный локальный SEO-краулер
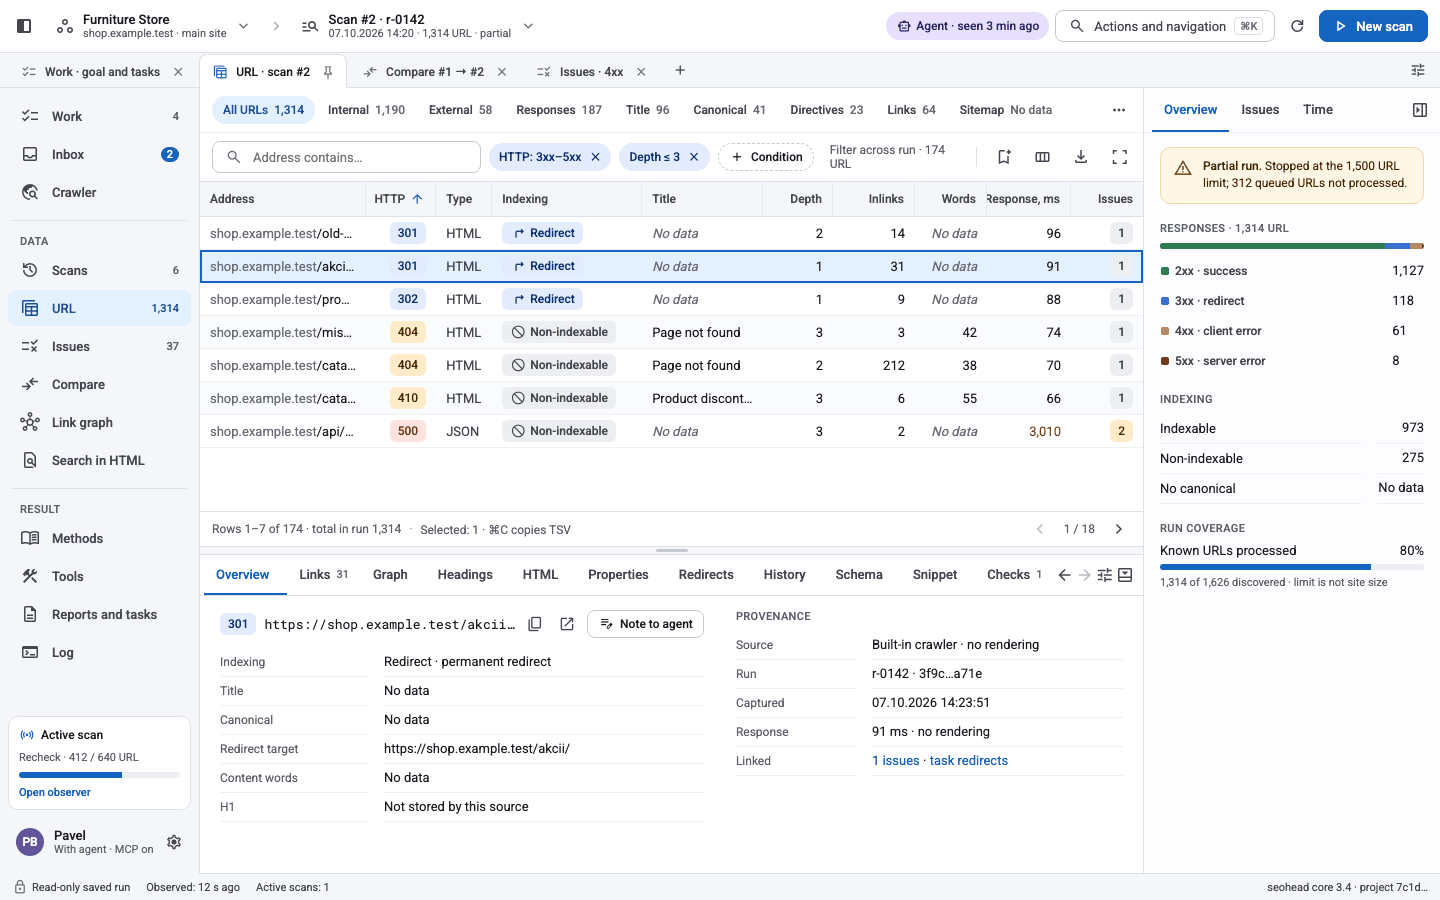
Неотработавшие проверки так и говорят
Нативный обход не может собрать все виды доказательств. Проверки, которым нужно то, что он не собрал, возвращаются со статусом «пропущена» и причиной — никогда как ложное «чисто».
- Находка, прошла без находок, пропущена или упала
- Частичные обходы не делают заявлений о графе ссылок
Три шага — один сохранённый скан
Начните с одного URL
Введите стартовый URL в приложении или запустите crawl-site в терминале. Обход идёт по ссылкам хоста и пишет один нативный SQLite-скан, который можно переоткрыть.
Вежливость по умолчанию
Около двух запросов в секунду на хост с адаптивными паузами. Лимит URL задаёте вы; по умолчанию 200.
Аудит тех же доказательств
Обход проверяется тем же реестром, что и выгрузки Screaming Frog. Проверка, которой нужны данные вне нативного обхода, помечается «пропущена» с причиной, а не «чисто».
Проверки в этой возможности
| Проверка | Что значит | Критичность | Доказательство |
|---|---|---|---|
BROKEN_PAGE_4XX | Обойдённая страница отвечает 4xx | Critical | URL и код ответа |
SERVER_ERROR_5XX | Обойдённая страница отвечает 5xx | Critical | URL и код ответа |
NO_RESPONSE | Нет ответа: таймаут, DNS или отказ соединения | Critical | URL и причина сбоя |
BROKEN_INTERNAL_LINK | Внутренняя ссылка ведёт на 4xx-URL | Critical | Страница-источник и позиция ссылки |
REDIRECT_LOOP | Цепочка редиректов возвращается к уже посещённому URL | Critical | Путь петли |
REDIRECT_CHAIN | Два и более перехода до финального URL | Important | Все переходы с кодами |
BLOCKED_BY_ROBOTS | robots.txt блокирует URL, поэтому обход его не скачивал | Important | URL и сработавшее правило robots.txt |
Одна команда
seohead crawl-site --url https://example.com --max-urls 500 --scan-out ./scans/audit.sqliteСначала установите: руководство по установке. Каждая команда работает и как MCP-инструмент для ИИ-агентов.
Из реестра проверок
BROKEN_PAGE_4XXSERVER_ERROR_5XXNO_RESPONSEBLOCKED_BY_ROBOTS