
Integration der Google Search Console

Fragen Sie die Search Console ab, archivieren Sie ihre Daten in einer lokalen SQLite-Datei und verknüpfen Sie sie pro URL mit den Crawl-Nachweisen. Der Zugriff ist nur lesend und läuft über Ihre eigenen Google-Zugangsdaten.

Was es leistet

Nur lesend verbinden

SpiderHead nutzt ausschließlich den schreibgeschützten Berechtigungsumfang (Scope) der Search Console. Den Zugriff können Sie auf drei Wegen bereitstellen, einen davon wählen Sie. Danach prüft provider-verify separat, ob Sie auf die Property zugreifen können, denn eine gültige Anmeldung allein belegt noch nicht, dass Sie eine bestimmte Website lesen dürfen.

  • Zustimmung im Browser mit Ihrem eigenen OAuth-Client vom Typ Desktop, über scripts/gsc_oauth_login.py. Das Refresh-Token liegt im lokalen Konfigurationsordner.
  • Ein Google-Dienstkonto, das Sie als Nutzer der Property hinzufügen.
  • Ein fertiges Zugriffstoken in der Einstellung GSC_ACCESS_TOKEN.

Lokaler Verlauf

gsc-archive stellt einen Datumsbereich in die Warteschlange und lädt ihn in kleinen, fortsetzbaren Paketen in eine SQLite-Datei Ihrer Wahl. sources-sync führt den täglichen Verlauf pro Projekt und lädt nur die fehlenden Tage nach. Nichts wird an einen gehosteten Dienst übertragen, und die Dateien werden nur für den Eigentümer lesbar angelegt.

  • Datumsangaben sind inklusive und beziehen sich auf Pacific Time.
  • Verschiedene Granularitäten (Gesamtwerte, Seiten, Suchanfragen) sind getrennte Datensätze und werden nie summiert.
  • Archive können Suchanfragen und URLs enthalten. Halten Sie sie aus öffentlichen Berichten und aus Git heraus.

URL-Inspektion

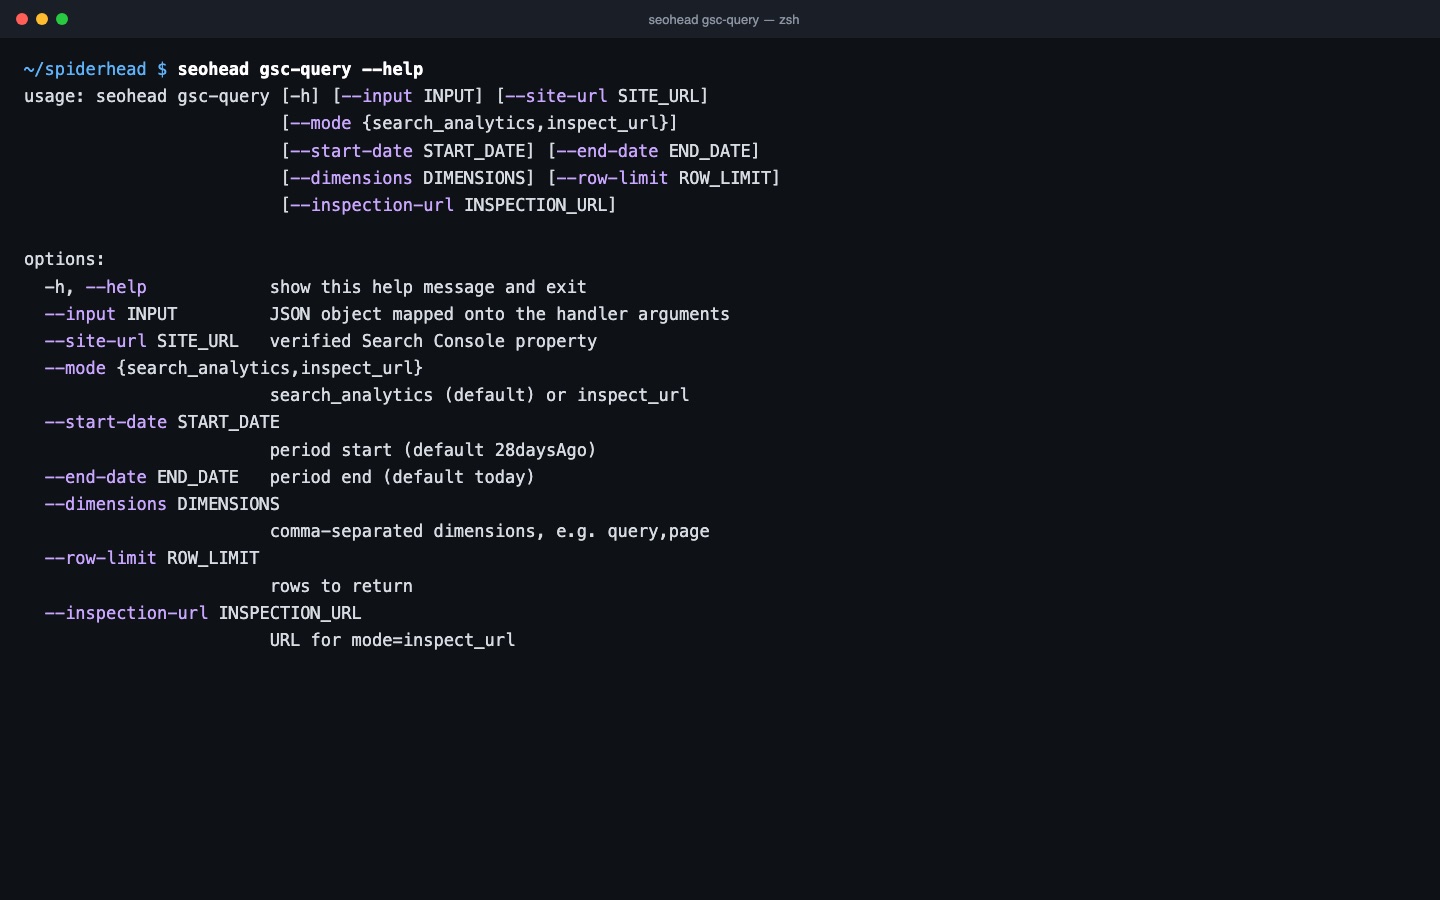
gsc-query im Modus inspect_url liefert das eigene Indexierungsurteil von Google für eine URL. Es steht in einer eigenen Zeile, getrennt von den Prüfungen des Crawlers. Innerhalb von sf run prüft --gsc-inspect eine deterministische Stichprobe von bis zu 50 URLs, mit lokalen Ratenlimits von 600 pro Minute und 2.000 pro 24 Stunden.

  • Geprüft werden kann nur die indexierte Version einer Seite.
  • Zusätzlich zu den lokalen Limits gelten die Limits von Google pro Website.
  • Nicht geprüfte URLs bleiben unbekannt.

Drei Schritte, ein gespeicherter Scan

  1. Einen schreibgeschützten Zugang verbinden

    Verbinden Sie einen schreibgeschützten Google-Zugang für eine Property, die Ihnen gehört. Den Status können Sie jederzeit prüfen.

  2. Lokal archivieren

    Stellen Sie einen Datumsbereich in die Warteschlange und laden Sie ihn in kleinen, begrenzten Paketen in eine SQLite-Datei auf Ihrem Rechner. Wiederholte Läufe laden nur die fehlenden Tage nach.

  3. Jeder URL zuordnen

    Klicks, Impressionen, Position und CTR werden den Crawl-Seiten über die URL zugeordnet. Das Indexierungsurteil von Google für eine einzelne URL steht in einer eigenen Zeile.

Ein Befehl

bash
seohead gsc-query --site-url sc-domain:example.com --start-date 2026-09-01 --end-date 2026-09-30

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Eine Search-Console-Property, die Ihnen gehört oder die Sie lesen dürfen (eine Domain-Property oder ein URL-Präfix)
  • Eine Zugangsvariante: OAuth-Zustimmung, ein Dienstkonto oder ein Zugriffstoken (alle nur lesend)
  • Ein Datumsbereich, möglichst innerhalb der letzten etwa 16 Monate
  • Optional: ein Crawl oder Scan, dem die Zeilen zugeordnet werden

Grenzen

  • Google speichert etwa 16 Monate Daten.
  • Anonymisierte Suchanfragen fehlen, und Zeilen können gekürzt werden. Ein gekürzter Job ist markiert und kein vollständiger Export.
  • Klicks, Impressionen, CTR und Position werden über verschiedene Granularitäten hinweg nicht summiert.
  • Das Indexierungsurteil gilt nur für die URLs, die Sie prüfen.

Fragen

Landen meine Daten bei einem gehosteten Dienst?
Nein. Die Anfragen gehen von Ihrem Rechner direkt an die API der Google Search Console, mit Ihrem eigenen Zugang. Die Ergebnisse liegen in lokalen SQLite-Dateien mit Zugriffsrechten nur für den Eigentümer. Halten Sie diese Dateien aus öffentlichen Berichten und aus Git heraus, denn sie können Suchanfragen und URLs enthalten.
Kann das Tool meine Search-Console-Property verändern?
Nein. Der Zugang ist nur lesend. Das Tool liest ausschließlich Suchanalysen und Ergebnisse der URL-Prüfung.
Wie weit reichen die Daten zurück?
Etwa 16 Monate, so weit reicht der verfügbare Verlauf bei Google. Datumsangaben sind inklusive und beziehen sich auf Pacific Time.
Warum fehlen manche Suchanfragen?
Google lässt anonymisierte Suchanfragen weg und kann die zurückgegebenen Zeilen begrenzen. Ein gekürzter Job ist kein vollständiger Export, und das Tool markiert ihn entsprechend.
Ersetzt das Indexierungsurteil von Google die Prüfungen des Crawlers?
Nein. Das Urteil von Google für eine einzelne URL stammt von gsc-query im Modus inspect_url. Die eigenen Prüfungen des Crawlers (Metadaten, Header, robots, Weiterleitungen, strukturierte Daten, Rendering) laufen mit inspect-url. Beide Ergebnisse bleiben getrennt.
Was kostet das, und was wird lokal gespeichert?
Die API ist innerhalb der Kontingente von Google kostenlos. SpiderHead speichert Ihr Refresh-Token bzw. den Pfad zum Dienstkonto im lokalen Konfigurationsordner, Archiv- und Verlaufsdateien dort, wo Sie es angeben. In den Verlaufsdateien steht kein Token.

Testen Sie es auf Ihrer eigenen Website