
Integration Yandex Webmaster

Lesen Sie Yandex-Webmaster-Suchanfragen je URL für einen Host, den Sie verifiziert haben, und speichern Sie die Zeilen neben Ihrem Crawl. Nur lesend, mit OAuth-Token, kostenlos im Rahmen des Webmaster-API-Kontingents.

Was es leistet

Suchanfragen je URL

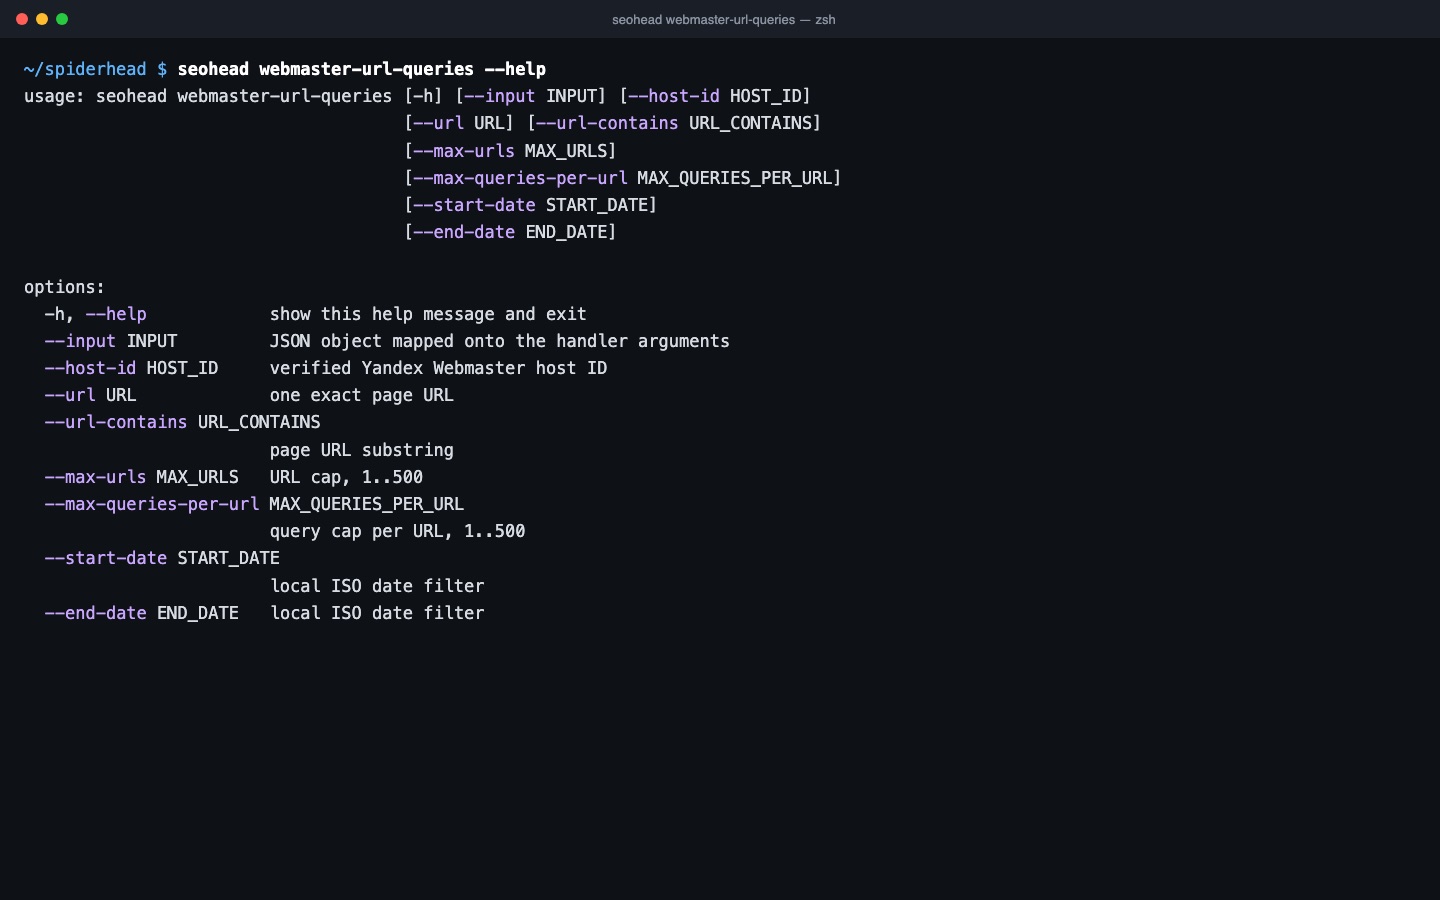
webmaster-url-queries liefert Suchanfragen für eine einzelne Seite (--url) oder für eine Gruppe von Seiten (--url-contains). URL- und Suchanfragezeilen bleiben getrennt. CTR und durchschnittliche Position werden nicht über mehrere Seiten summiert.

  • --max-urls und --max-queries-per-url setzen explizite Obergrenzen. Die Antwort nennt, wenn sie gekürzt wurde.
  • --start-date und --end-date filtern die Tageszeilen.
  • Yandex führt ein eigenes gleitendes Zeitfenster. Ein altes Datum wird deshalb als nicht verfügbar abgelehnt.

Zugang

Sie brauchen die ID eines Hosts, der in Ihrem Yandex-Webmaster-Konto verifiziert ist, und ein OAuth-Token für dieses Konto. Das Token gehört in YANDEX_WEBMASTER_TOKEN oder in die Token-Datei. SpiderHead legt keine Konten an und meldet Sie nicht an. provider-discover kann die Hosts auflisten, die das Token sehen kann.

  • Die Anfrage ist nur lesend und schreibt nichts zurück an Yandex.
  • Ohne Host-ID läuft der Befehl nicht.
  • SpiderHead prüft den Host gegen Ihr Konto, bevor die Suchanfragen abgerufen werden.

Neben dem Crawl aufbewahren

sources-sync kann tägliche Webmaster-Nachweise in einer lokalen SQLite-Historie speichern. So sammeln Sie Daten über das hinaus, was die API zu einem Zeitpunkt liefert. evidence-join hängt URL-geschlüsselte Zeilen an einen Crawl an und listet Kandidaten für verwaiste Seiten zur Prüfung auf. Beide Schritte verändern den Crawl nicht.

  • Verwenden Sie --source webmaster oder webmaster_history mit sources-sync.
  • Nur im Crawl vorhandene, nur extern vorhandene und nicht zuordenbare URLs bleiben benannt und getrennt.
  • Gespeicherte Zeilen können Suchanfragen und URLs enthalten. Halten Sie die Dateien deshalb aus Git heraus.

Drei Schritte, ein gespeicherter Scan

  1. Auf einen verifizierten Host zeigen

    Der Befehl braucht eine Host-ID von Yandex Webmaster für eine Website, die Sie verifiziert haben, sowie das lokal eingerichtete OAuth-Token. Ohne Host-ID läuft er nicht.

  2. Suchanfragen für eine URL abrufen

    Fordern Sie eine exakte Seite mit --url oder eine Gruppe mit --url-contains an. Die Obergrenzen sind explizit: --max-urls und --max-queries-per-url, optional mit --start-date und --end-date.

  3. Zeilen mit dem Crawl verknüpfen

    Halten Sie URL- und Suchanfragezeilen getrennt. Der Schritt evidence-join hängt URL-geschlüsselte Zeilen an einen Crawl an und listet Kandidaten für verwaiste Seiten zur Prüfung auf, ohne den Crawl zu verändern.

Ein Befehl

bash
seohead webmaster-url-queries --url https://example.com/

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Eine verifizierte Host-ID von Yandex Webmaster (--host-id)
  • Ein Yandex-OAuth-Token mit Zugriff auf diesen Host
  • Eine exakte URL oder ein URL-Teilstring

Grenzen

  • Gelesen werden können nur Hosts, die in Ihrem eigenen Konto verifiziert sind.
  • Yandex speichert Suchanfragedaten nur für ein begrenztes, gleitendes Zeitfenster. Ein Datumsbereich, der mehr als 14 Tage zurückliegt, wird abgelehnt.
  • Die Ergebnisse sind begrenzt. Ein gekürztes Ergebnis wird als solches gekennzeichnet.
  • Andere Webmaster-Funktionen wie Indexierung und Diagnose laufen über provider-collect, nicht über diesen Befehl.

Fragen

Brauche ich einen verifizierten Yandex-Webmaster-Host?
Ja. Der Befehl erwartet eine verifizierte Host-ID (--host-id) und ein OAuth-Token, das auf Ihrem Rechner eingerichtet ist. SpiderHead legt keine Konten an und meldet Sie nicht an.
Ändert das etwas bei Yandex oder auf meiner Website?
Nein. Es ist eine reine Leseanfrage. Sie liefert Suchanfragestatistiken für die von Ihnen genannten URLs und schreibt nichts zurück an Yandex oder an die Website.
Werden Klicks und Positionen über Seiten hinweg summiert?
Nein. Jede URL behält ihre eigenen Suchanfragezeilen. CTR und durchschnittliche Position werden nicht über Seiten hinweg summiert, und die Antwort nennt die angewendeten Obergrenzen.
Was kostet das?
Nichts, abgesehen vom Kontingent der Yandex-Webmaster-API. Das Toolkit führt den Dienst innerhalb dieses Kontingents als kostenlos auf.
Kann ich einen Verlauf über das API-Zeitfenster hinaus speichern?
Ja, mit sources-sync. Es speichert tägliche Webmaster-Nachweise in einer lokalen SQLite-Historie, sodass Sie Daten über die Zeit aufbauen können. Tage, die Yandex nicht mehr liefert, lassen sich nicht wiederherstellen.
Kann ich das aus einem KI-Assistenten heraus nutzen?
Ja. Der lokale MCP-Server stellt denselben Vorgang als seo_webmaster_url_queries bereit.

Testen Sie es auf Ihrer eigenen Website