
SpiderHead – SEO-Crawler und Audit-Toolkit
Website crawlen, jeden Scan behalten, Probleme finden und priorisieren, Aufgaben an Entwickler übergeben, Korrekturen erneut prüfen und berichten. Auf Ihrem eigenen Rechner: in der Desktop-App, im Terminal oder über einen KI-Agenten per MCP.
Antippen für die Originalgröße
Ein Kern, drei Oberflächen
Desktop-App, CLI und MCP-Server rufen dieselben Handler auf: Ein Crawl, den ein Agent startet, erscheint im Fenster – und umgekehrt.
Desktop-App
Ein natives Fenster für macOS, Windows und Linux: Probleme, URL-Tabelle, Link-Graph, Projekte und Tools mit fertigen Formularen.macOS, Windows und Linux.
Desktop-AppCLI
Für Skripte, CI und die Arbeit im Terminal. Jeder Befehl schreibt Belege, die Sie wieder öffnen, exportieren und neu auswerten können.
seohead crawl-site --url ...MCP-Server
Ein lokaler stdio-Server für Claude und andere Agent-Clients. Der Agent crawlt, prüft und übergibt Aufgaben – mit denselben Belegen.Für Claude und andere Agent-Clients.
MCP-Server für SEOVom ersten Crawl bis zur Nachprüfung
Echte Ansichten der App. Ein Klick auf ein Bild öffnet es in Originalgröße.
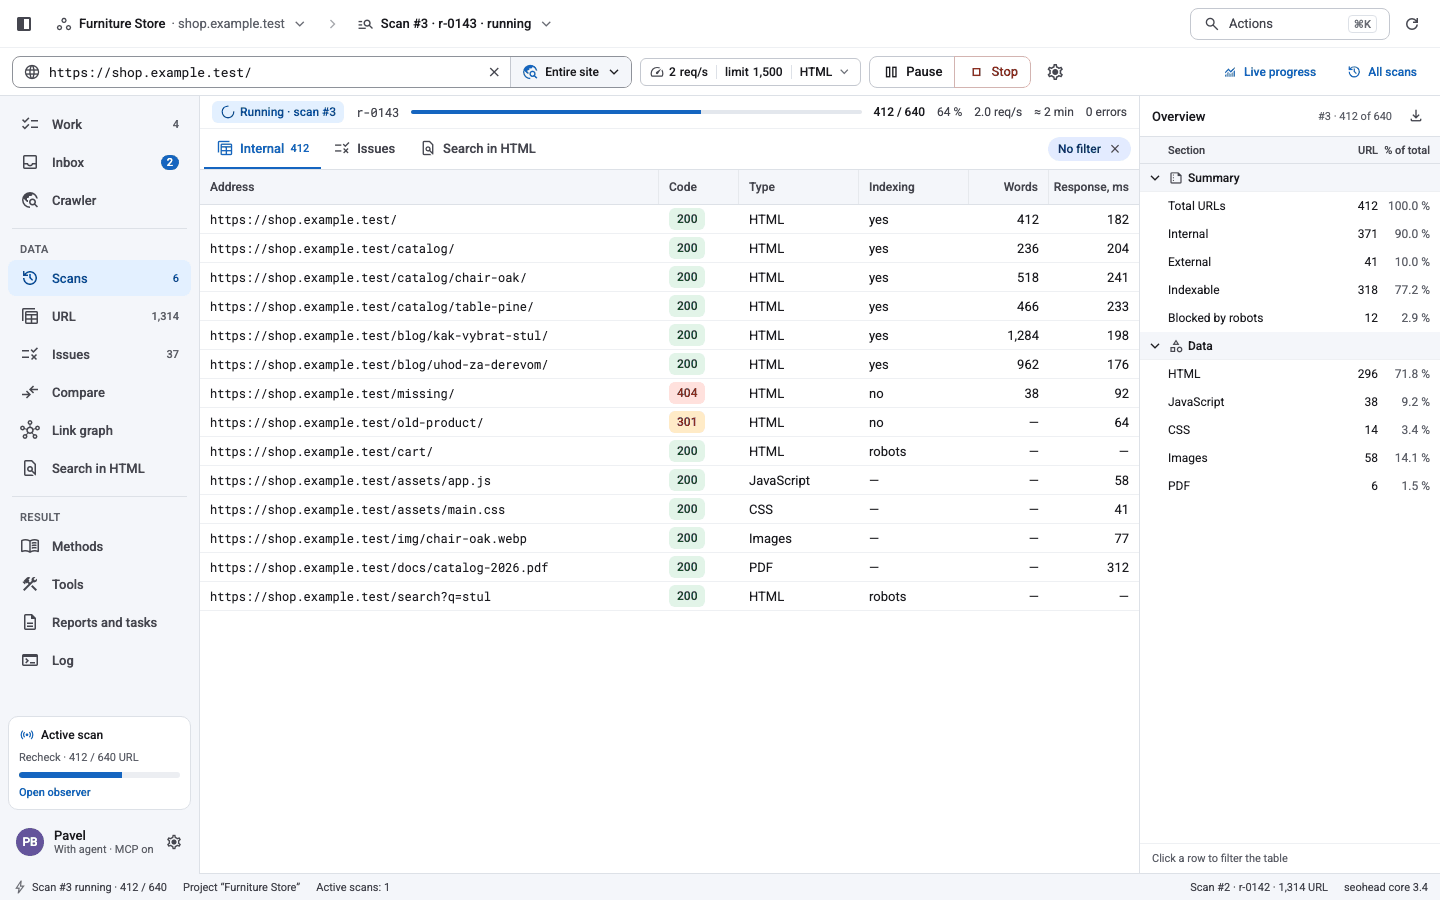
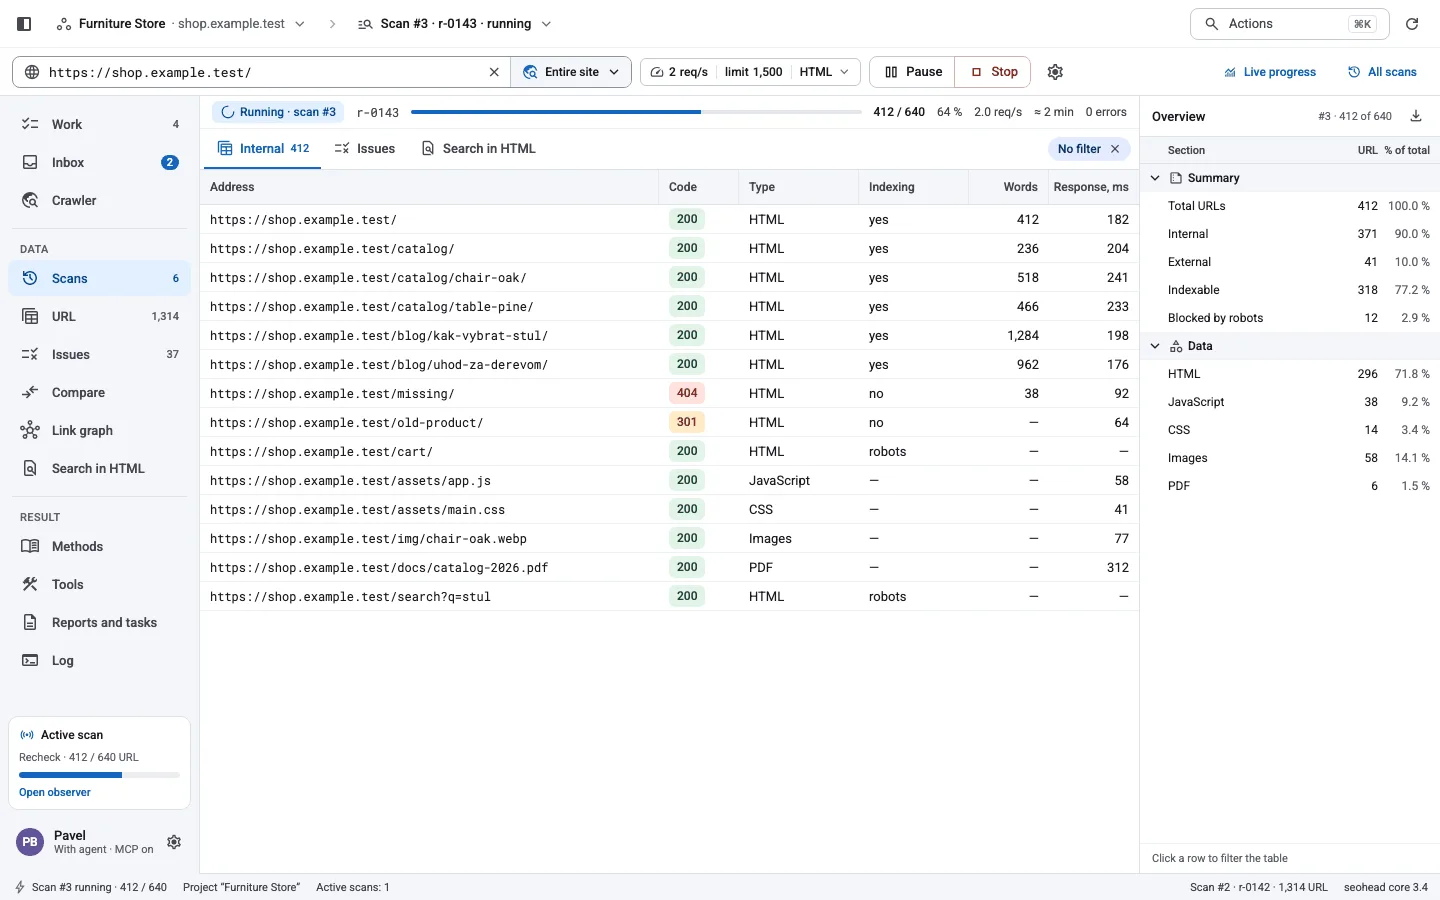
Mit einer URL starten, den Crawl beobachten
URL eingeben und auf Start klicken. Fortschritt live, die URL-Tabelle füllt sich, dazu die Scan-Übersicht – ein Projekt brauchen Sie erst, wenn Sie das Ergebnis behalten wollen.
- Rücksichtsvoll ab WerkEtwa zwei Anfragen pro Sekunde und Host, nur lesend.
- FortsetzbarEin unterbrochener Crawl läuft dort weiter, wo er stehen blieb.
- HTTP oder gerendertChromium nur, wenn eine Seite JavaScript braucht.
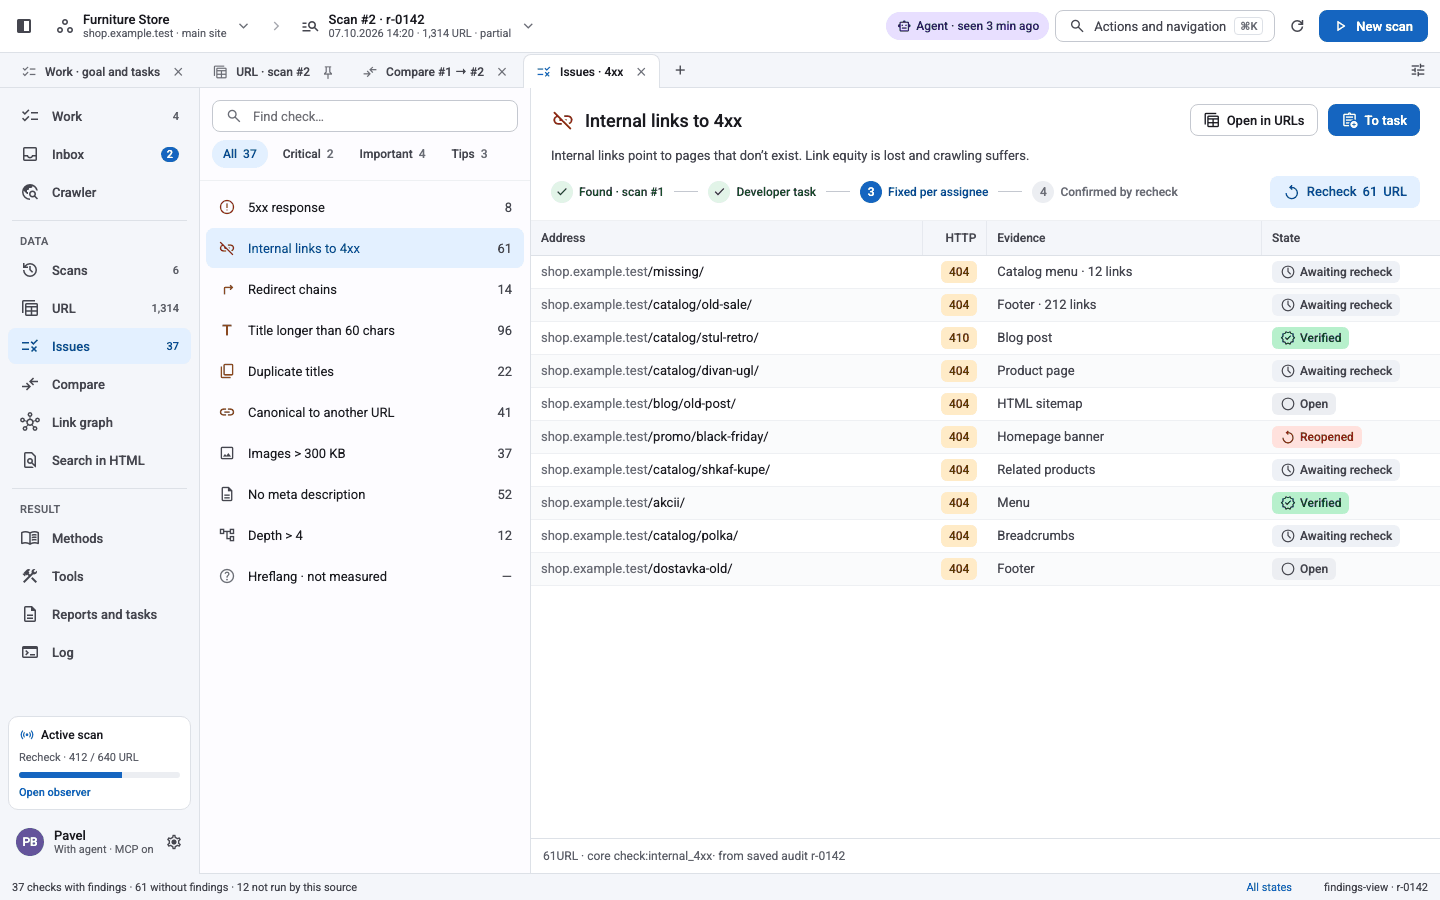
Probleme mit Beleg, nicht nach Gefühl
280 Prüfungen auf Basis derselben Belege. Jeder Befund nennt die betroffenen URLs, die Stelle auf der Seite und den Status der Nachprüfung.
- PriorisiertKritisch, wichtig und Tipps, mit Anzahl pro Prüfung.
- Nie ein falsches „alles gut“Befund, sauber durchgelaufen, übersprungen oder fehlgeschlagen – immer angegeben.
- Mit einem Klick zur AufgabeBefund direkt in die Aufgabenliste der Entwickler schicken.
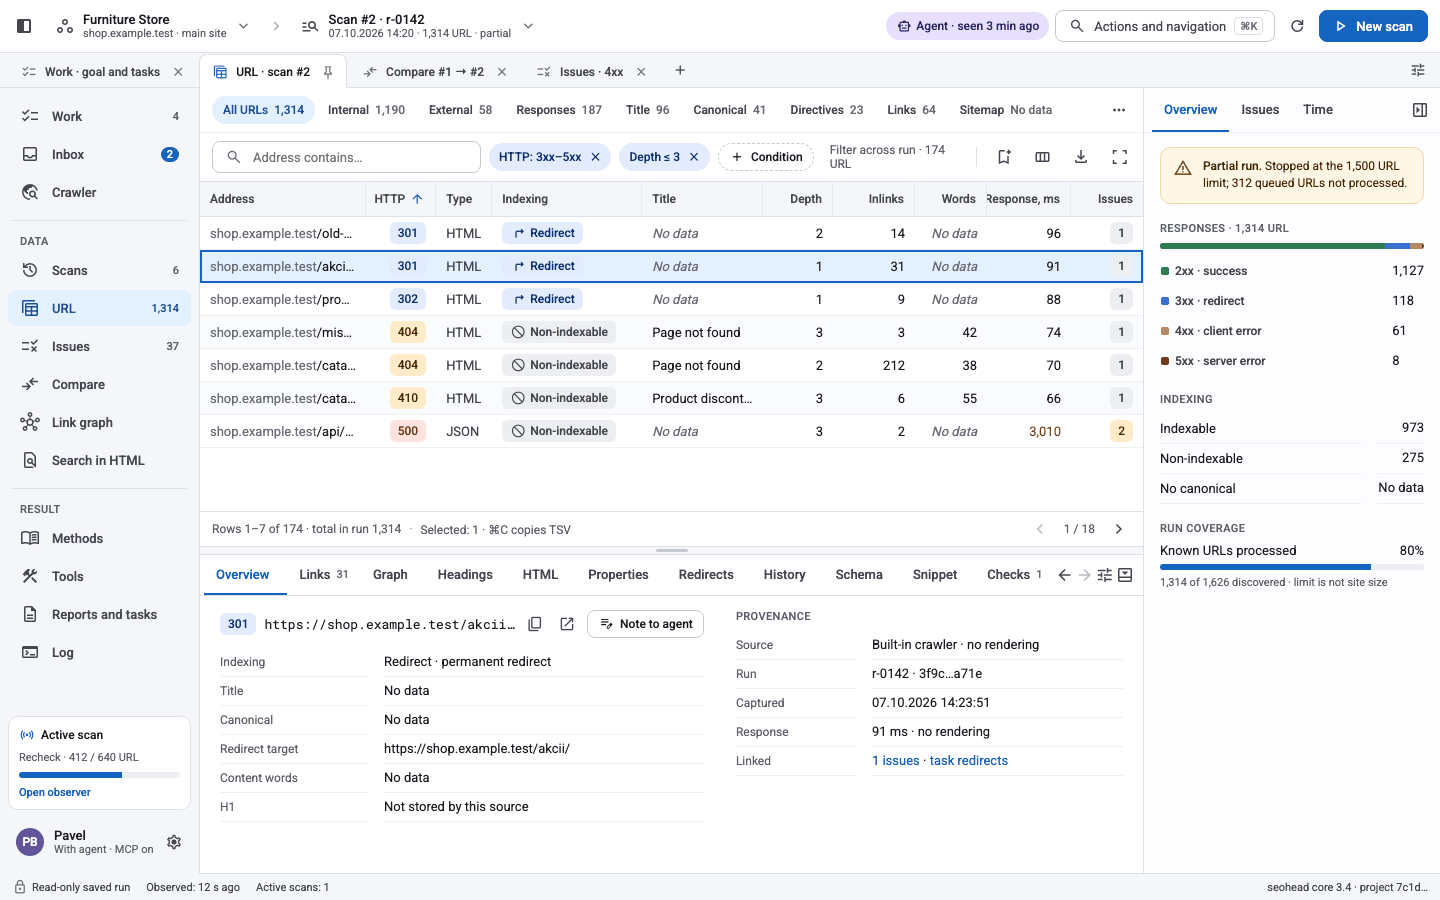
Jede URL, jedes Detail
Eine filterbare URL-Tabelle mit Status, Indexierbarkeit, Tiefe und Links. Öffnen Sie eine URL und sehen Sie Header, Weiterleitungen, strukturierte Daten und Verlauf.
- Filter, die sich kombinieren lassenHTTP-Klasse, Typ, Tiefe, eigene Bedingungen.
- HerkunftWelcher Scan und welche Quelle was gemeldet hat.
- URL-VerlaufDieselbe URL über alle gespeicherten Scans.
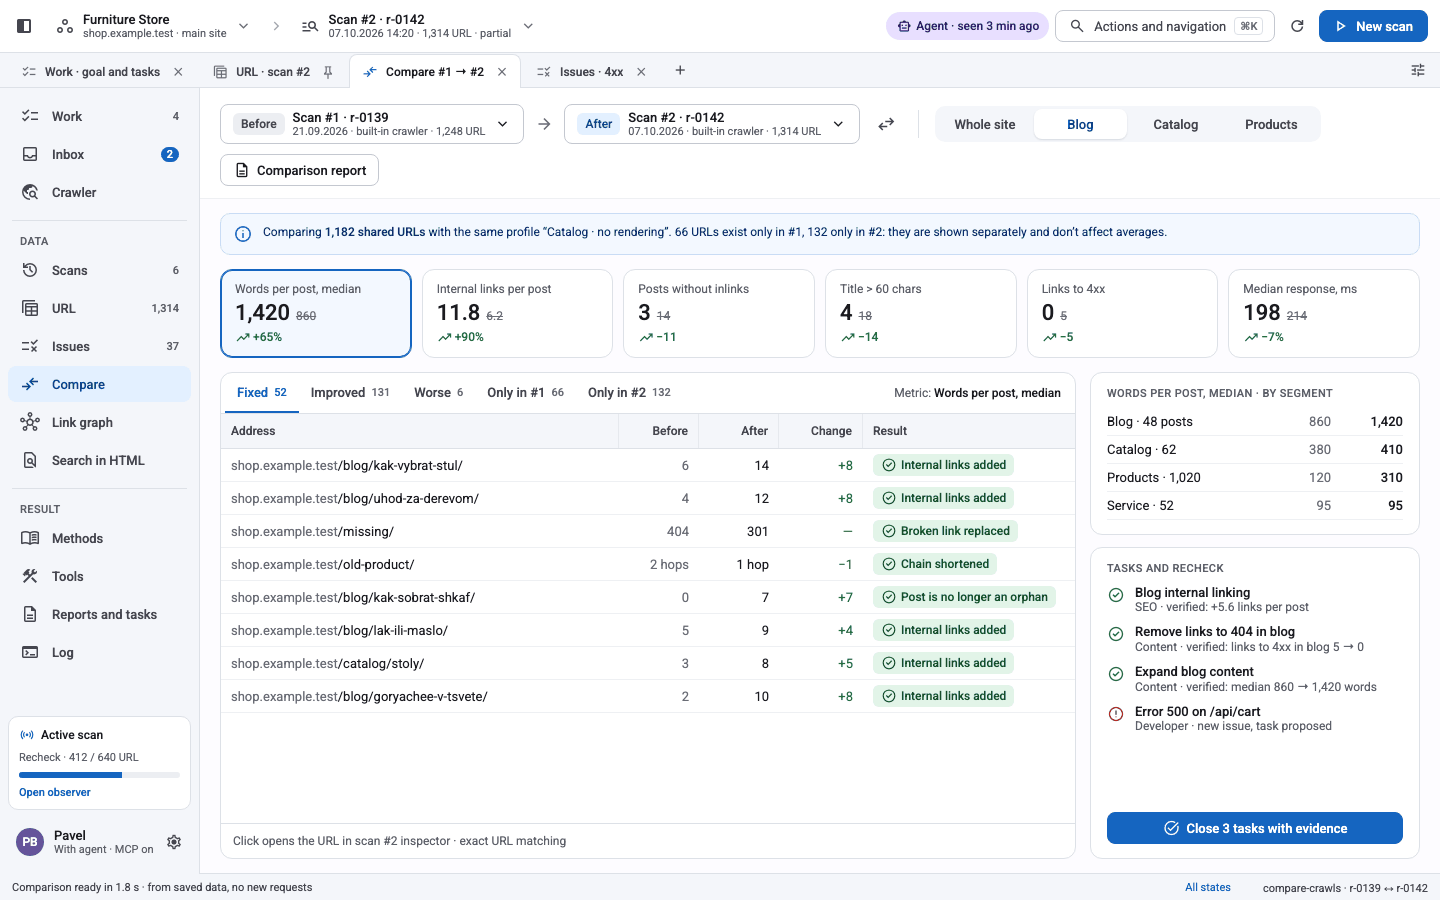
Vorher und nachher nebeneinander
Vergleichen Sie zwei Scans: Was ist behoben, was schlechter geworden, was neu? Aufgaben schließen sich selbst, sobald die Belege es zeigen.
- Diff nach Kennzahl und SegmentWörter, Links, Status – je Bereich der Website.
- Korrekturen verifizierenBegrenzte Nachprüfungen mit Korrekturprotokoll.
- MigrationenAlte und neue URL-Mengen zuordnen und prüfen.
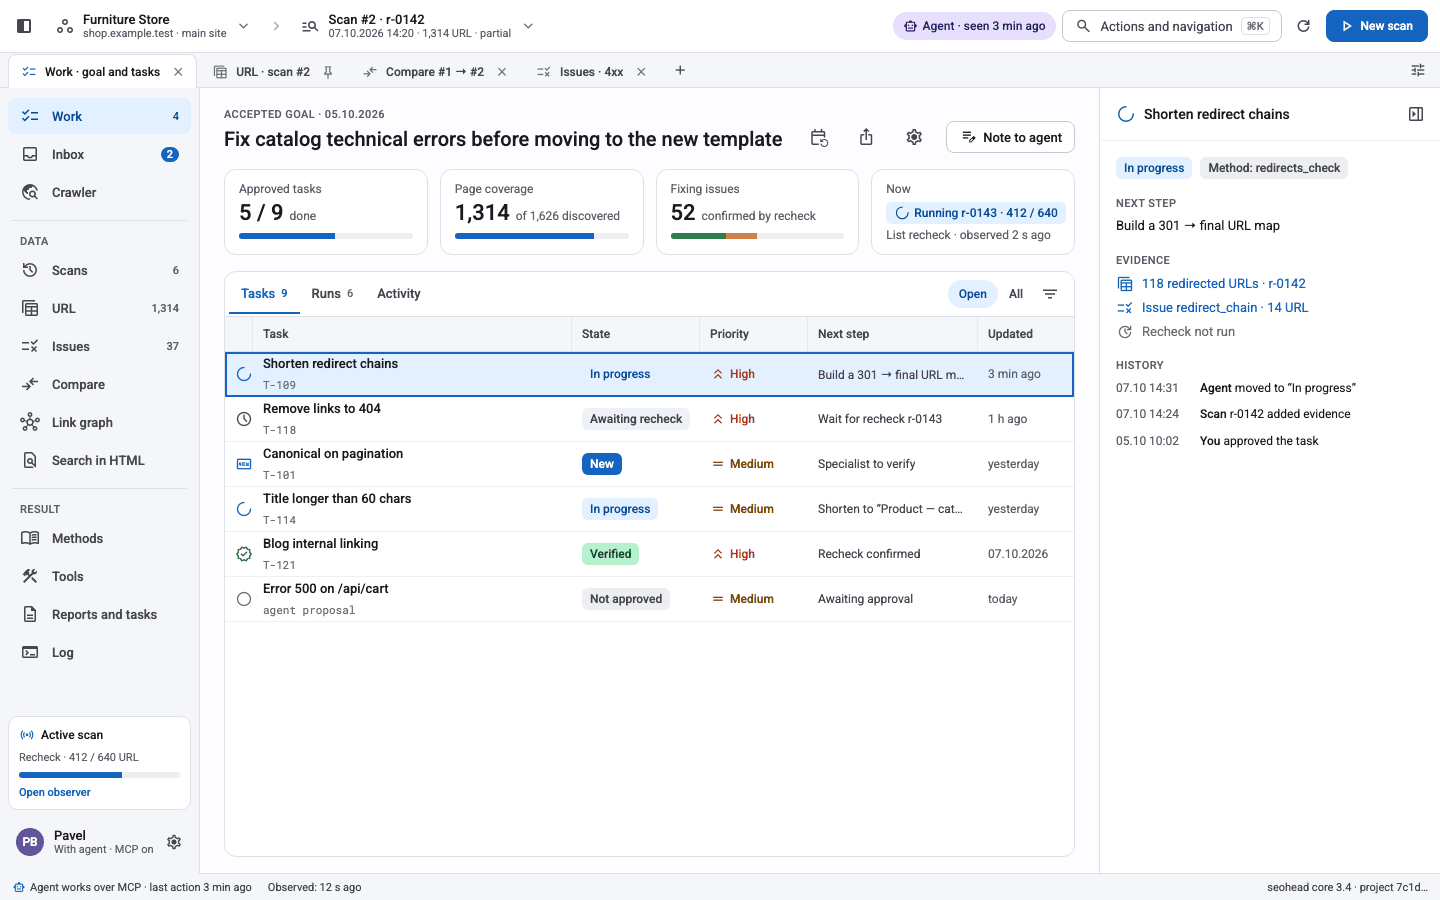
Aufgaben, mit denen Entwickler arbeiten können
Ein Projekt hält Ziel, freigegebene Aufgaben, nächste Schritte und Verlauf fest. Menschen und Agenten arbeiten mit derselben Liste.
- Ziel und FortschrittFreigegebene Aufgaben, Seitenabdeckung, bestätigte Korrekturen.
- Übergabe an AgentenEin Agent übernimmt den nächsten Schritt samt Belegen.
- Vollständiger VerlaufWer eine Aufgabe verschoben hat und warum.
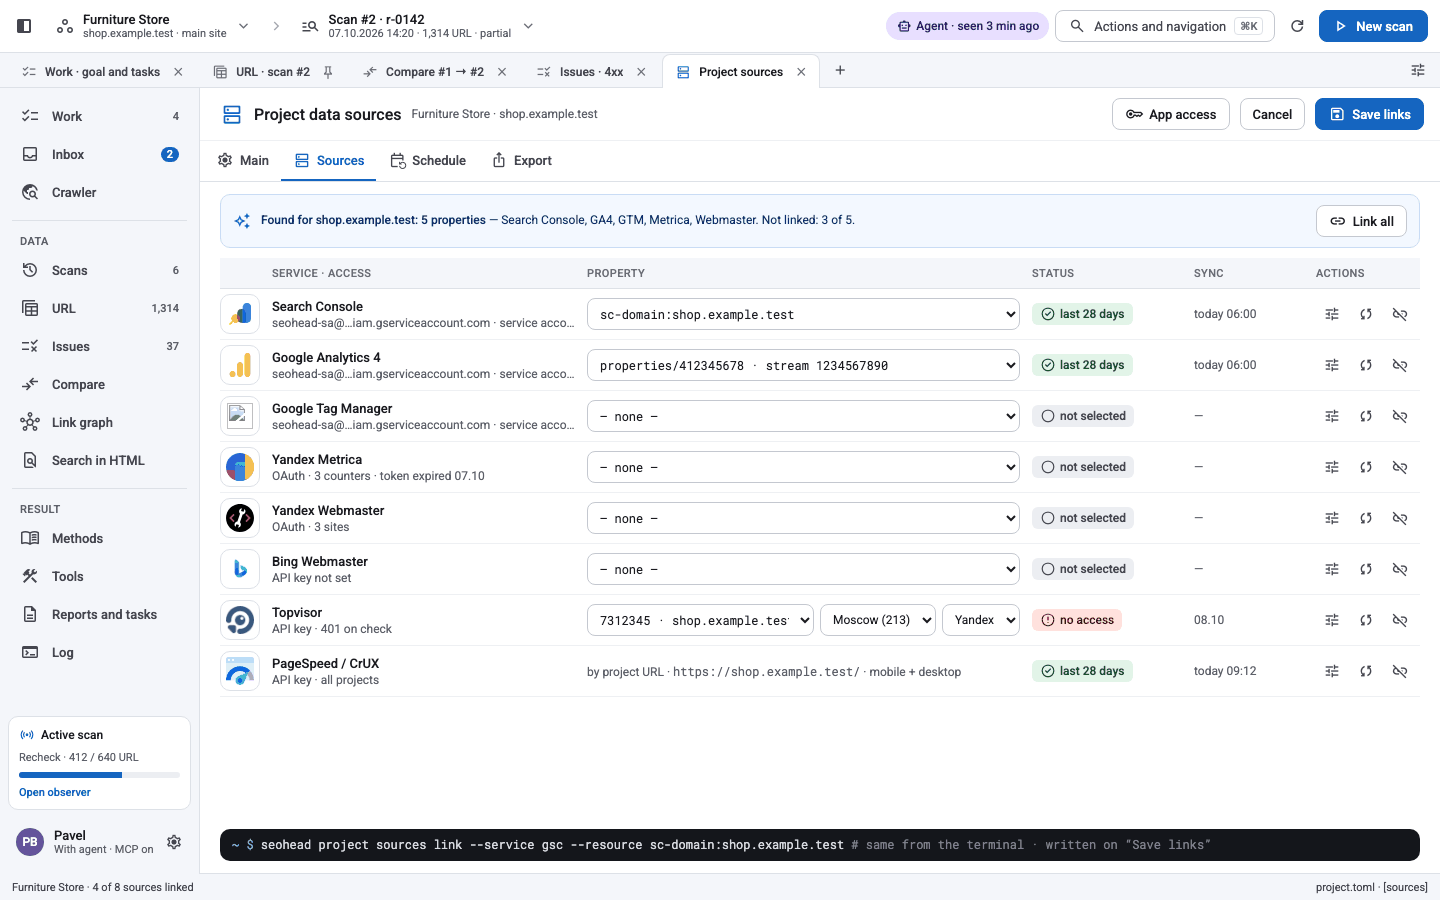
Search- und Analytics-Daten neben dem Crawl
Search Console, GA4, Yandex Metrika und Webmaster, CrUX – nur lesend, mit lokalem Verlauf und einem Kostenjournal für kostenpflichtige Anbieter.
- Ihre ZugangsdatenKostenpflichtige Anbieter laufen nur mit Ihrem Schlüssel und Ihrer Bestätigung.
- Mit URLs verknüpftKlicks und Impressionen direkt neben jedem Befund.
- Server-LogsWas Bots tatsächlich crawlen.
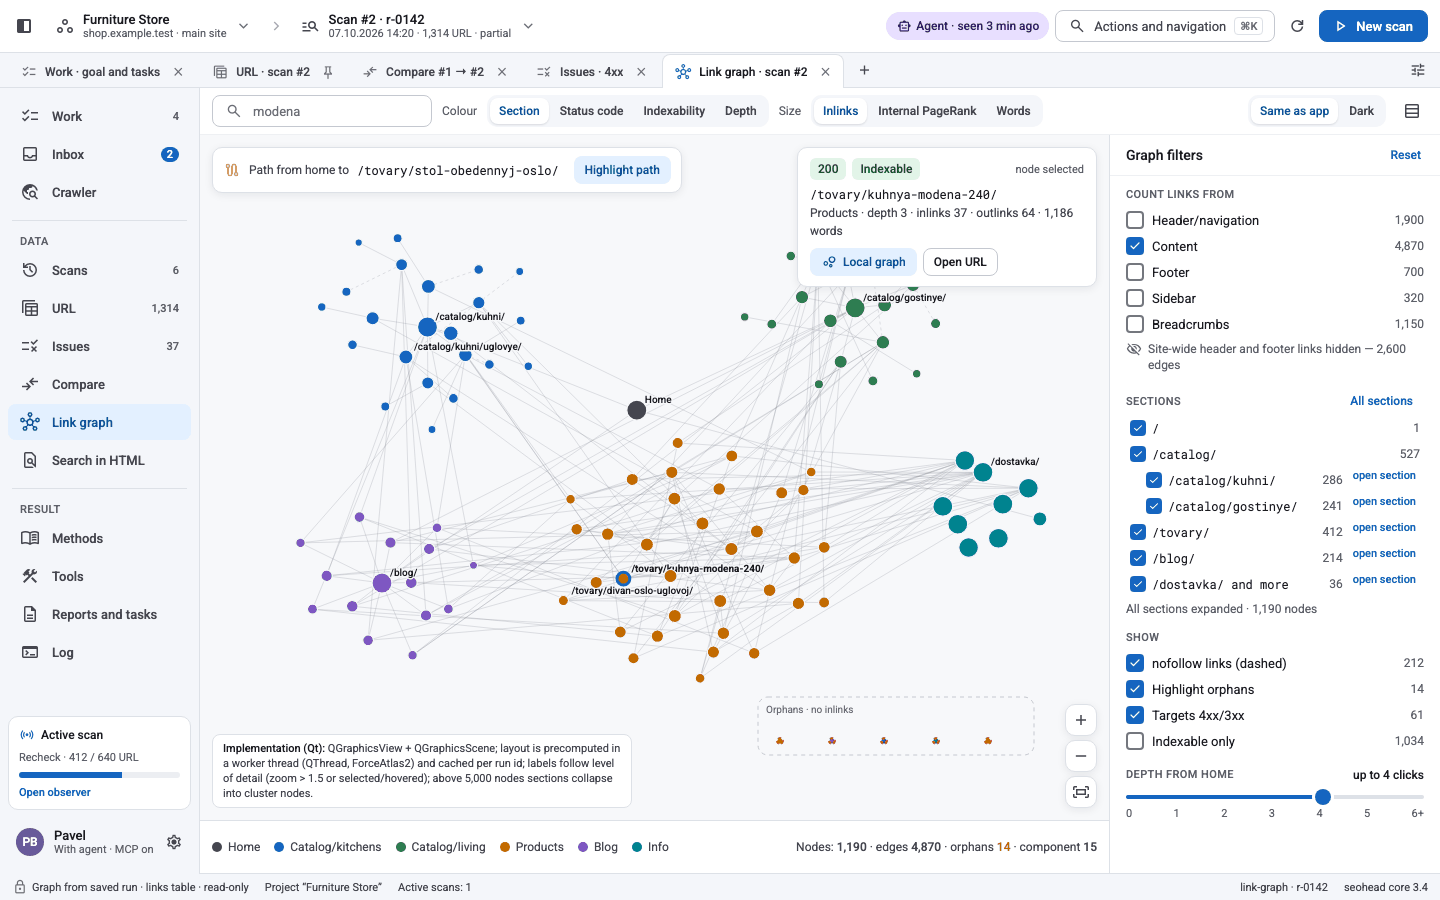
So ist die Website verlinkt
Interne Links nach Bereichen gruppiert, verwaiste Seiten und Pfade – aus demselben gespeicherten Scan, den auch das Audit nutzt.
- Bereiche und TiefeKlicks von der Startseite, Farbe nach Bereich.
- Verwaiste SeitenSeiten, die kein interner Link erreicht.
- PfadeWie ein Crawler von A nach B kommt.
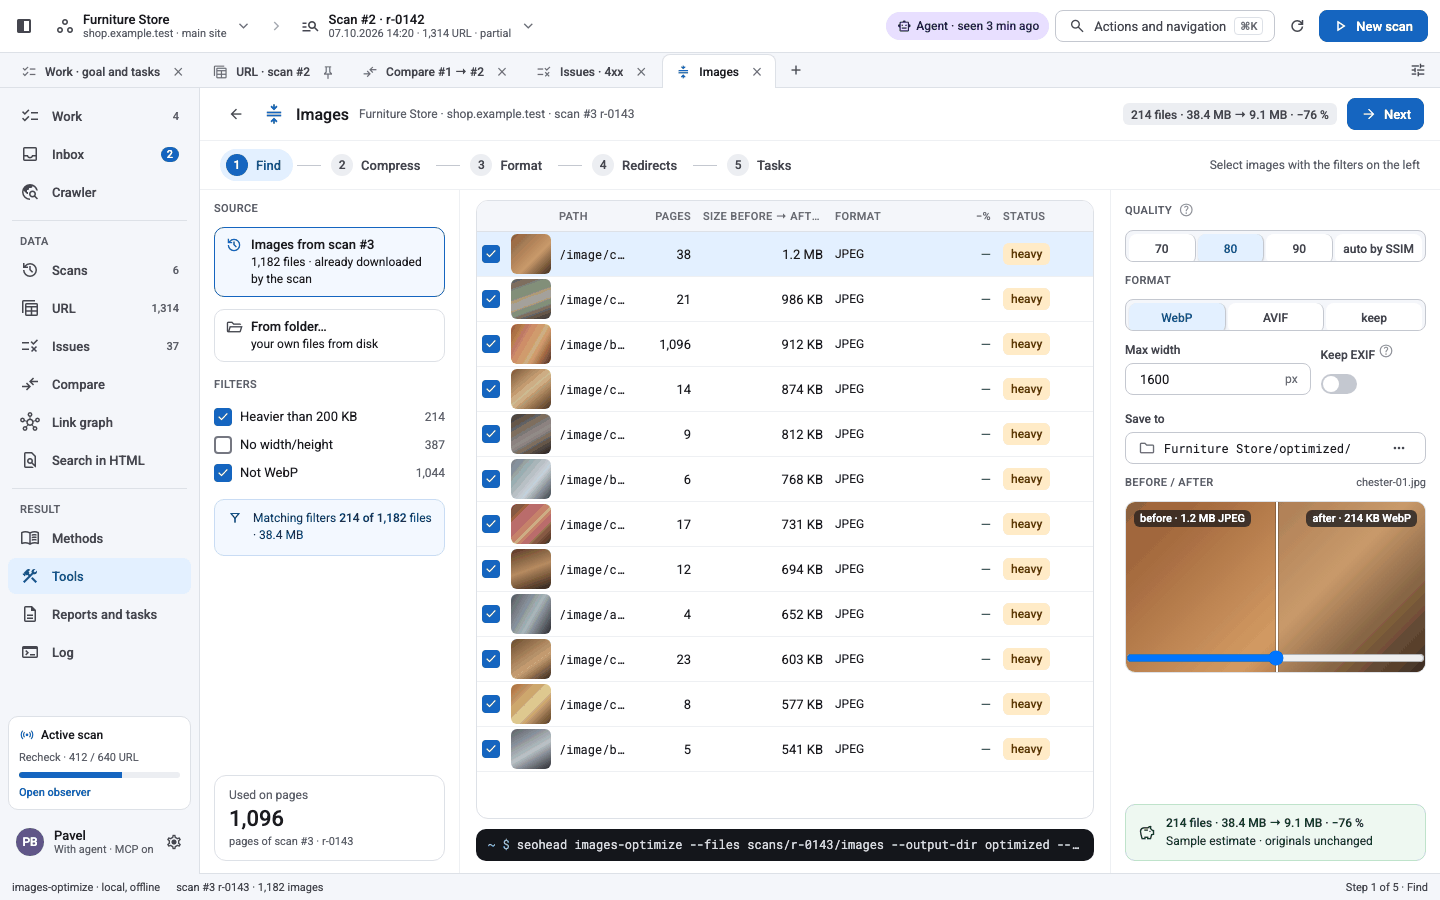
Beheben, exportieren, berichten
Jedes Kern-Tool hat ein fertiges Formular. Schwere Bilder komprimieren, 301-Weiterleitungen erzeugen, dann XLSX, DOCX, CSV oder PDF für Ihre Ansprechpartner exportieren.
- Bild-PipelineWebP/AVIF, Größen, Weiterleitungen und eine Aufgabe.
- KundenberichteBereitet vorhandene Belege auf und erfindet nie welche.
- Tool-KatalogAlle Tools durchsuchen und direkt auf den Scan anwenden.
230 Befehle, ein Toolkit
Über Crawl und Audit hinaus: Keyword-Recherche, Bildoptimierung, Domain-Recherche, eigene Datenanbieter, Monitoring und BI-Export.
Keywords und semantischer Kern
Keyword-Pool pro Projekt sammeln, bereinigen, clustern und erweitern.
Bildoptimierung
Schwere Bilder finden, komprimieren, WebP/AVIF, 301-Weiterleitungen.
Domain-Recherche
Tech-Stack, CDN, Spiegel, Subdomains, Wayback-Verlauf.
Eigene Datenanbieter
Eigene CSV-, XLSX- oder JSON-Dateien als Beleg neben dem Crawl nutzen.
Monitoring
Zeitgesteuerte Einzelprüfungen mit lokaler Zustellung.
BI-Export
Typisierte CSV-Partitionen für Sheets und BigQuery.
Korrekturprotokoll
Fälle, Nachprüfungen und Verifizierungsverlauf.
Alle Funktionen ansehen
230 Befehle · 246 MCP-Tools · 280 Prüfungen
Geben Sie Ihrem Agenten einen Crawler
Verbinden Sie den lokalen MCP-Server einmal. Claude – oder jeder andere MCP-Client – erhält 246 Tools, die crawlen, prüfen und berichten, mit denselben Belegen wie die App.
seo_crawl_siteCrawl ab Start-URLseo_site_auditAudit-Prüfungen ausführenseo_compare_crawlsZwei Scans vergleichenseo_gsc_querySearch-Console-Datenseo_report_buildXLSX, DOCX, PDFFünf Korrekturen nach Wirkung
- Weiterleitungsketten bei Katalog-URLs verkürzen
- Interne Links auf 404-Seiten korrigieren
- Canonicals auf paginierten Seiten ergänzen
- Titel mit mehr als 60 Zeichen kürzen
- Bilder über 300 KB komprimieren
Beispielausgabe. Aufgaben werden mit Belegen im Projekt gespeichert.
Drei Befehle bis zum Bericht
Python 3.10 oder neuer. Repository klonen, in einer virtuellen Umgebung installieren und starten:
seohead crawl-site --url https://example.com \
    --max-urls 500 --scan-out ./scans/audit.sqlite
Kostenlos, lokal und rücksichtsvoll: etwa zwei Anfragen pro Sekunde und Host. Das URL-Limit ist ein bewusst gesetztes Budget.
seohead sf run --exports-dir ./sf-exports \
    --out ./report --tasks
Sie haben schon Screaming-Frog-Exporte? Werten Sie sie offline aus – ohne Lizenz und ohne Anfrage an die Website.
seohead report-build --audit ./scans/audit.sqlite \
    --format xlsx --out report.xlsx
Eine Arbeitstabelle oder ein Kundendokument. Es bereitet Belege auf und erfindet keine Befunde.


SpiderHead holen
Starten Sie Ihr nächstes Audit lokal
Quellcode, Installer und die komplette Dokumentation finden Sie auf GitHub. Kern unter MIT-Lizenz, Desktop-App unter GPL.