
Technischer SEO-Audit

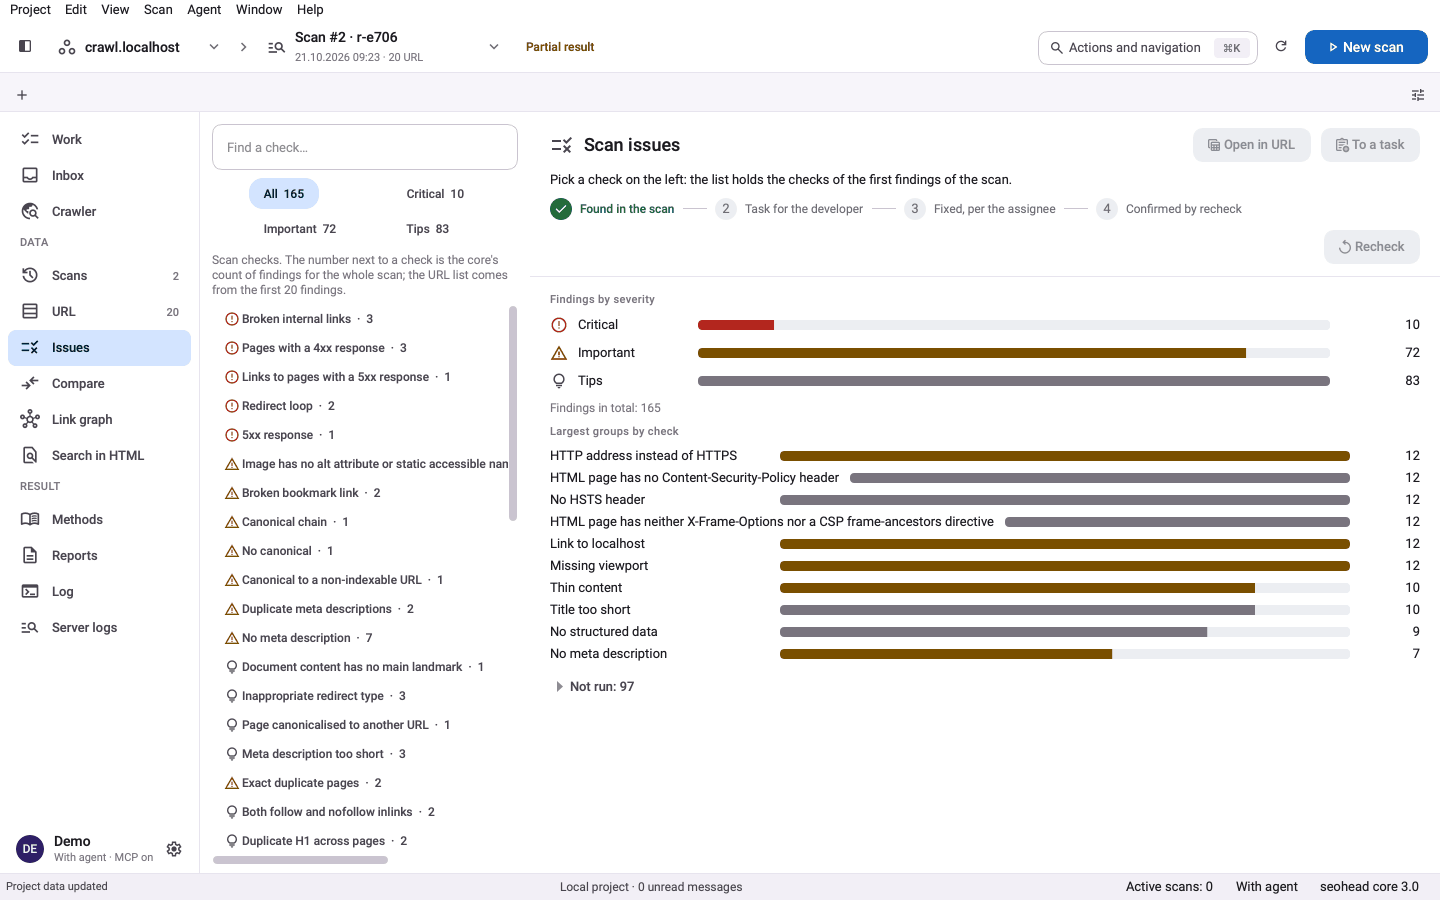
Ein einziges Prüfungsregister steuert jeden Audit, egal ob die Belege aus Screaming-Frog-Exporten oder aus einem SpiderHead-Crawl stammen. Schweregrad, Belegquelle und Korrektur kommen aus demselben Register, das auch die Regel-Engine liest. So behauptet ein Befund nie mehr, als die Engine belegen kann.

Was es leistet

Belege statt Vermutungen

Jeder Befund nennt die URL, das Beobachtete und eine Korrektur. Bei Link-Befunden zeigt er außerdem, wo auf der Seite der Link steht. Eine Prüfung ohne Daten wird mit Grund als übersprungen gemeldet, nie als bestanden.

  • Schweregrade: critical, warning und notice
  • Link-Position und XPath für Link-Befunde (aus den Inlinks-Exporten von Screaming Frog)
  • Jeder Befund enthält einen Korrekturtext aus dem Register

Ehrliche Abdeckung

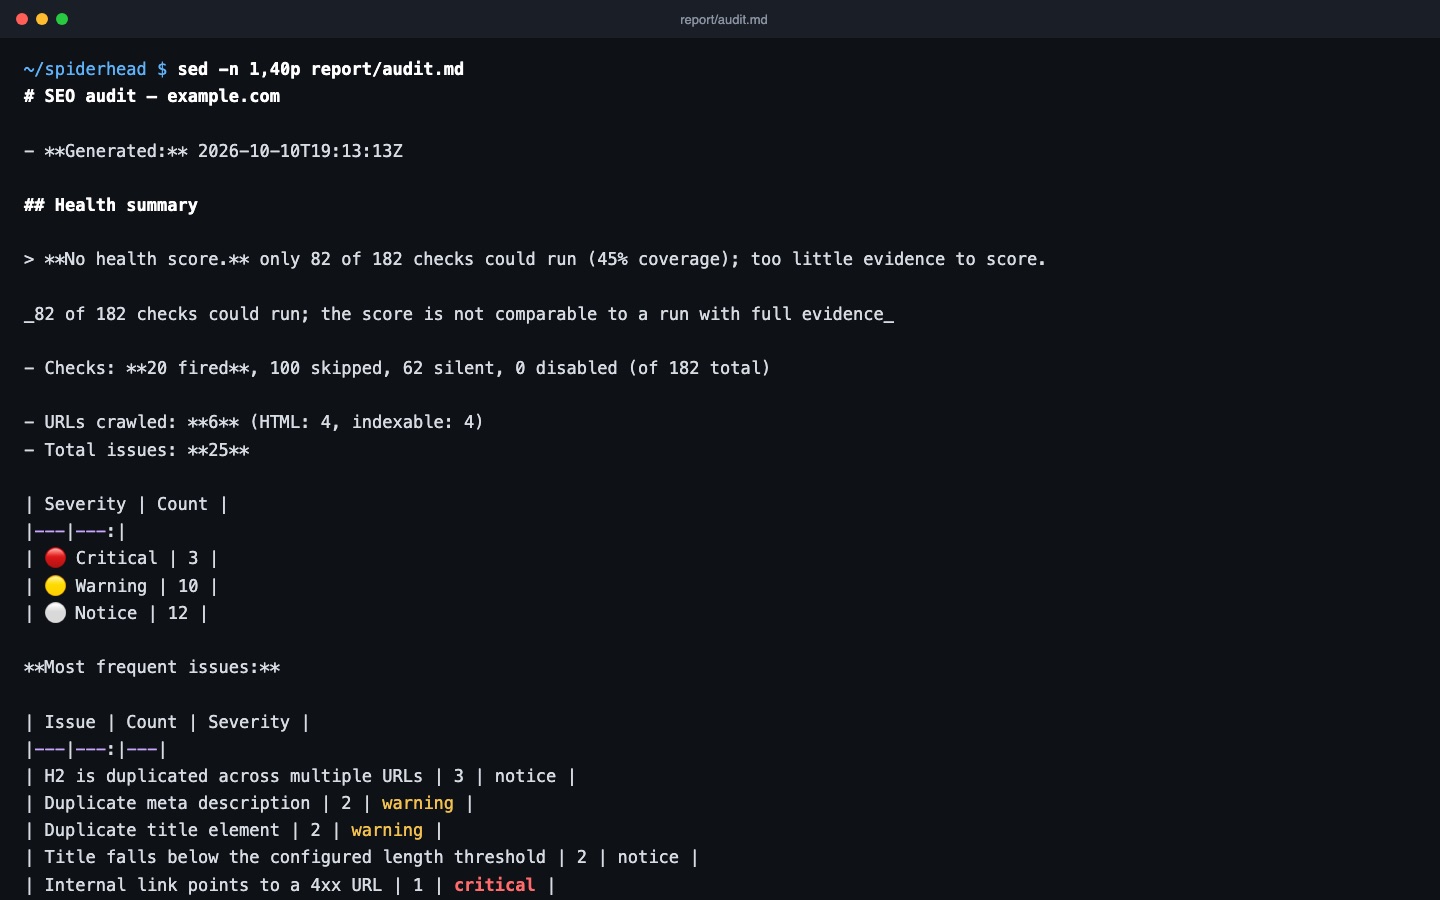
Der Bericht zählt, wie viele Prüfungen mit den gelieferten Belegen laufen konnten. Liegt die Abdeckung unter der Hälfte, wird der Health-Score zurückgehalten. Eine niedrigere Abdeckung markiert den Score außerdem als nicht vergleichbar mit einem Lauf mit vollständigen Belegen.

  • Übersprungene Prüfungen werden mit dem fehlenden Input aufgelistet
  • Kein Score aus zu wenigen Belegen
  • Mit mehr Exporten erneut ausführen, um die Abdeckung zu erhöhen

Von Befunden zur Aufgabenliste

Mit der Option --tasks schreibt der Audit zusätzlich tasks.json und tasks.md: eine priorisierte Liste für Entwickler, mit der Korrektur neben jedem Befund. Derselbe Audit kann einen CI-Build fehlschlagen lassen, wenn Befunde eines gewählten Schweregrads vorliegen.

  • Aufgabenliste als JSON und Markdown
  • Bei Befunden mit critical oder warning mit einem Exit-Code ungleich null fehlschlagen
  • Berichtsformate: json und md

Drei Schritte, ein gespeicherter Scan

  1. Exporte angeben

    Geben Sie einen Ordner mit CSV- oder XLSX-Exporten von Screaming Frog an. Jede Prüfung liest dasselbe Register, egal wie die Belege erhoben wurden.

  2. Jede Prüfung ausführen, für die die Belege reichen

    Jede Prüfung meldet entweder Befunde, bleibt ohne Auffälligkeiten oder wird mit Grund übersprungen, wenn ihr benötigte Daten fehlen.

  3. Korrekturen als Aufgabenliste erhalten

    Ergänzen Sie --tasks, um tasks.json und tasks.md zu erhalten, eine priorisierte Aufgabenliste für Entwickler mit der Korrektur neben jedem Befund.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
BROKEN_PAGE_4XXDie Seite antwortet mit einem 4xx-StatusCriticalExport Response Codes 4xx: URL und Status
SERVER_ERROR_5XXDie Seite antwortet mit einem 5xx-StatusCriticalExport Response Codes 5xx: URL und Status
TITLE_MISSINGDie Seite hat kein Title-ElementCriticalURL der Seite
BROKEN_INTERNAL_LINKEin interner Link zeigt auf eine URL mit 4xx-StatusCriticalQuellseite und Linkposition aus dem Inlinks-Export
H1_MISSINGDie Seite hat keine H1-ÜberschriftImportantURL der Seite
CANONICAL_MISSINGEine indexierbare Seite hat kein Canonical-TagImportantURL der Seite
THIN_CONTENTDie Seite hat eine geringe WortanzahlImportantURL und Wortanzahl
HEADING_BEFORE_H1Überschriften stehen vor der ersten H1 der SeiteTipÜberschriftenstruktur der Seite

Ein Befehl

bash
seohead sf run --exports-dir ./exports --out ./report --tasks

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Ein Ordner mit CSV- oder XLSX-Exporten von Screaming Frog oder eine Start-URL für einen Crawl
  • Die lizenzierte Screaming-Frog-CLI, nur für die Crawl-Modi von sf run
  • Keine API-Schlüssel für den Offline-Audit von Exporten

Grenzen

  • Prüfungen ohne die nötigen Belege werden übersprungen, nicht geschätzt
  • Können nur wenige Prüfungen laufen, wird der Score zurückgehalten oder als nicht vergleichbar markiert
  • Das Crawling über Screaming Frog braucht Ihre eigene lizenzierte Installation
  • Prüfungen gerenderter Seiten brauchen einen Rendering-Crawl, keine statischen Exporte

Fragen

Brauche ich dafür eine Screaming-Frog-Lizenz?
Zum Lesen von Exporten nicht. sf run --exports-dir analysiert vorhandene CSV- oder XLSX-Exporte von Screaming Frog offline. Das Crawling über die Screaming-Frog-CLI (--crawl) braucht eine lizenzierte Installation von Screaming Frog. crawl-site ist der eigene Crawler von SpiderHead und prüft sein Ergebnis mit denselben Prüfungen.
Was passiert, wenn eine Prüfung keine Daten hat?
Sie wird mit Grund als übersprungen gemeldet. Sie erscheint nie als bestanden.
Ändert der Audit meine Website?
Nein. Er liest Exporte oder gespeicherte Scans. Ein Crawl sendet schreibgeschützte Anfragen in dem Tempo, das Sie einstellen. Bei Screaming-Frog-Crawls legt --max-urls-per-second dieses Tempo fest; 1 bis 2 Anfragen pro Sekunde sind ein rücksichtsvoller Start.
Kann ein KI-Agent den Audit ausführen?
Ja. Derselbe Audit ist als MCP-Tools verfügbar: sf_audit_run, sf_audit_issues, sf_audit_summary und sf_audit_tasks.
Kann ich einen CI-Build bei Befunden fehlschlagen lassen?
Ja. --fail-on critical oder --fail-on warning gibt einen Exit-Code ungleich null zurück, wenn Befunde dieses Schweregrads vorliegen. Der Standard ist --fail-on none, ein einfacher Lauf schlägt also bei Befunden nicht fehl.
Wohin gehen die Ergebnisse?
In das Verzeichnis, das Sie mit --out angeben, als lokaler Bericht (json und md). Es wird nichts hochgeladen.

Testen Sie es auf Ihrer eigenen Website