
SEO-Toolkit für die Kommandozeile

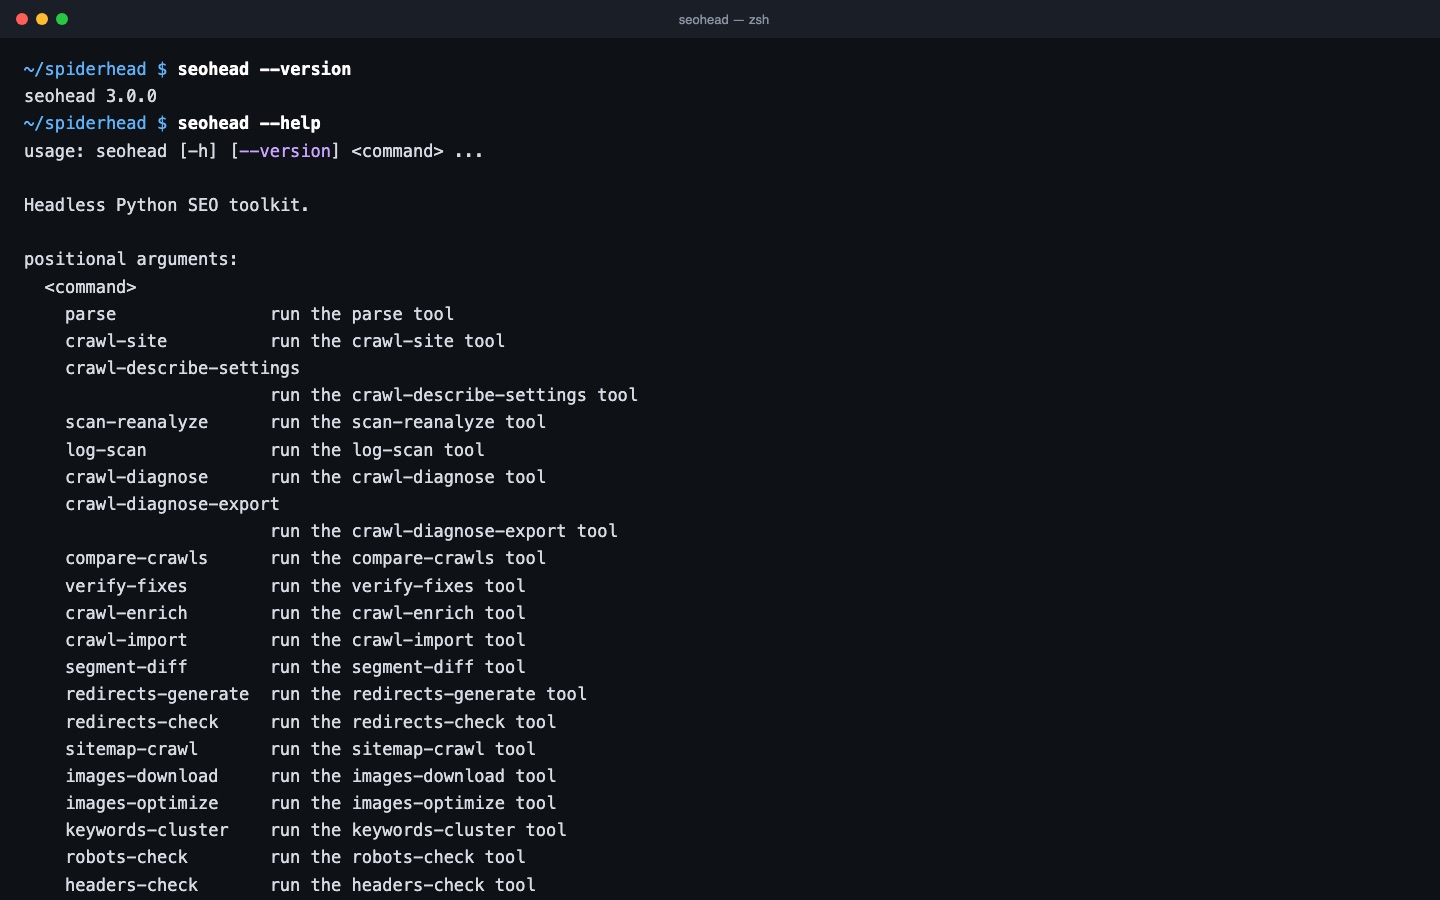
Der Befehl seohead stellt jedes Kernwerkzeug für Skripte, CI und die Arbeit im Terminal bereit. Die Befehle aus der Dokumentation werden in der CI geprüft.

Was es leistet

Skriptfähig

Die Ausgabe ist JSON auf stdout, sodass Sie sie an jq, ein Skript oder einen CI-Schritt weiterleiten können. Exit-Code 0 bedeutet, dass der Befehl abgeschlossen wurde, Exit-Code 1, dass er nicht zu Ende laufen konnte; der Grund steht im JSON. Eingaben können Flags sein, ein JSON-Objekt mit --input oder JSON über stdin. Die meisten Befehle, die Dateien schreiben, brauchen einen ausdrücklichen Pfad oder ein Flag wie --out oder --apply.

  • Explizite Budgets: crawl-site akzeptiert --max-urls, --max-depth und --max-urls-per-second
  • Exit-Code 2 verwendet nur log-scan, bei einem Lauf, dessen eigene Zahlen nicht zusammenpassen
  • Die Befehle aus der Dokumentation laufen in der CI gegen Testdaten

Befehlskatalog

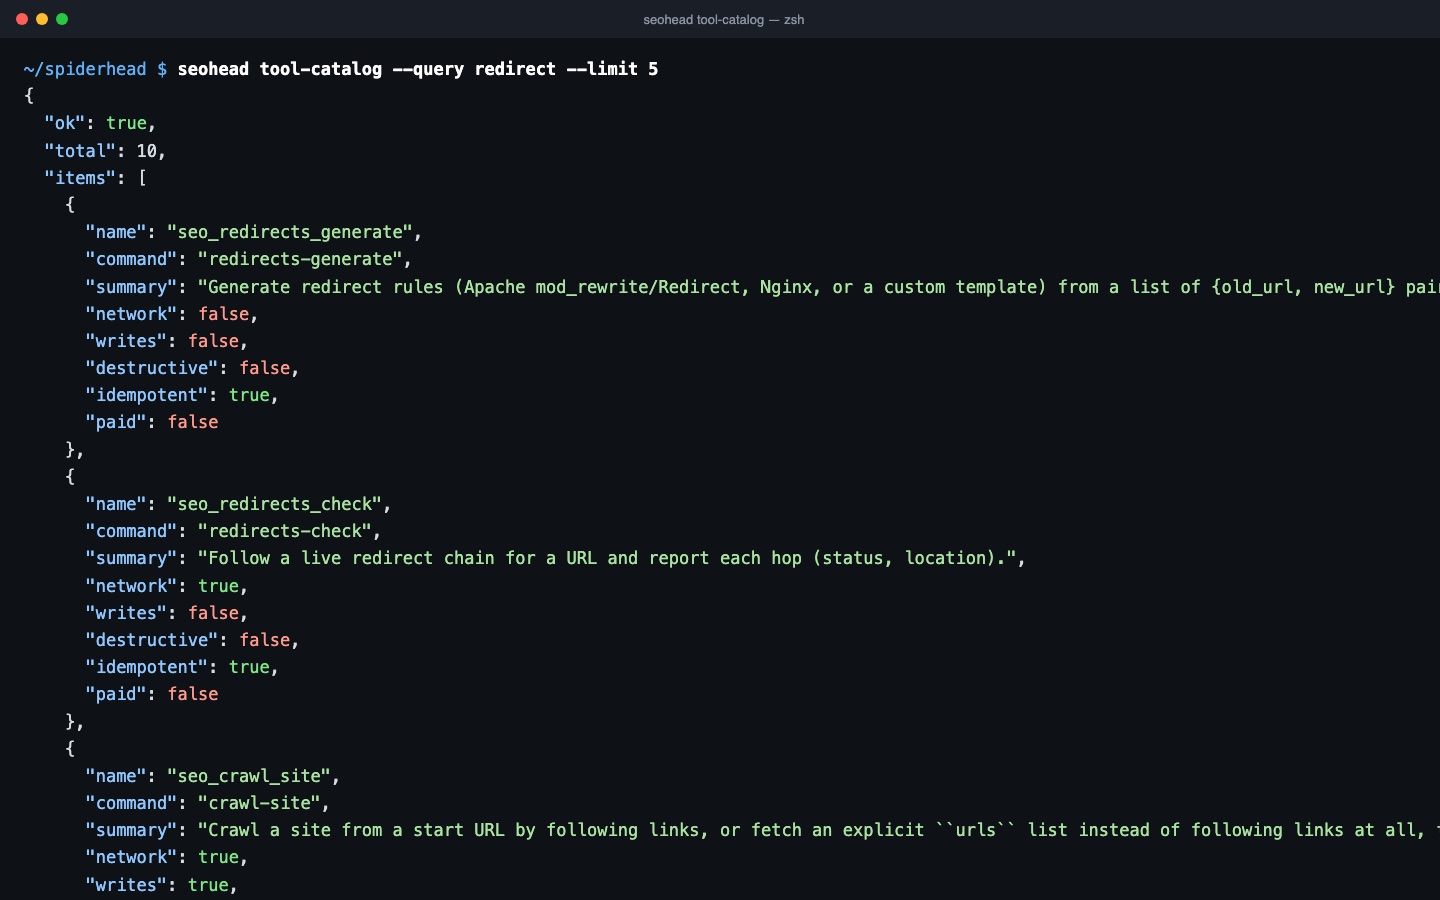
tool-catalog durchsucht, was jeder Befehl tut, ob er das Netzwerk nutzt, Dateien schreibt oder Geld ausgeben kann. Die Suche filtert, bevor Ergebnisse seitenweise ausgegeben werden, sodass eine Abfrage wie redirect eine kurze Liste liefert. Wenn Sie den Aufbau der Argumente brauchen, ergänzen Sie --include-arguments. Der Befehl funktioniert offline und schreibt nichts.

  • Die Auswirkung ist als offline, network, writes oder paid markiert
  • Kostenpflichtige Anbieter-Befehle zeigen eine Offline-Schätzung und brauchen eine ausdrückliche Bestätigung
  • seohead doctor prüft Python, Browser, MCP und SQLite-Voraussetzungen, ohne etwas zu schreiben

Ein Handler, zwei Schnittstellen

Jede öffentliche Funktion ist ein einziger Handler. Er ist als seohead-Befehl und als MCP-Tool mit demselben Namen verfügbar, sodass aus crawl-site seo_crawl_site wird. Was Sie im Terminal testen, ruft ein Agent auf. Gruppierte Formen sind Aliase: scan list ist scan-list.

  • seohead mcp startet den lokalen stdio-Server
  • Die sf-Befehle sind die Einstiegspunkte für den Audit-Workflow mit Screaming Frog
  • Die CLI läuft unter macOS, Linux und Windows aus einer virtuellen Umgebung

Drei Schritte, ein gespeicherter Scan

  1. Befehl auswählen

    Führen Sie seohead --help aus oder suchen Sie mit tool-catalog. Jeder Befehl hat eine Aufgabe und genau einen Eintrag im Katalog.

  2. JSON und Exit-Code lesen

    Die Ausgabe ist immer JSON auf stdout. Exit-Code 0 bedeutet, dass der Befehl abgeschlossen wurde. Exit-Code 1 bedeutet, dass er nicht zu Ende laufen konnte; der Grund steht im JSON.

  3. Dieselben Befehle für KI-Agenten

    seohead mcp startet einen lokalen MCP-Server. Jeder Befehl ist außerdem als Tool mit dem Namen seo_<command> verfügbar, zum Beispiel seo_crawl_site.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
BROKEN_PAGE_4XXDie Seite antwortet mit einem 4xx-Statuscode.CriticalAntwortcode pro URL aus crawl-site
SERVER_ERROR_5XXDie Seite antwortet mit einem 5xx-Statuscode.CriticalAntwortcode pro URL aus crawl-site
BLOCKED_BY_ROBOTSrobots.txt blockiert die URL.ImportantPassende robots.txt-Regel für die URL aus crawl-site
SITEMAP_URL_4XX_5XXDie Sitemap enthält eine URL, die mit 4xx oder 5xx antwortet.CriticalSitemap-Einträge aus sitemap-crawl
SITEMAP_DESYNCDie URL-Menge der Sitemap und die URL-Menge des Crawls stimmen nicht überein.ImportantSitemap aus sitemap-crawl im Vergleich mit crawl-site
URL_NOT_IN_SITEMAPEine indexierbare Seite fehlt in der Sitemap.TipCrawl-Ergebnis im Vergleich mit der URL-Menge der Sitemap

Ein Befehl

bash
seohead tool-catalog --query redirect --limit 5

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Python 3.10 oder neuer und eine virtuelle Umgebung mit installiertem Toolkit
  • Eine URL, eine gespeicherte Scan-Datei oder ein Projektordner, je nach Befehl
  • Optionale Zusatzpakete für MCP, Berichte, PDF und Rendering
  • Anbieter-Schlüssel nur für kostenpflichtige oder kontogebundene Befehle

Grenzen

  • Befehle, die als network markiert sind, senden Anfragen. Mit tool-catalog sehen Sie, welche das sind
  • Die Ausgabe ist zuerst für Maschinen gedacht. Abgesehen vom Terminal-Beobachter gibt es keinen interaktiven Dialog
  • Der native Crawl ist kein vollständiges Äquivalent zu Screaming Frog. Manche Prüfungen werden übersprungen und nie fälschlich als unauffällig gemeldet
  • Kostenpflichtige und kontogebundene Quellen brauchen Ihre eigenen Schlüssel, die das Toolkit nicht bereitstellt

Fragen

Braucht die CLI ein Konto oder einen gehosteten Dienst?
Nein. Die CLI läuft auf Ihrem Rechner. Offline-Befehle wie tool-catalog und die Befehle für gespeicherte Scans lesen nur lokale Daten. Befehle, die als network markiert sind, senden Anfragen an die Website oder an einen Datenanbieter.
Woran erkenne ich, ob ein Befehl Geld kostet?
Führen Sie tool-catalog aus. Jeder Eintrag zeigt, ob der Befehl das Netzwerk nutzt, Dateien schreibt oder Geld kostet. Kostenpflichtige Semantik-Befehle brauchen eine ausdrückliche Bestätigung; die MCP-Version verweigert die Ausführung ohne confirm_paid=true.
Verändert ein Crawl meine Website?
Nein. Crawls senden nur lesende Anfragen. Dateien werden nur in den Pfad geschrieben, den Sie angeben, etwa mit --scan-out oder --out-dir. Standardmäßig speichert ein Crawl seinen Scan unter ./scans/.
Was bedeutet ein Exit-Code ungleich null?
Exit-Code 1 bedeutet, dass der Befehl nicht abgeschlossen werden konnte. Im JSON steht dann ok auf false, oder eine Fehlerzeile geht auf stderr, wenn der Prozess abgestürzt ist. Exit-Code 2 verwendet nur log-scan.
Kann ich komplexe Eingaben ohne viele Flags übergeben?
Ja. Die meisten Befehle akzeptieren --input mit einem JSON-Objekt, das auf die Handler-Argumente abgebildet wird. Manche lesen JSON von stdin.
Welche Betriebssysteme werden unterstützt?
macOS, Linux und Windows verwenden dasselbe Python-Paket. Unter Windows verwenden Sie ausdrücklich den Interpreter in der virtuellen Umgebung. Die CI führt die Windows-Prüfungen für Locks, Projekte, Scans und eine echte MCP-Sitzung aus.

Testen Sie es auf Ihrer eigenen Website