Yandex Wordstat
collect · synonymsBasisfrequenz, Verfeinerungen und ähnliche Anfragen über die Yandex-Cloud-API. API-Schlüssel und Folder-ID; Kontingent pro Stunde.
Keyword-Pool pro Projekt sammeln, bereinigen, clustern, erweitern: Wordstat, SERP-Cluster, exakte Frequenz, Mining – vor jedem bezahlten Aufruf ein Offline-Plan.
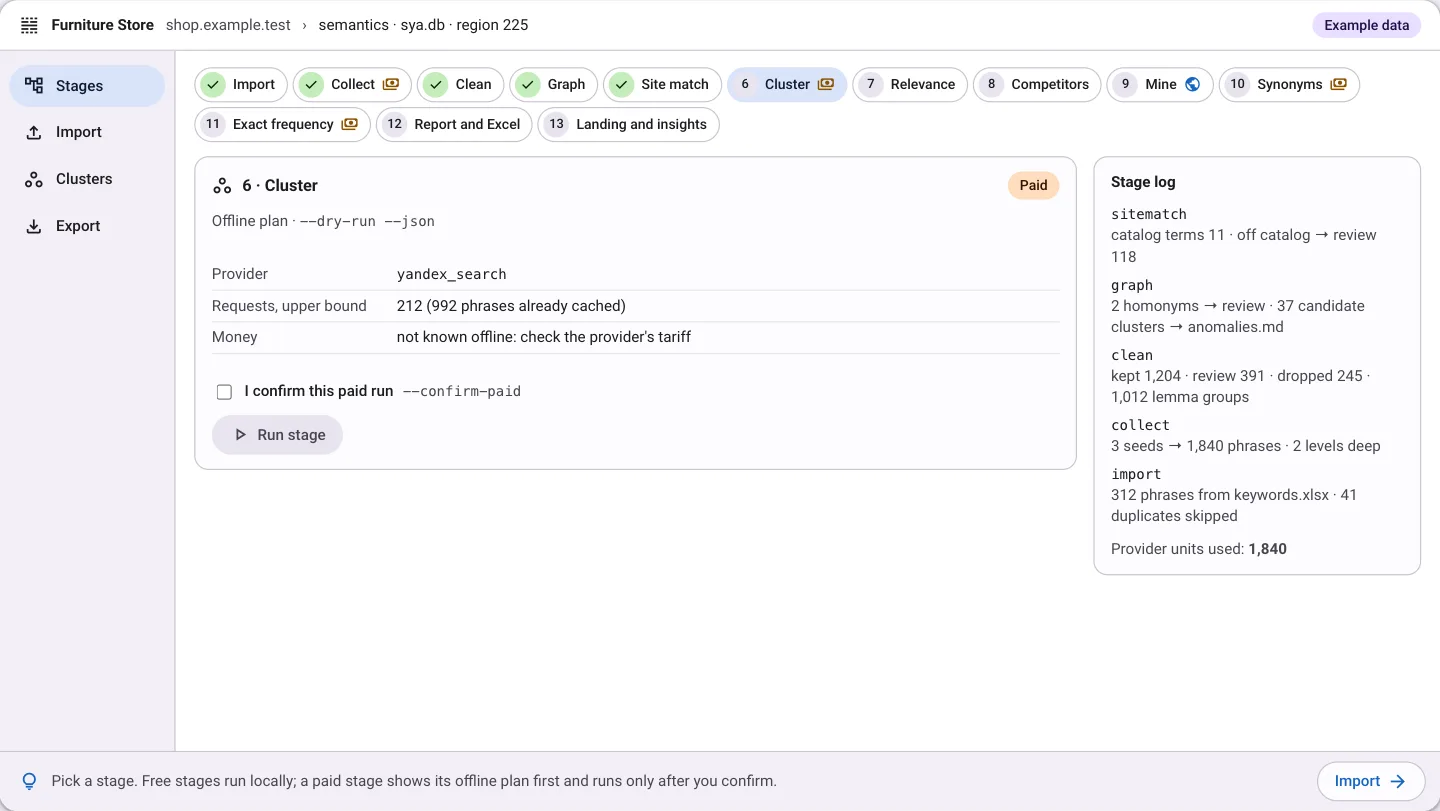
Jede Stufe ändert einen Status und hält den Grund fest: Eine Phrase wird nie gelöscht, und jede Entscheidung bleibt nachvollziehbar. Kostenlose Stufen liegen zwischen den bezahlten, sodass Sie den Pool prüfen, bevor Sie die nächste Antwort kaufen.
Bringen Sie mit, was Sie schon haben: eine CSV oder ein Blatt einer XLSX. Ordnen Sie query, frequency, group, subgroup, URL und comment zu und wählen Sie dann add, update oder replace. Die Vorschau zeigt neue, vorhandene und doppelte Zeilen, bevor etwas geschrieben wird.
phrasesErweitert Ihre Seeds je Region und erweitert starke Phrasen erneut bis zur eingestellten Tiefe. Die Warteschlange ist dedupliziert, und --resume setzt einen unterbrochenen Lauf fort, ohne dieselbe Phrase erneut anzufragen.
phrases, expansions, provenanceWendet die Projektfilter an (Intent, Stoppwörter, informationale Muster), markiert Frequenzausreißer und gruppiert Phrasen nach Lemma. Eine Phrase mit beobachteten Impressionen oder Positionen wird nie durch Frequenzregeln entfernt.
status, route, lemma groupBaut einen Wortgraphen des Pools. Homonym-Kandidaten gehen zur Prüfung, Kandidaten-Cluster landen in anomalies.md – bevor Sie noch etwas bezahlen.
anomalies.mdEine Phrase gehört nur dann in den Kern, wenn die Website sie anbietet. Phrasen ohne einen Begriff aus catalog.txt gehen als Off-Katalog zur Prüfung.
review listHolt pro Phrase eine Top 10 und cacht sie, sodass ein erneuter Lauf nur neue Phrasen bezahlt. Phrasen mit gemeinsamen Seiten bilden einen Cluster; --method louvain gruppiert die gecachten Ergebnisse neu, um lange Ketten aufzubrechen.
SERP cache, clusters, landing candidatesTaucht in der Top 10 einer Phrase keine Website Ihrer Art aus vendors.txt auf, liegt das Thema wahrscheinlich außerhalb des Fokus. Die Phrase geht zur Prüfung; gelöscht wird nichts.
review listLiest die gecachten Ergebnisse: welche Domains Ihre Cluster besetzen und welche Wörter sie in Titeln nutzen. Kandidaten gehen in synonyms.txt.
competitors.md, synonyms.txtÖffnet die häufigsten Wettbewerberseiten aus den gesammelten Ergebnissen und liest Title, Description, H1 und die ersten H2-Überschriften. Thematische Zwei- und Dreiwortphrasen gehen in synonyms.txt.
competitor_mining.md, synonyms.txtPrüft die Kandidaten in synonyms.txt. Nur Phrasen mit Nachfrage kommen in den Kern; danach lässt collect --resume den Pool daraus wachsen.
checked phrasesKauft die exakte !W-Frequenz einmal pro Lemma-Gruppe, am Ende, wenn sich der Pool nicht mehr ändert. Oberhalb der Budgetgrenze des Projekts braucht es --yes.
exact frequency, task receiptsreport.md und clusters.csv zum Lesen, eine XLSX-Arbeitsmappe (Summary, Core, Info, Clusters, Rejected) für den Kunden, pool.csv und pool.json für andere Tools.
report.md, XLSX, CSV, JSONNach dem Start wählen Sie für jeden Cluster die Landingpage aus gemessenen Kandidaten, lesen dann wöchentliche Cluster-Signale aus Ihren lokalen Daten von Search Console, Webmaster und Metrika und machen ausgewählte zu Checklisten-Aufgaben.
landing, weekly signals, tasksDer Kern wird nicht einmal gesammelt. Wettbewerber und Mining liefern neue Kandidaten, die Synonym-Stufe prüft sie, das Sammeln wird fortgesetzt und das Clustern läuft erneut. Die exakte Frequenz wird zuletzt gekauft.
collectclean · graph · site matchclustercompetitors · minesynonymscollect --resumeexact, oncereportDie Sammel-Pipeline läuft auf Yandex-Daten. Google-Nachfrage, Rank-Tracking und Search Analytics sind eigene Toolkit-Befehle, die neben dem Kern arbeiten.
collect · synonymsBasisfrequenz, Verfeinerungen und ähnliche Anfragen über die Yandex-Cloud-API. API-Schlüssel und Folder-ID; Kontingent pro Stunde.
clusterEine Top 10 pro Phrase und Region, gecacht mit Abrufzeit und Region. Nur der asynchrone Endpunkt.
exactDie exakte !W-Frequenz, die die Wordstat-API nicht liefert. Abgerechnet wird beim Anlegen der Aufgabe; die task_id bleibt gespeichert, ein Ergebnis nach Timeout wird also erneut abgeholt, nicht erneut gekauft.
google-keywordsGoogle-Suchvolumen, Wettbewerb und Seed-Erweiterung. Standardmäßig Sandbox.
keywords-expand · keywords-seasonality · regions-treeEine Phrase erweitern, ihre Nachfrage nach Monaten lesen, den Regionenbaum durchsuchen (der Baum ist kostenlos).
topvisor-readLiest Projekte, Keywords und gespeicherte Positionsverläufe aus Ihrem bestehenden Konto. Bezahlte Prüfungen lassen sich nicht aus dem Toolkit starten.
semantics insightsWöchentliche Cluster-Signale aus Daten, die das Toolkit bereits lokal synchronisiert hat. Der Insights-Schritt selbst ruft keine Anbieter auf.
Jede bezahlte Stufe hat einen Offline-Plan: die Region, die Suchmaschine, die Anfragequelle und eine Obergrenze für Anfragen oder Aufgaben. Ein Plan erzeugt keinen Anbieter-Client.
--dry-run --json gibt den Plan aus. Der Lauf selbst braucht --confirm-paid, auch wenn die Schätzung null ist.
Wordstat-Versuche, SERP-Abrufe und Arsenkin-Aufgaben werden vor dem Aufruf reserviert. Eine unklare Anfrage wird nie automatisch erneut gesendet.
Gecachte SERPs und Belege bezahlter Aufrufe überstehen ein Ersetzen des Pools, sodass erneutes Clustern nur neue Phrasen bezahlt.
Jede Abbuchung landet in spend-report, mit dem semantischen Projekt und der Stufe, zu der sie gehört.
Lässt sich der Preis eines Anbieters offline nicht ermitteln, sagt der Plan das, statt eine Zahl zu raten.
Aufgenommen am synthetischen Beispielprojekt, das mit dem Toolkit mitgeliefert wird. Seine Phrasen sind russisch, wie die Yandex-Nachfrage, und seine Frequenzen sind erfunden. Es wurde kein bezahlter Aufruf gemacht.
$ seohead semantics clean --project ./core
$ seohead semantics graph --project ./core
$ seohead semantics sitematch --project ./core
clean: kept=34 review=4 dropped=3 | lemma groups=41 (median base=720, outlier>36000)
graph: homonyms=0, to review=0, candidate clusters=7 -> anomalies.md
sitematch: catalog terms=11 | off-catalog->review=8 | kept and matching the site=26$ seohead semantics cluster --project ./core --dry-run
"mode": "estimate", "stage": "cluster", "paid": true,
"provider": "yandex_search",
"request_estimate": {"unit": "requests", "count": 26, "kind": "upper_bound"},
"money_estimate": null,
"money_unavailable_reason": "provider pricing is not available from this offline preflight",
"paid_calls_made": 0$ seohead semantics status --project ./core
dropped=3 | kept=26 | review=12 | _total=41 | _exact=0 | _expanded=0 | _clusters=0
provider units: {'yandex_requests': 0, 'arsenkin': 0}
next: seohead semantics exact --project ./core$ seohead semantics export --project ./core --scope no-landing --dry-run
"mode": "preview", "scope": "no-landing", "rows": 41,
"planned_files": ["core/semantics/pool.csv", "core/semantics/pool.json"]seohead semantics status --project ./my-coreZuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.
Zehn MCP-Tools bieten dieselben Stufen und Lesezugriffe. Ein bezahlter Aufruf liefert den Plan und braucht confirm_paid=true, um Arbeit zu senden.
seo_semantics_statusZähler, Anbieter-Einheiten und die nächste Stufeseo_semantics_runKostenlose Stufenseo_semantics_mineWettbewerberseiten, kein Anbieter-Kontingentseo_semantics_paidBezahlte Stufen: erst der Plan, dann confirm_paid=trueseo_semantics_clustersSeitenweise Clusterlisteseo_semantics_cluster_showEin Cluster mit seinen Landingpage-Belegenseo_semantics_cluster_queriesPhrasen eines Clusters mit der gespeicherten Top 10seo_semantics_set_landingLandingpage zuweisen oder entfernenseo_semantics_insightsWöchentliche Signale nach Cluster und Quelleseo_semantics_insights_tasksAusgewählte Signale in die Checkliste