
Canonical-Tag-Prüfung

Canonical-Prüfungen laufen seitenweise und als Graph über den gesamten Crawl: Ketten, Canonicals auf Weiterleitungen oder Fehler, relative, Fragment- oder mehrfache Canonicals sowie Ziele, auf die kein Link verweist.

Was es leistet

Tags pro Seite

Das Canonical jeder Seite wird einzeln gelesen und geprüft. Fehlende, relative, mehrfache oder Fragment-Werte werden gemeldet, ebenso ein Canonical-Link außerhalb des head-Bereichs oder mit Attributen, die dort nicht hingehören. Ein Canonical, das auf eine andere URL, auf einen anderen Host oder auf eine nicht indexierbare Seite zeigt, erscheint als eigener Befund. So sehen Sie, welche davon beabsichtigt sind.

  • Fehlende, mehrfache, relative und Fragment-Canonicals
  • Canonical außerhalb des head-Bereichs oder mit ungültigen Attributen
  • Ziele auf anderen Hosts und nicht indexierbare Ziele

Canonical-Graph

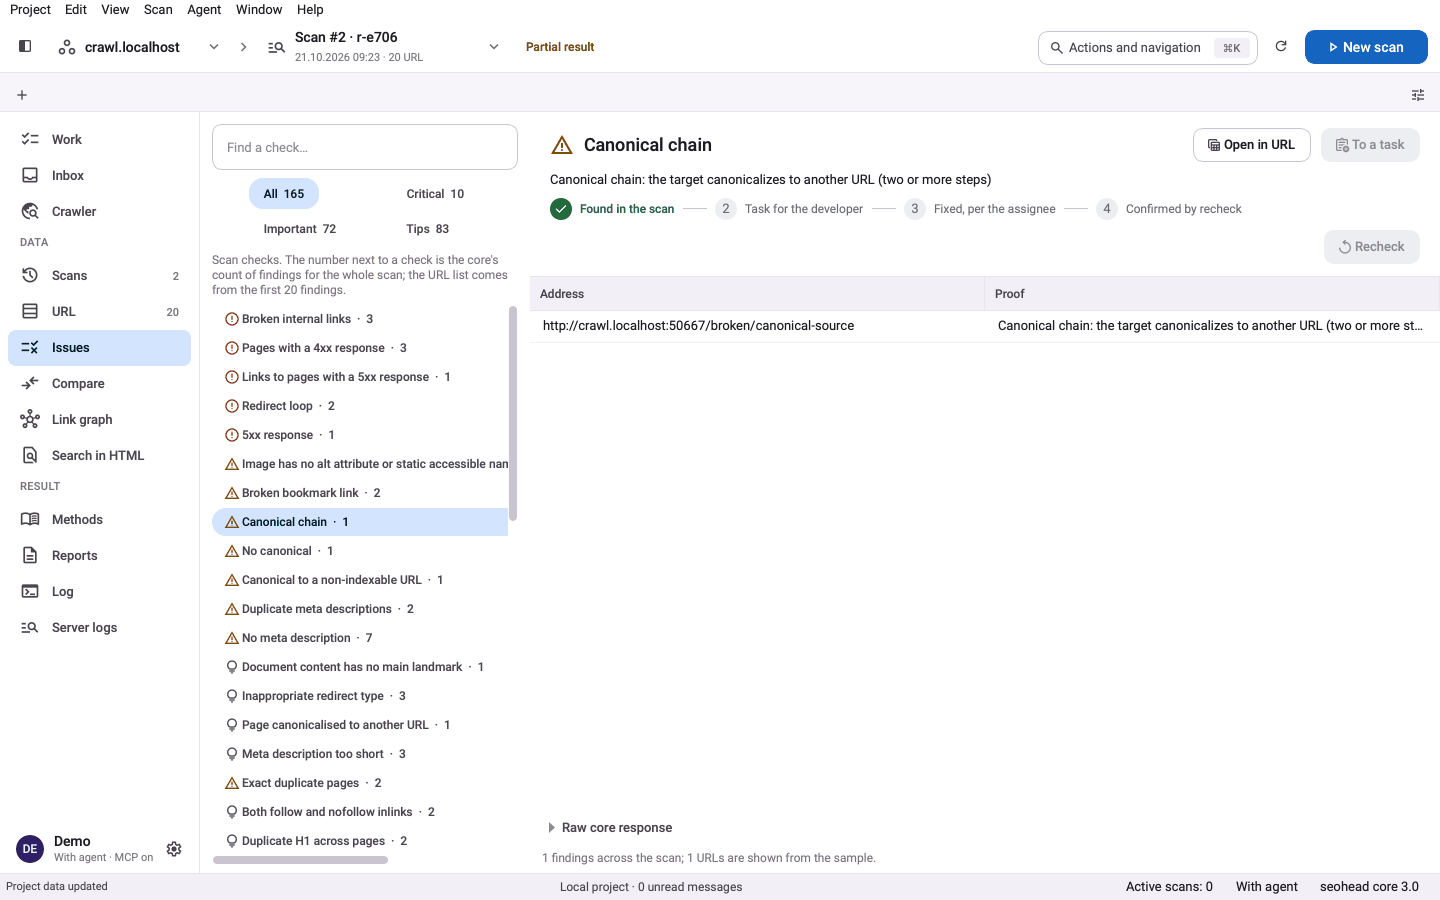
Die Canonical-Ziele des gesamten Crawls bilden einen Graphen. Daraus ergeben sich Ketten, bei denen das Ziel selbst auf eine andere URL kanonisiert ist, Canonicals auf eine Weiterleitung oder einen Fehler sowie Gruppen von Seiten aus verschiedenen Bereichen, die alle auf die Startseite kanonisieren. Ein Ziel, auf das kein interner Link zeigt, wird ebenfalls gemeldet.

  • Ketten aus zwei oder mehr Schritten
  • Canonical auf eine 3xx-, 4xx- oder 5xx-URL
  • Seiten aus mehreren Bereichen, die auf die Startseite kanonisiert sind
  • Ziele ohne internen Link

Regeln

Paginierung und Filterseiten brauchen eine eigene Regel, denn ein Canonical auf die erste Seite ist für die eine Website richtig und für die andere falsch. Die Projektregel legt fest, was erwartet wird. Jeder Befund zeigt das erwartete Ziel neben dem tatsächlichen.

  • Regel für Canonicals bei der Paginierung
  • Regel für Canonicals bei Filterseiten
  • Erwartetes Ziel wird im Nachweis angezeigt

Drei Schritte, ein gespeicherter Scan

  1. Jedes Canonical-Tag lesen

    Das Canonical jeder Seite wird gelesen und auf fehlende, mehrfache, relative oder #Fragment-Werte geprüft.

  2. Den Canonical-Graphen erstellen

    Die Canonical-Ziele des gesamten Crawls bilden einen Graphen. So werden Ketten und Schleifen als Pfade zwischen Seiten sichtbar.

  3. Jedes Ziel prüfen

    Jedes Ziel wird auf Weiterleitungen, 4xx- oder 5xx-Fehler und darauf geprüft, ob ein interner Link darauf verweist.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
CANONICAL_MISSINGIndexierbare Seite ohne Canonical-URLImportantURL der Seite
CANONICAL_MULTIPLESeite deklariert mehr als eine Canonical-URLImportantURL der Seite und jeder Canonical-Wert
CANONICAL_CHAINDas Canonical-Ziel kanonisiert auf eine andere URL, zwei oder mehr SchritteImportantVollständige Kette der Canonical-URLs
CANONICAL_TO_REDIRECTCanonical zeigt auf eine URL, die mit einer 3xx-Weiterleitung antwortetImportantCanonical-Ziel und sein Weiterleitungsstatus
CANONICAL_TARGET_ERRORCanonical zeigt auf eine URL, die 4xx oder 5xx liefertImportantCanonical-Ziel und sein Statuscode
CANONICAL_HOMEPAGE_GROUPMehrere verschiedene indexierbare Seiten aus verschiedenen Bereichen kanonisieren alle auf die StartseiteImportantListe der Seiten, die auf die Startseite verweisen
UNLINKED_CANONICALDas Canonical-Ziel hat im gesamten Crawl keinen internen Link, der darauf verweistImportantURL des Canonical-Ziels
Außerdem im Prüfungsregister
CANONICAL_RELATIVECANONICAL_FRAGMENTPAGINATION_CANONICAL_POLICYFILTER_CANONICAL_POLICY

Ein Befehl

bash
seohead parse --url https://example.com/page

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Eine URL für parse, um deren Canonical auszulesen
  • Ein Crawl oder Screaming-Frog-Exporte „Internal:All“ für die Graph-Prüfungen
  • Optionale Projektregel für Paginierung und Filterseiten

Grenzen

  • Eine einzelne URL zeigt keine Ketten, keine Fehlerziele und keine Startseiten-Gruppe. Dafür braucht es den Crawl-Graphen.
  • Ein Canonical ist für Suchmaschinen nur ein Hinweis. Die Prüfungen zeigen daher, was deklariert ist, nicht, welche URL Google gewählt hat.
  • Regelprüfungen brauchen die im Projekt hinterlegte Regel.
  • Seiten außerhalb des Crawls lassen sich nicht als Ziel prüfen.

Fragen

Reicht eine URL, um Probleme zu finden?
Eine URL mit seohead parse zeigt ihren Canonical-Wert. Die Prüfungen auf Ketten, Weiterleitungsziele, Fehlerziele und die Startseiten-Gruppe brauchen den Graphen aus dem gesamten Crawl.
Verändert das etwas auf meiner Website?
Nein. Die Prüfungen lesen nur Seiten. Die Canonical-Tags passen Sie selbst an.
Brauche ich Screaming Frog?
Nein. Die Graph-Prüfungen laufen auf Crawl-Daten. Diese können aus den Screaming-Frog-Exporten „Internal:All“ (sf run --exports-dir) oder aus dem eigenen crawl-site von SpiderHead stammen. Nur ein Screaming-Frog-Crawl mit --crawl braucht die lizenzierte Screaming-Frog-CLI.
Was ist mit Paginierung und Filterseiten?
Zwei Prüfungen, PAGINATION_CANONICAL_POLICY und FILTER_CANONICAL_POLICY, vergleichen jedes Canonical mit der Projektregel und zeigen das erwartete Ziel.
Zeigt das Tool, welches Canonical Google gewählt hat?
Nur bei verbundener Search Console. GSC_USER_CANONICAL_NOT_SELECTED vergleicht das deklarierte Canonical mit dem, das Google über die URL-Prüfung ausgewählt hat. Ohne diese Verbindung zeigen die Prüfungen, was die Seite deklariert.

Testen Sie es auf Ihrer eigenen Website