
Analyse von Screaming-Frog-Exporten

Richten Sie SpiderHead auf einen Ordner mit CSV- oder XLSX-Exporten von Screaming Frog, und Sie erhalten ein Audit und eine priorisierte Aufgabenliste. Der Standardlauf läuft offline: Dafür brauchen Sie weder eine Installation noch eine Lizenz von Screaming Frog, und es gehen keine Anfragen an die Website.

Was es leistet

Zwei Modi

Modus B analysiert Exporte, die Sie bereits in Screaming Frog erstellt haben. Er liest Dateien von Ihrer Festplatte und braucht keine Lizenz. Modus A steuert eine separat installierte, lizenzierte Screaming-Frog-CLI, lässt sie crawlen und analysiert danach das Ergebnis.

  • Modus B: sf run mit --exports-dir, vollständig offline.
  • Modus A: --crawl URL, --crawl-list FILE oder --load-crawl FILE.seospider, mit Ihrer eigenen Screaming-Frog-Lizenz.
  • sf doctor prüft vor dem Start die lokale Einrichtung.

Was Sie erhalten

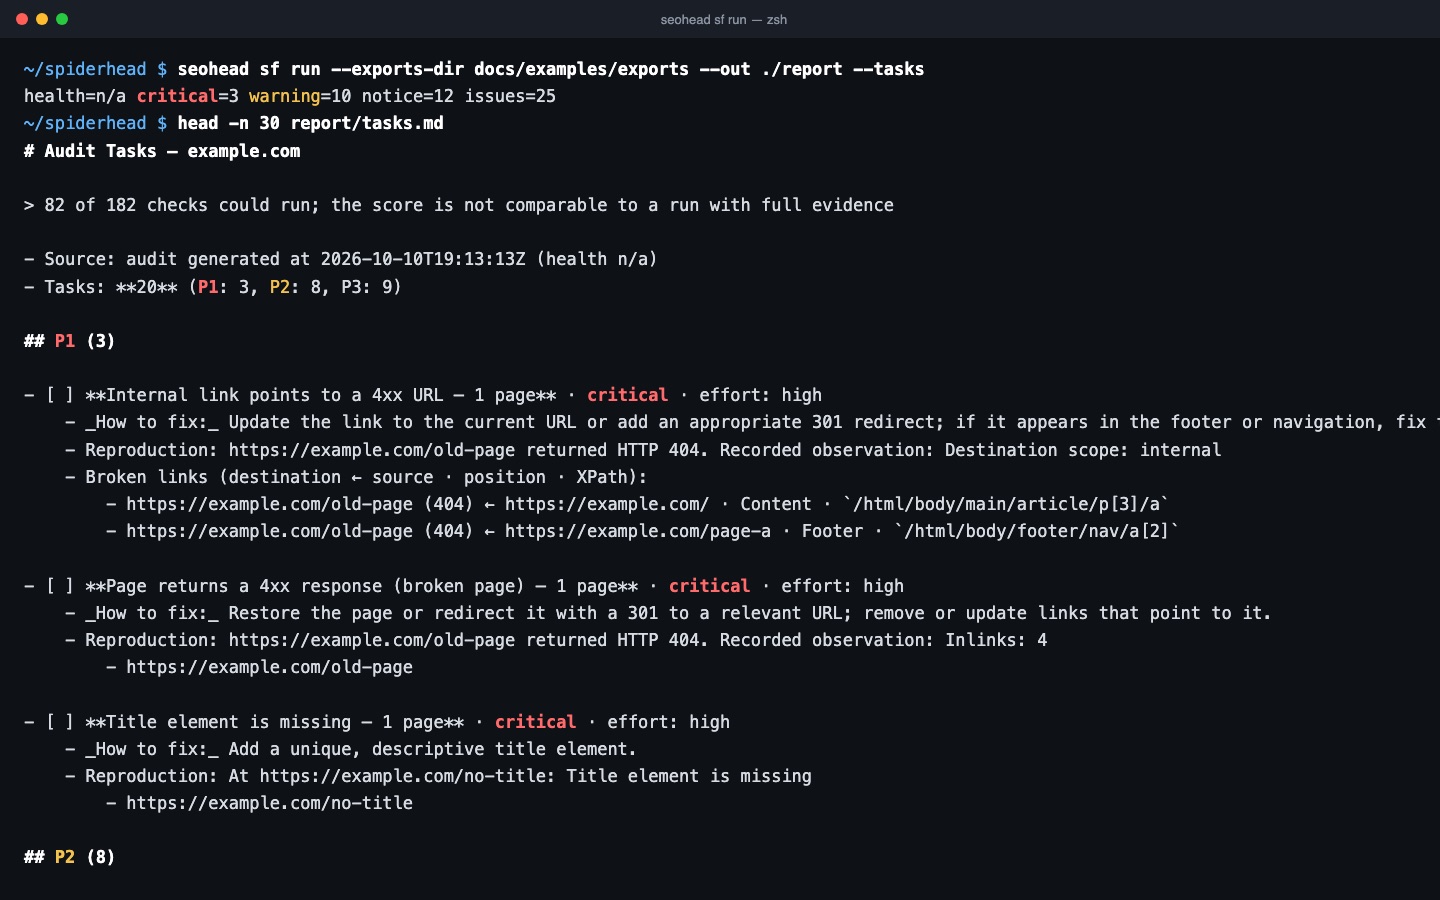
Der Berichtsordner enthält audit.json und audit.md. Mit --tasks kommen außerdem tasks.json und tasks.md hinzu, eine priorisierte Aufgabenliste. Jede Aufgabe nennt Schritte zur Reproduktion, die Position des Links auf der Seite und die vorgeschlagene Korrektur.

  • Mit --format json,md wählen Sie die Berichtsformate.
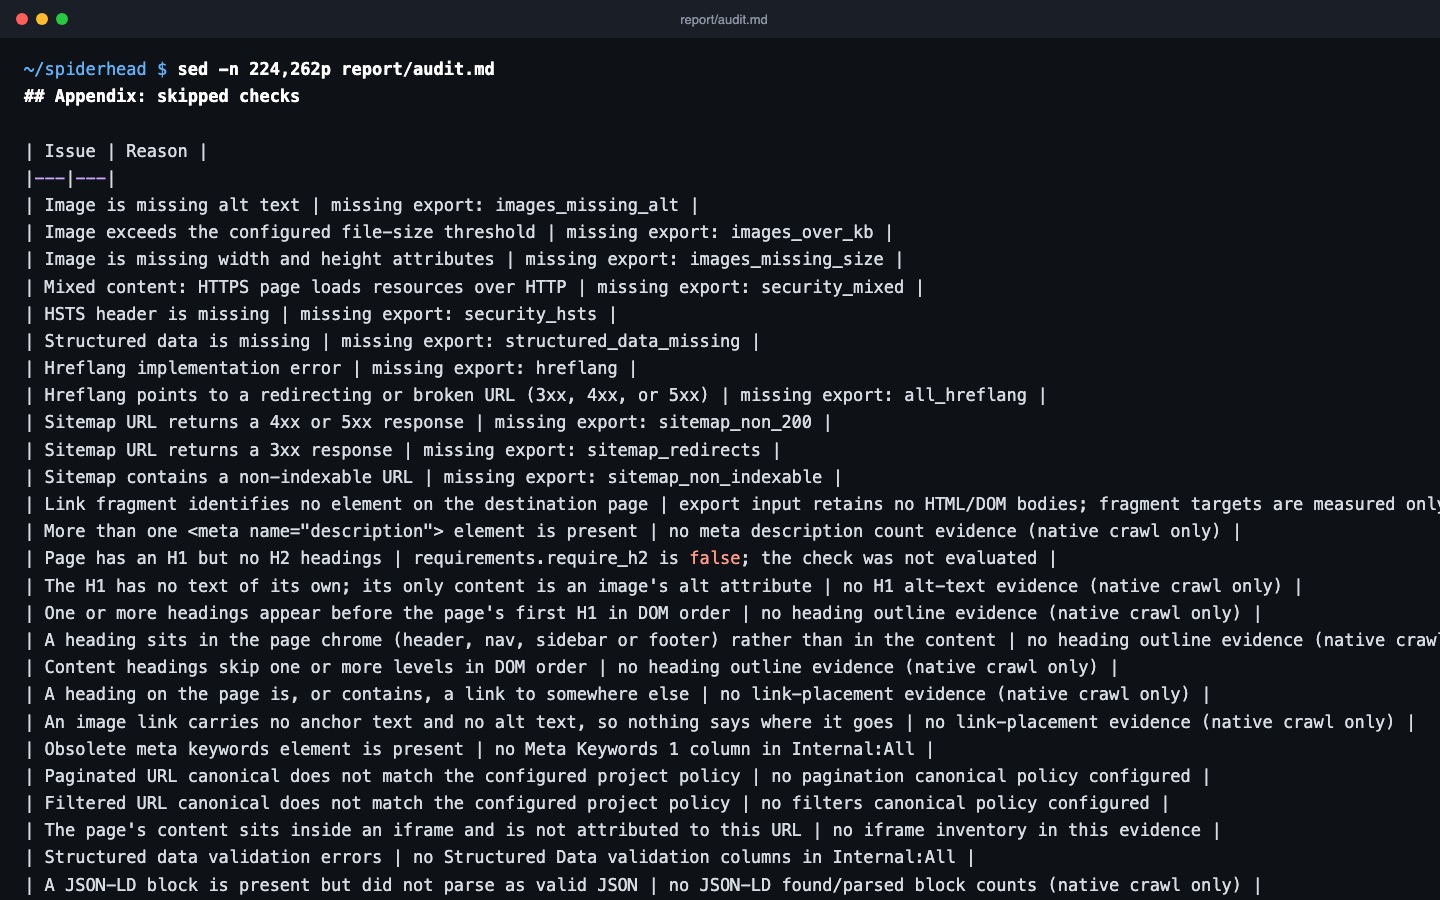
  • Eine Prüfung, deren Export fehlt, wird als übersprungen markiert und mit Grund angegeben. Sie zählt nie als bestanden.
  • Mit --fail-on critical oder warning setzen Sie für CI einen Exit-Code ungleich null.

Such- und Trafficdaten ergänzen

Mit --project DIR verknüpft sf run die in diesem Projekt gespeicherten Daten der letzten vollständigen 28 Tage aus Search Console, GA4 und Metrika mit den geprüften Seiten. Dabei kontaktiert sf run keinen Anbieter. Ein eigenes, nur auf Wunsch aktives --gsc-inspect liest den Indexstatus bei Google für eine Stichprobe von bis zu 50 URLs.

  • Befunde der Anbieter behalten ihre Quelle in audit.json und audit.md.
  • Fehlende Zuordnungen und gekürzte Abfragen bleiben nicht verfügbar oder gelten als teilweise.
  • Negative Befunde wie verwaiste Seiten brauchen eine vollständige Abdeckung durch die Anbieter und einen vollständigen Crawl.

Drei Schritte, ein gespeicherter Scan

  1. Exporte angeben

    Geben Sie einen Ordner mit CSV- oder XLSX-Exporten von Screaming Frog an. Die Analyse läuft offline und schickt keine Anfragen an die Website.

  2. Den Prüfkatalog ausführen

    Derselbe Katalog bewertet jeden Export. Eine Prüfung ohne Daten wird als übersprungen markiert und mit Grund angegeben, nie als bestanden gezählt.

  3. Eine priorisierte Aufgabenliste erhalten

    audit.json, audit.md sowie tasks.md und tasks.json listen jedes Problem mit Schritten zur Reproduktion, Linkposition und Korrektur auf.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
BROKEN_PAGE_4XXDie Seite antwortet mit einem 4xx-StatusCriticalExport Response Codes 4xx
BROKEN_INTERNAL_LINKEin interner Link zeigt auf eine URL mit 4xx-StatusCriticalInlinks-Export: Quellseite und Linkposition
REDIRECT_LOOPEine Weiterleitungskette führt zu einer URL zurück, die bereits besucht wurdeCriticalBericht Redirect Chains
TITLE_MISSINGDie Seite hat kein Title-TagCriticalAbgeleitet aus den Page-Titles-Daten
REDIRECT_CHAINZwei oder mehr Weiterleitungsschritte vor der finalen URLImportantBericht Redirect Chains
DESC_DUPLICATEDieselbe Meta-Description auf mehr als einer SeiteImportantAbgeleitet aus den Meta-Description-Daten
TITLE_TOO_LONGDer Title-Tag überschreitet den konfigurierten Längen-SchwellenwertTipAbgeleitet aus den Page-Titles-Daten

Ein Befehl

bash
seohead sf run --exports-dir ./exports --out ./report --tasks

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Ein Ordner mit CSV- oder XLSX-Exporten von Screaming Frog (--exports-dir)
  • Optional: eine config.json für die Schwellenwerte (--config)
  • Nur Modus A: eine lizenzierte Screaming-Frog-CLI und eine Start-URL, eine URL-Liste oder eine gespeicherte .seospider-Datei

Grenzen

  • Das Audit sieht nur, was in den Exporten steht. Eine Prüfung ohne ihren Export wird übersprungen.
  • Modus A braucht eine Screaming-Frog-Lizenz. SpiderHead stellt sie nicht bereit und legt sie nicht bei.
  • Erneute Prüfungen von Sitemap- und robots-Daten im Netz laufen nur, wenn Sie --live-recheck angeben.
  • Vorgeschlagene Korrekturen werden nicht auf Ihre Website angewendet.

Fragen

Muss Screaming Frog installiert sein, um das zu nutzen?
Für die Analyse nicht. Modus B liest Exporte, die Sie bereits in Screaming Frog erstellt haben, und stellt keine Anfragen an die Website. Screaming Frog und eine Lizenz brauchen Sie nur für Modus A, in dem SpiderHead die Screaming-Frog-CLI zum Crawlen steuert. SpiderHead selbst braucht keinen Schlüssel und kein Konto.
Was passiert mit einer Prüfung ohne Daten?
Sie wird mit dem Grund als übersprungen markiert. Sie wird nie als sauberes Bestehen gemeldet, daher bedeutet 0 Probleme immer, dass die Prüfung gelaufen ist.
Verändert das etwas an meiner Website oder meinen Dateien?
Nein. Das Tool liest die Exporte und schreibt Berichtsdateien in den Ausgabeordner, den Sie angeben. Die vorgeschlagenen Korrekturen müssen Sie selbst umsetzen.
Worin unterscheiden sich audit.md und tasks.md?
audit.md listet die Befunde. tasks.md ist die priorisierte Aufgabenliste mit Schritten zur Reproduktion, Linkpositionen und einer Korrektur für jedes Problem. Sie erhalten sie mit --tasks.
Kann ich das in CI nutzen?
Ja. Übergeben Sie --fail-on critical (oder warning), dann gibt der Befehl einen Exit-Code ungleich null zurück, sobald diese Schwere vorliegt.
Kann ich Exporte anderer Crawler analysieren?
Nicht mit sf run, das Screaming-Frog-Exporte erwartet. Für andere Tools liest crawl-import ein CSV-Paket, das Sie mit einem Manifest zuordnen. Das Ergebnis ist ein eigenes Crawl-Dokument eines Drittanbieters, kein Audit.

Testen Sie es auf Ihrer eigenen Website