
Visualisierung des internen Link-Graphen

Lesen Sie den internen Link-Graphen eines gespeicherten Scans: Knoten, Kanten, verwaiste Seiten, den kürzesten Pfad zu einer Seite und die Links, die auf sie zeigen. Die Desktop-App zeigt ihn an. CLI und MCP lesen denselben Scan, den auch das Audit verwendet.

Was es leistet

Graph des gesamten Scans

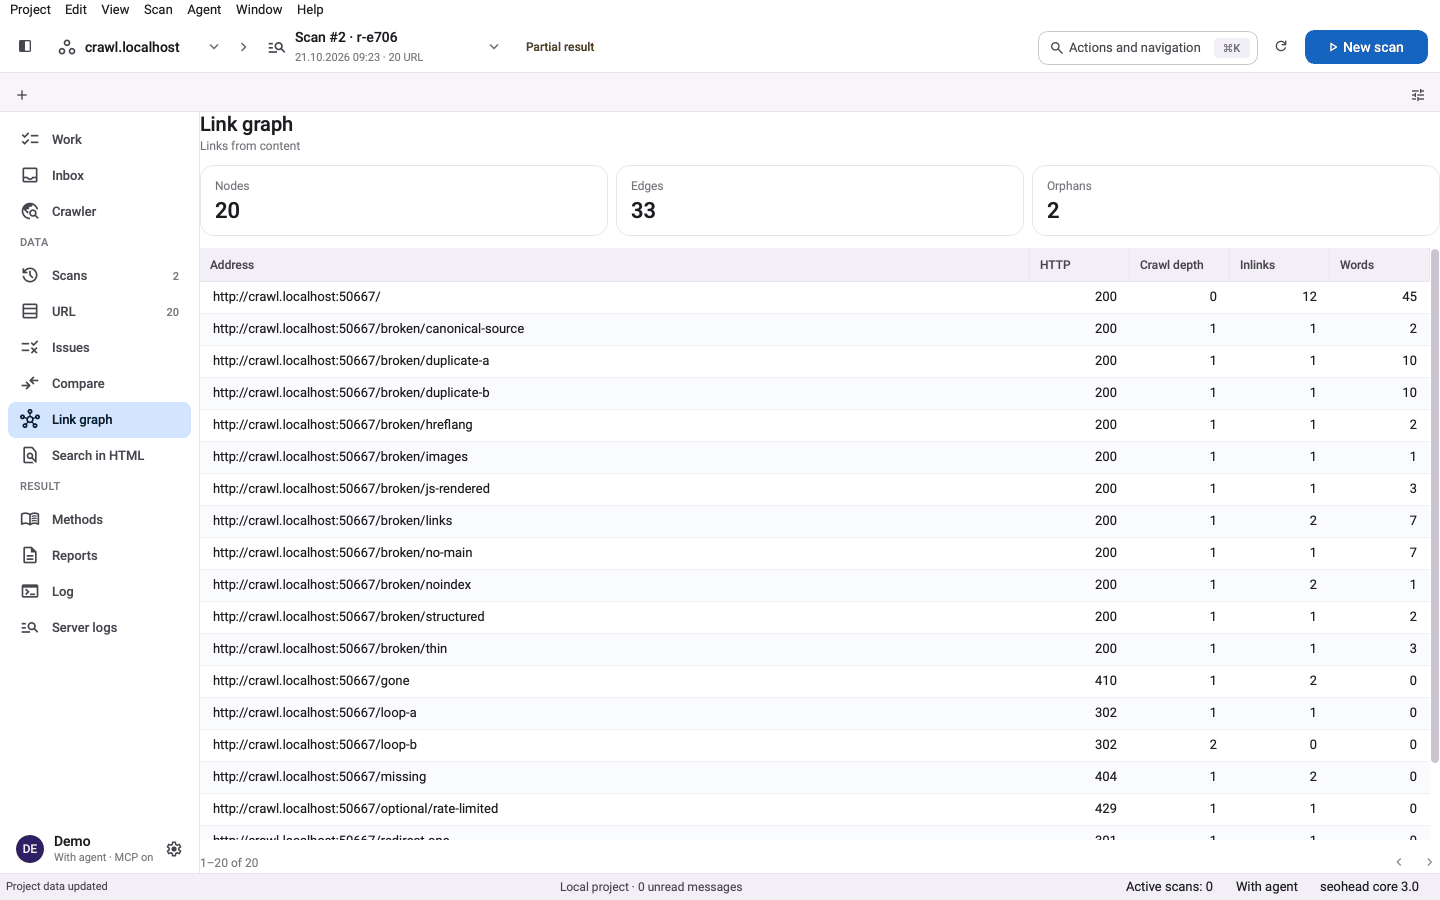
scan-graph liest die internen Links aus einem gespeicherten Scan, ohne Netzwerkanfrage. Ausgegeben werden Knoten, Kanten und verwaiste Seiten. Bei einer großen Website lassen sich die Daten nach Bereichen gruppieren. Der Bildschirm „Link graph“ der Desktop-App zeigt dieselben Zähler sowie eine seitenweise aufgeteilte Tabelle mit jeder URL, ihrem HTTP-Status, ihrer Crawl-Tiefe, den eingehenden Links und der Wortanzahl.

  • Filtern nach Linkposition (Navigation, Header, Seitenleiste, Footer, Inhalt oder anderes) oder nach Bereich
  • Nach Bereich zusammenfassen, wenn der Graph zu groß für eine Liste ist
  • Zwei Scans vergleichen, um hinzugekommene und entfernte Links sowie neue verwaiste Seiten zu sehen

Lokaler Graph

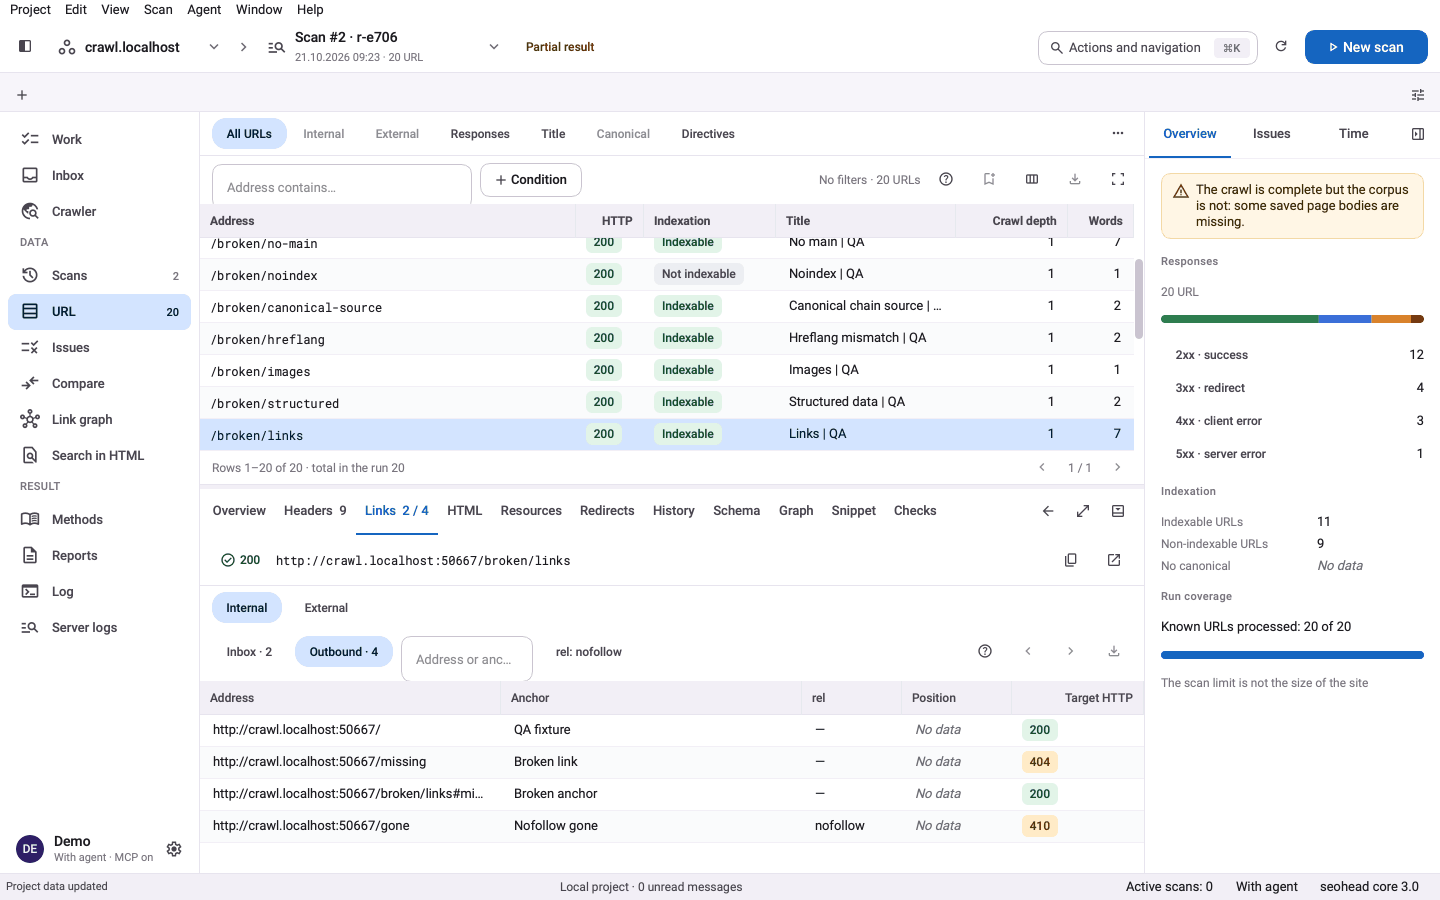
Konzentrieren Sie sich auf eine Seite, um deren Nachbarn zu sehen. In der URL-Karte der Desktop-App zeichnet der Tab „Graph“ die Links rund um die gewählte URL, ein bis drei Ebenen tief, aus dem gespeicherten Scan. Ein Link, den der Scan nicht enthält, wird nie gezeichnet. In der CLI liefert scan-graph mit --around und --depth dieselbe Nachbarschaft als Daten.

  • Die Tiefe ist auf drei Ebenen begrenzt, und die Zeichnung ist in ihrer Größe begrenzt
  • Für die Seite lassen sich ausgehende und eingehende Links auflisten
  • Nur lesend: In Ihr Projekt oder auf die Website wird nichts geschrieben

Pfade und eingehende Links

scan-link-inspect beantwortet die Fragen, die der Graph aufwirft. Der Befehl liefert den kürzesten beobachteten Pfad von einer Start-URL zu einer Seite, die Seiten, die auf sie verlinken, und die Position jedes Links. Sie können Links nach Follow-Typ und Statusklasse sowie nach intern oder extern filtern.

  • Ansichten: Pfad, eingehende Links, Kontext und seitenweise aufgeteilte Links
  • Voreinstellungen für eingehende interne Links und für defekte interne Ziele
  • Nofollow-, Sponsored- und UGC-Links werden von den Follow-Links getrennt geführt

Drei Schritte, ein gespeicherter Scan

  1. Website einmal crawlen

    crawl-site folgt den Links auf demselben Host und speichert einen SQLite-Scan, der jeden internen Link mit Ankertext und Position erfasst.

  2. Graph aus dem gespeicherten Scan abfragen

    scan link-inspect liest den kürzesten Pfad zu einer Seite, die Links, die auf sie zeigen, oder die Links auf einer URL, ohne die Website erneut zu besuchen.

  3. Beheben Sie, was der Graph zeigt

    Verwaiste Seiten, tief liegende Seiten und defekte interne Links werden zu Audit-Befunden, jeweils mit der Korrektur direkt daneben.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
ORPHAN_PAGEDie Seite hat keine internen eingehenden Links, sodass Nutzer und Crawler sie nur über die URL oder die Sitemap erreichen.ImportantSeiten-URL und Anzahl eingehender Links: null
DEEP_CLICK_DEPTHDie Seite liegt mehr Klicks von der Start-URL des Crawls entfernt als der konfigurierte Mindestwert.ImportantKlicktiefe und Start-URL
DEEP_DISCOVERY_PATHDer kürzeste Link-Weg von der Startseite ist länger als die konfigurierte Tiefe.TipKürzester Pfad von der Startseite
LOW_LINK_SCOREDer interne Link-Score der Seite liegt weit unter dem Median der Website.TipScore der Seite und Median der Website
ONLY_NOFOLLOW_INLINKSJeder interne Link auf die Seite ist nofollow, daher erreicht der Linkjuice die Seite nicht.ImportantEingehende Links mit ihren rel-Werten
BROKEN_INTERNAL_LINKEin interner Link zeigt auf eine URL, die mit 4xx antwortet.CriticalQuellseite, Linkposition und Ankertext, Status des Ziels
DUPLICATE_INTERNAL_LINKDasselbe Ziel mit demselben Ankertext erscheint auf einer Seite mehr als einmal.TipWiederholtes Ziel, Ankertext und Anzahl

Ein Befehl

bash
seohead-desktop --project ./shop

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Ein gespeicherter Scan: eine SQLite-Datei im Format scan.v1 aus crawl-site oder ein Scan, der in der Desktop-App geöffnet ist
  • Links, die in diesem Scan erhalten sind (ältere Scans brauchen für die Linkpositionen womöglich scan-reanalyze)
  • Eine Start-URL für Pfadabfragen und eine Seiten-URL für lokale Graphen

Grenzen

  • Gezeigt werden Links, die der Crawl beobachtet hat, nicht wie eine Suchmaschine sie gewichtet
  • Bei einem unvollständigen Crawl bedeuten die Zahlen verwaister Seiten: im beobachteten Graphen nicht erreichbar, nicht auf der gesamten Website
  • Linkpositionen bleiben not_classified, wenn der Seitenkörper nicht gespeichert wurde
  • Die Übersicht in der Desktop-App ist eine Tabelle mit Zählern. Der gezeichnete Graph beschränkt sich auf eine URL

Fragen

Brauche ich Screaming Frog, um den Link-Graphen zu nutzen?
Nein. Der Graph liest den gespeicherten Scan, den crawl-site schreibt, also denselben Scan, den auch das Audit verwendet. Screaming-Frog-Exporte sind optional.
Verändert der Graph etwas auf meiner Website?
Nein. Er liest die gespeicherte Scan-Datei. Auf Ihrer Website wird nichts geschrieben, und die Prüfungen melden nur, was der Crawl gefunden hat.
Eine Seite steht in meiner Sitemap, wird aber als verwaist markiert. Warum?
ORPHAN_PAGE bedeutet, dass kein interner Link auf die Seite zeigt. SITEMAP_ORPHAN ist die Sitemap-Variante desselben Problems. Setzen Sie einen Link von einer passenden Seite oder entfernen Sie die URL aus der Sitemap.
Was ist, wenn der Crawl unvollständig war?
Das Toolkit verzichtet bei unvollständigen Crawls auf Aussagen über die ganze Website. Die Zählungen verwaister Seiten und Komponenten sind mit ihrem Geltungsbereich gekennzeichnet. Eine fehlende Route oder Liste eingehender Links wird als teilweise oder nicht verfügbar markiert, nie als sauberes Ergebnis.
Kann ich den Graphen ohne die Desktop-App nutzen?
Ja. scan-graph und scan-link-inspect sind CLI-Befehle und MCP-Tools. So kann ein Skript oder ein Agent denselben Graphen als JSON lesen.
Wie groß darf ein Graph sein, den das Tool lesen kann?
Die Abfragen sind begrenzt. Pro Aufruf gibt es feste Obergrenzen für Knoten und Kanten. Größere Websites werden nach Bereichen zusammengefasst, und das Abschneiden wird im Ergebnis gemeldet.

Testen Sie es auf Ihrer eigenen Website