
Abgebrochenes Crawling fortsetzen

Crawls lassen sich fortsetzen. Ein Scan ist eine gespeicherte SQLite-Datei mit Herkunftsnachweis. Ein gestopptes Crawling läuft deshalb an der Stelle weiter, an der es stehen geblieben ist, statt von vorn zu beginnen.

Was es leistet

Gespeicherte Scans

Ein nativer Scan ist eine einzige SQLite-Datei, die Nachweise, Warteschlange und alle Einstellungen gemeinsam enthält. Sie können ihn prüfen, exportieren, als Snapshot sichern, anheften, bereinigen, neu in die Warteschlange stellen, Inhalte vergleichen und offline neu auswerten, ohne die Website erneut anzufragen. Ein abgeschlossener Scan bleibt unveränderlich.

  • scan-reanalyze wertet das gespeicherte HTML erneut aus
  • Snapshots und Pins als Basislinien

Wiederaufnahme

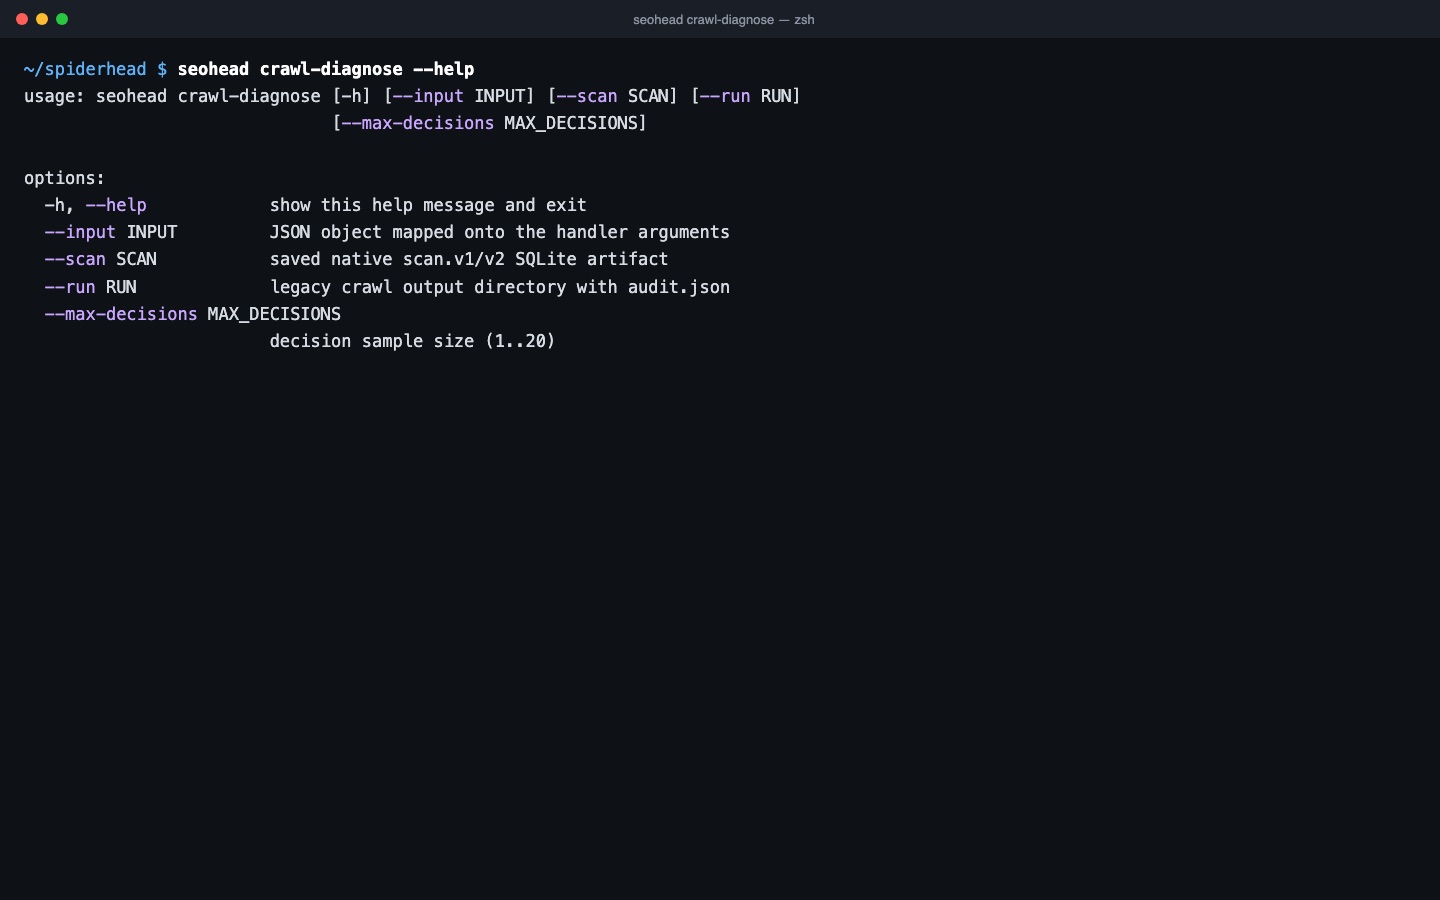
Starten Sie crawl-site --resume mit dem Pfad zum Scan. Das Crawling setzt dann die gespeicherte Warteschlange unter den gespeicherten Regeln fort. Beim Beenden zeigt crawl-site an, ob der Lauf abgeschlossen wurde, vorzeitig endete oder einen früheren Lauf fortgesetzt hat. crawl-diagnose liest den Scan offline und erklärt, was das Crawling gestoppt hat, ganz ohne Netzwerkanfrage.

Drei Schritte, ein gespeicherter Scan

  1. Die Scan-Datei ist der Kontrollpunkt

    Eine SQLite-Scan-Datei enthält Warteschlange, Nachweise und alle Einstellungen in einer einzigen Datei. Sie werden in derselben Transaktion geschrieben, daher trennt ein Abbruch sie nicht voneinander.

  2. Fortsetzen nur mit der Datei

    Führen Sie seohead crawl-site --resume mit dem Pfad zum Scan aus. Start-URL und Einstellungen werden aus der Datei gelesen, das Crawling läuft also nach denselben Regeln weiter.

  3. Ursache der Unterbrechung ermitteln

    crawl-diagnose liest den Scan offline. Es zeigt Warteschlange, den Stand von robots, Geltungsbereich und Budget, die Inhaltstypen und die aufgezeichneten Fehler, ganz ohne Netzwerkanfrage.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
NO_RESPONSEDie URL lief in einen Timeout, die DNS-Auflösung scheiterte oder die Verbindung wurde abgelehnt. Ein ausgefallener Server zeigt sich hier oft zuerst.CriticalURL und Fehlertyp im Scan
SERVER_ERROR_5XXDie Seite antwortet mit einem 5xx-Status, etwa wenn der Server unter Last nicht mehr antwortet.CriticalURL und Statuscode
BROKEN_PAGE_4XXDie Seite antwortet mit einem 4xx-Status. Sie ist damit für Nutzer und Crawler defekt.CriticalURL und Statuscode
BLOCKED_BY_ROBOTSrobots.txt blockiert die URL. Prüfen Sie vor dem Fortsetzen, ob die Sperre beabsichtigt ist.ImportantURL und die robots.txt-Regel

Ein Befehl

bash
seohead crawl-diagnose --scan ./scans/audit.sqlite

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Die Scan-Datei, die crawl-site --scan-out geschrieben hat
  • Dieselbe SpiderHead-Version, die sie geschrieben hat (oder --producer-build SHA)
  • Für einen Lauf im alten Ordnerformat: derselbe Befehl und derselbe --out-dir

Grenzen

  • Ein abgeschlossener oder fehlgeschlagener Scan lässt sich nicht fortsetzen
  • Ein Crawling, das an seinem eigenen URL- oder Zeitlimit gestoppt hat, läuft mit demselben Limit weiter. Wollen Sie das Limit erhöhen, crawlen Sie in einen neuen Scan.
  • Crawlings mit Authentifizierungs-Headern lassen sich nicht fortsetzen
  • Beim Fortsetzen lassen sich nur die Rate-Einstellungen ändern

Fragen

Kann ich beim Fortsetzen die URL oder die Einstellungen ändern?
Nein. Mit --resume werden nur die Rate-Optionen (--max-urls-per-second, --min-delay) akzeptiert. Start-URL und alle übrigen Einstellungen werden aus der Datei gelesen, damit ein Crawling nie nach den Regeln eines anderen Crawlings weiterläuft.
Braucht die Fortsetzung dieselbe SpiderHead-Version?
Ja. Eine Fortsetzung mit einer anderen Quellcode-Revision wird abgelehnt, und die Meldung nennt beide Revisionen. Lässt sich diese Version nicht als diejenige prüfen, die die Datei geschrieben hat, übergeben Sie --producer-build mit ihrem SHA.
Werden Seiten beim Fortsetzen erneut abgerufen?
Nein. Eine Seite, die bereits im Scan gespeichert ist, wird nicht doppelt abgerufen. Der Lauf setzt an der gespeicherten Warteschlange an.
Sieht ein gestopptes Crawling wie vollständig aus?
Nein. Die JSON-Ausgabe und der gespeicherte Audit-Datensatz enthalten partial, finish_reason und resumed. So wirkt ein Teil-Scan nie wie die ganze Website.
Wie setze ich ein Crawling mit --out-dir fort?
Führen Sie denselben Befehl mit demselben --out-dir erneut aus. Die Checkpoint-Datei crawl_state.json in diesem Ordner entscheidet über die Fortsetzung. Haben sich Geltungsbereich oder Limits geändert, startet das Crawling absichtlich von vorn.

Testen Sie es auf Ihrer eigenen Website