
Individuelle Extraktion aus gecrawlten Seiten

Content-Selektoren und deklarative Extraktionsregeln laufen über die gespeicherten Seiteninhalte. Die Quellensuche im gespeicherten Scan findet, auf welchen Seiten ein Marker steht, etwa ein GTM-Snippet.

Was es leistet

Extraktionsregeln

Regeln sind reine Daten, kein Code. Jede Regel hat eine Art (text, attribute, structured, presence oder count), einen Selektor und einen Operator (equals, contains, matches oder exists). Der Operator matches ist ein begrenztes Glob-Muster, kein regulärer Ausdruck. scan-extract führt die Regeln ohne Netzwerkzugriff und ohne Schreibvorgänge über die gespeicherten Seiteninhalte aus. Eine Regel lässt sich daher ändern und erneut ausführen, ohne neu zu crawlen. Um CSS-, XPath- oder Regex-Extraktoren an eingefügtem HTML zu testen, nutzen Sie custom-extract-sample.

Gespeichertes HTML durchsuchen

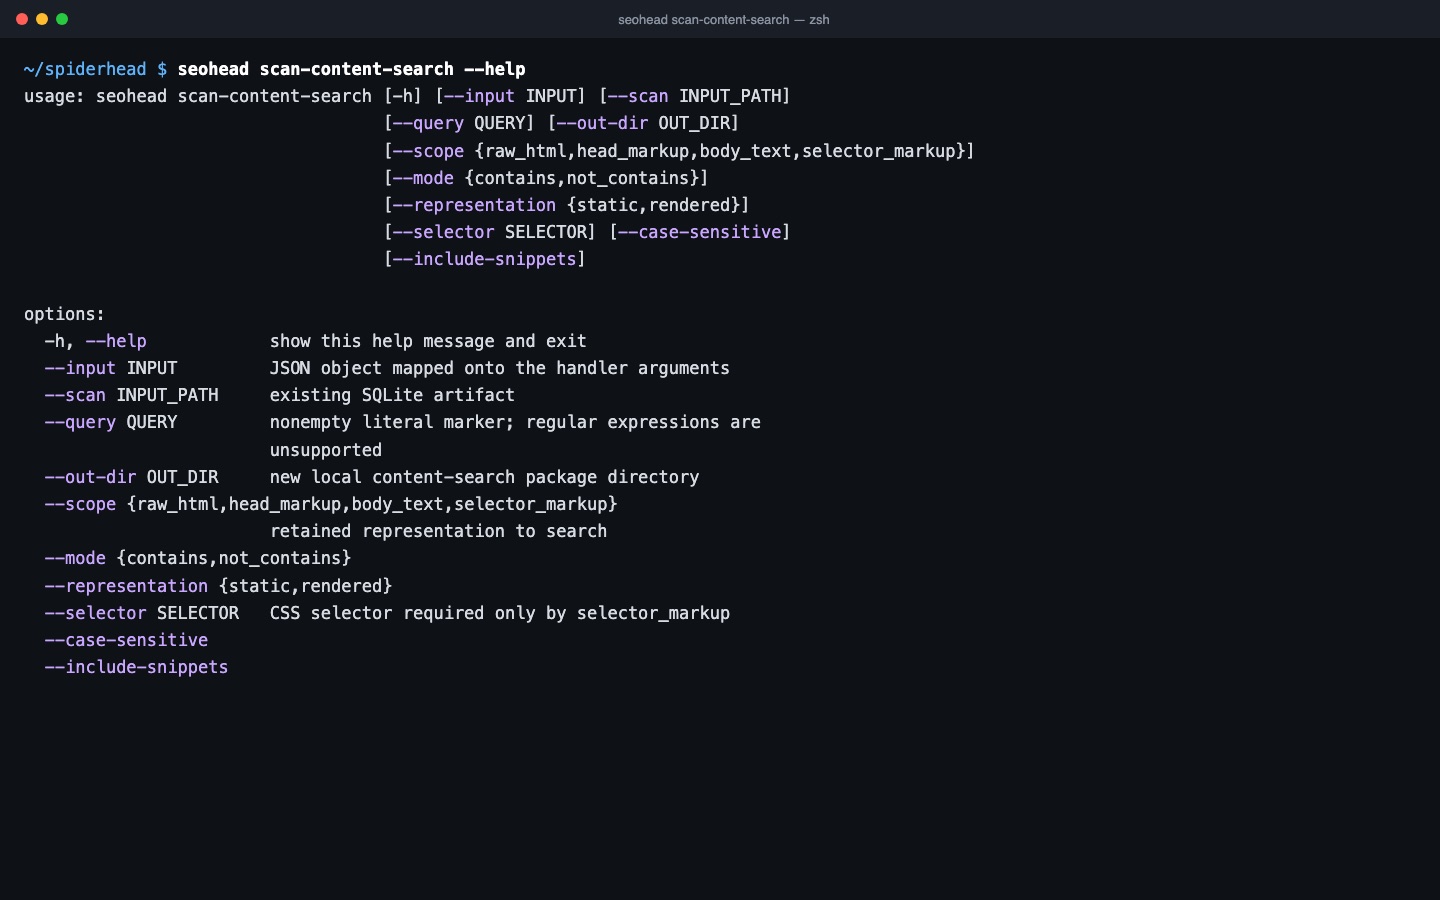
scan-content-search findet eine Zeichenfolge oder einen regulären Ausdruck im Roh-HTML, im Head-Markup, im Body-Text oder im Markup, das ein CSS-Selektor trifft. So finden Sie, auf welchen Seiten ein Marker steht, etwa ein GTM-Snippet. Die Treffer werden in ein neues lokales Paket geschrieben, das Sie behalten können.

  • Literale Suche oder Regex, Roh-HTML oder gerendertes DOM
  • Ergebnisse lesen Sie mit scan-content-search-page in Blöcken von 100 Datensätzen

Drei Schritte, ein gespeicherter Scan

  1. Einmal crawlen und Inhalte behalten

    Ein gespeicherter Scan hält vollständige Seiteninhalte innerhalb des Aufbewahrungslimits. Regeln und Suchen laufen dann auf dieser Kopie, nicht auf der Live-Website.

  2. Extraktionsregeln offline ausführen

    Schreiben Sie die Regeln als JSON mit der Art text, attribute, structured, presence oder count sowie dem Operator equals, contains, matches (ein Glob) oder exists. Übergeben Sie sie über --input oder das MCP-Tool an seohead scan-extract. Es wird nichts abgerufen, und das Ergebnis wird nicht gespeichert.

  3. Gespeichertes HTML nach einem Marker durchsuchen

    scan-content-search findet eine Zeichenfolge oder einen regulären Ausdruck im Roh-HTML, im Head-Markup, im Body-Text oder in einem CSS-Selektor und schreibt ein lokales Paket. Lesen Sie es mit scan-content-search-page jeweils 100 Zeilen.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
TITLE_MISSINGDas title-Element fehlt. Eine Regel der Art text auf den Selektor title findet dieselbe Lücke im gesamten gespeicherten Scan.CriticalSeiten-URL; das title-Element fehlt oder ist leer
CANONICAL_MISSINGEine indexierbare Seite hat keine kanonische URL. Eine presence-Regel auf link[rel=canonical] listet die Seiten ohne sie auf.ImportantSeiten-URL; kein canonical-Link gefunden
SCHEMA_VALIDATION_ERRORFehler bei der Validierung strukturierter Daten. Eine structured-Regel mit JSON-Pointer zeigt die JSON-LD-Werte hinter dem Fehler.ImportantSeiten-URL und der fehlerhafte Eintrag mit strukturierten Daten
STRUCTURED_DATA_MISSINGStrukturierte Daten fehlen auf Seiten, auf denen Sie sie erwarten. Eine presence-Regel auf den JSON-LD-Block zeigt die Seiten ohne Daten.TipSeiten-URL; keine strukturierten Daten gefunden
LOREM_IPSUM_PLACEHOLDERIm Inhaltsbereich der Seite steht Lorem-Ipsum-Platzhaltertext. Eine Inhaltssuche nach der Platzhalterphrase findet ihn im gesamten Scan.ImportantSeiten-URL und Anzahl der Treffer des Platzhaltertexts

Ein Befehl

bash
seohead scan-content-search --scan ./scans/audit.sqlite --query gtm.js

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Ein gespeicherter Scan (SQLite) mit aufbewahrten Seiteninhalten
  • Für die Extraktion: eine JSON-Liste mit Regeln, übergeben über --input oder das MCP-Tool
  • Für die Suche: eine Suchzeichenfolge oder ein regulärer Ausdruck und ein neuer Ausgabeordner

Grenzen

  • Durchsucht oder extrahiert werden kann nur auf Seiten, deren Inhalt gespeichert wurde
  • Extraktionsregeln haben kein Regex-Feld; für reguläre Ausdrücke nutzen Sie die Inhaltssuche
  • Ein Treffer zeigt, dass der Code im HTML steht, nicht dass ein Tag bei einem Besucher ausgelöst wurde
  • Gerenderte Inhalte sind nur durchsuchbar, wenn der Scan eine gerenderte Kopie gespeichert hat

Fragen

Lädt die Extraktion die Website erneut?
Nein. scan-extract und scan-content-search lesen die gespeicherten Seiteninhalte in der Scan-Datei. Sie rufen nie eine URL auf. Eine Regel können Sie also ändern und erneut ausführen, ohne neu zu crawlen.
Wenn ein GTM-Tag gefunden wird: Wurde es ausgelöst?
Nicht unbedingt. Ein Treffer zeigt, dass das Tag im HTML steht. Er beweist nicht, dass das Tag bei einem Besucher ausgelöst wurde. Die Suche zeigt nur, wo der Code vorhanden ist.
Was passiert, wenn der Inhalt einer Seite nicht gespeichert wurde?
Die Seite wird als unbekannt gemeldet, nicht als fehlend. Die Suche behauptet nie, dass ein Marker fehlt, wenn der Inhalt nicht im Scan enthalten ist.
Wird das Extraktionsergebnis gespeichert?
scan-extract speichert sein Ergebnis nicht, sondern gibt es für den jeweiligen Lauf aus. scan-content-search schreibt ein neues lokales Paket, sodass Sie die Treffer behalten.
Kann ich reguläre Ausdrücke verwenden?
In der Inhaltssuche ja: --kind regex akzeptiert einen Python-Regex. Überschreitet eine Seite das Zeitlimit für reguläre Ausdrücke oder kann die Plattform es nicht durchsetzen, wird sie als nicht verfügbar gemeldet, nicht als Nichttreffer. Extraktionsregeln akzeptieren keine Regex.

Testen Sie es auf Ihrer eigenen Website