
Sitemap- und URL-Listen-Crawler

Neben dem Folgen von Links kann SpiderHead die URLs crawlen, die eine Sitemap angibt, oder eine feste URL-Liste. Außerdem gleicht es ab, was die Sitemap sagt, mit dem, was der Crawl gefunden hat.

Was es leistet

Sitemap-, Listen- und URL-Datei-Modus

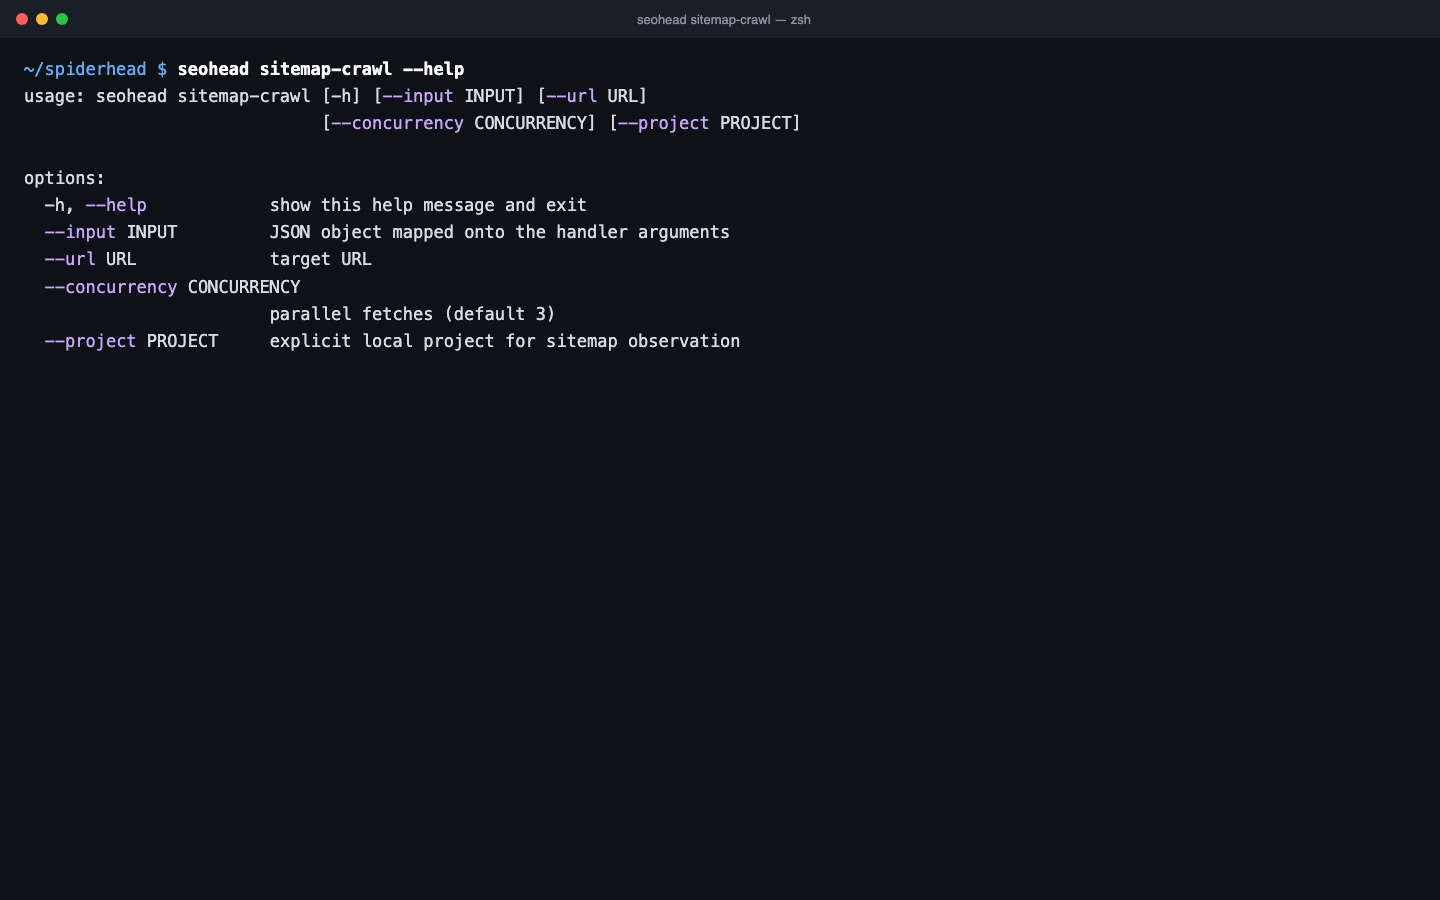
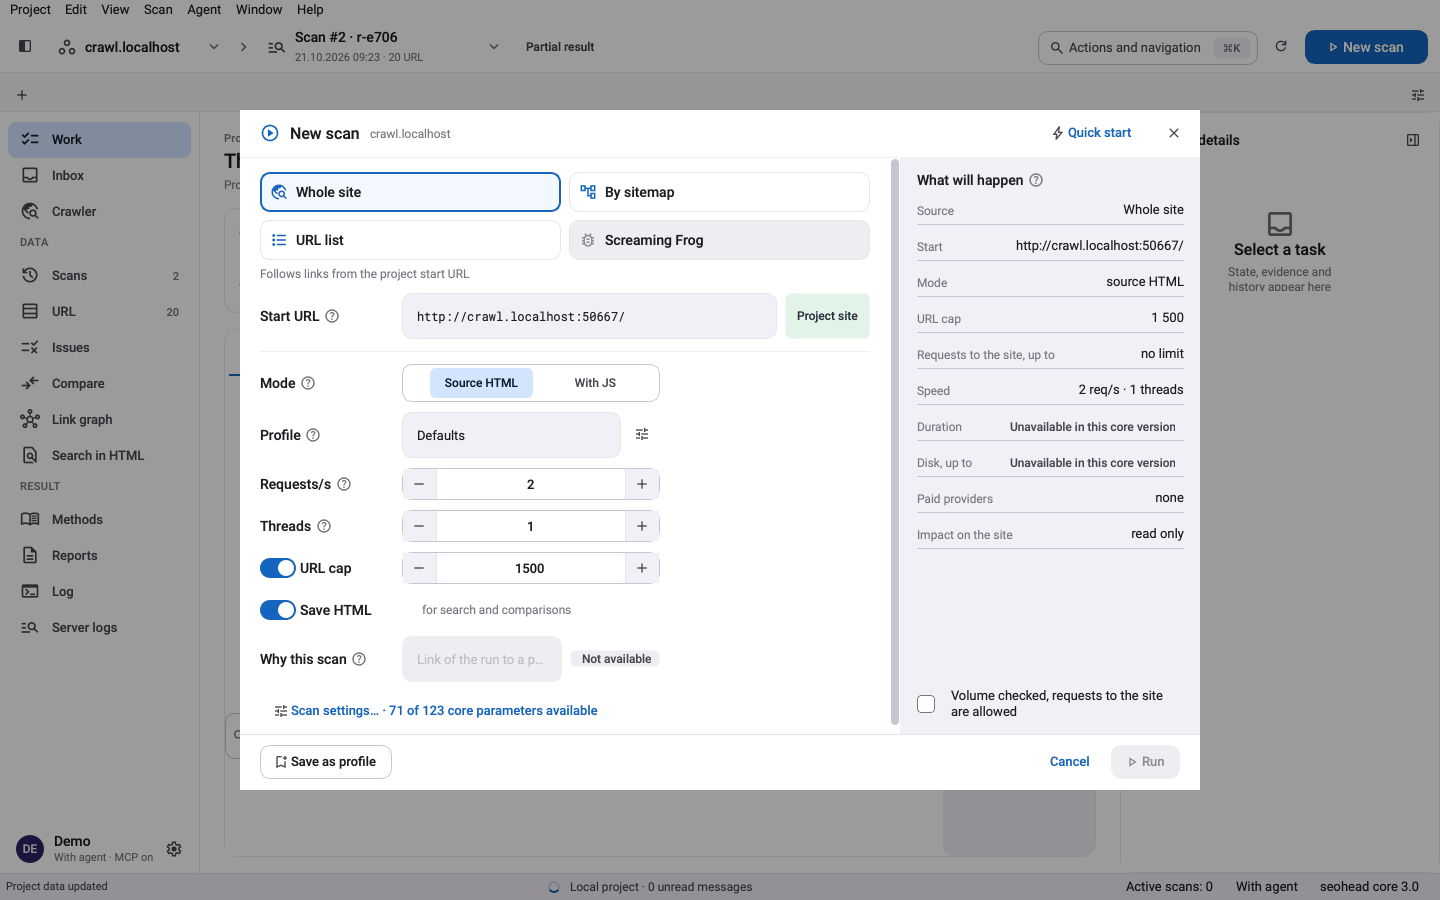
sitemap-crawl löst eine Sitemap in einen URL-Baum auf. Akzeptiert wird eine Sitemap-URL oder ein Website-Root: Dann liest das Tool die Sitemap-Zeilen in robots.txt und greift andernfalls auf /sitemap.xml zurück. Für einen Crawl übernimmt crawl-site --sitemap die Sitemap-URLs als Startpunkte und gleicht sie ab. Mit --sitemap-only werden nur diese Einträge abgerufen, --urls oder --urls-file rufen eine explizite Liste ab, ohne Links zu folgen.

  • Sitemap-Indizes, urlset-Dateien, Text-Sitemaps und gzip-Sitemaps
  • Doppelte URLs über mehrere Sitemaps hinweg werden gemeldet.

Sitemap gegen Crawl

Der Audit vergleicht die URL-Menge der Sitemap mit der gecrawlten Menge. Er meldet weiterleitende, defekte und nicht indexierbare URLs innerhalb der Sitemap sowie indexierbare Seiten, die in ihr fehlen. Die Antwortcodes für angegebene URLs stammen aus dem Crawl, nicht aus sitemap-crawl.

  • Sitemap-URLs ohne interne Links
  • Abweichende URL-Mengen

Drei Schritte, ein gespeicherter Scan

  1. Sitemap lesen

    Geben Sie eine Sitemap-URL an. Sitemap-Indizes, untergeordnete Sitemaps, Textlisten und gzip-Dateien werden bis zu den URL-Einträgen verfolgt.

  2. Jede angegebene URL prüfen

    sitemap-crawl liest die Sitemap-Dateien und meldet angegebene, doppelte und ungültige Einträge. Um für jede angegebene URL einen Antwortcode zu erhalten, crawlen Sie sie mit crawl-site --sitemap oder --sitemap-only.

  3. Mit dem Crawl abgleichen

    Der Audit stellt die URLs der Sitemap den gecrawlten Seiten gegenüber und markiert alles, was nicht übereinstimmt.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
SITEMAP_URL_4XX_5XXEine Sitemap-URL liefert eine 4xx- oder 5xx-AntwortCriticalSitemap-URL und ihr Statuscode
SITEMAP_URL_3XXEine Sitemap-URL leitet weiter, statt 200 zurückzugebenImportantSitemap-URL und ihr Weiterleitungsstatus
SITEMAP_URL_NON_INDEXABLEDie Sitemap enthält eine URL, die nicht indexierbar istImportantSitemap-Eintrag
SITEMAP_DESYNCSitemap- und gecrawlte URL-Mengen stimmen nicht übereinImportantSitemap-Menge gegen Crawl-Menge
URL_NOT_IN_SITEMAPEine indexierbare Seite fehlt in der SitemapTipGecrawlte kanonische URL
SITEMAP_STALE_LASTMODDie Sitemap enthält veraltete oder pauschale lastmod-WerteTiplastmod-Werte in der Sitemap
Außerdem im Prüfungsregister
SITEMAP_URL_NON_CANONICALSITEMAP_ORPHANSITEMAP_URL_DUPLICATEDSITEMAP_TOO_MANY_URLS

Ein Befehl

bash
seohead sitemap-crawl --url https://example.com/sitemap.xml

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Eine Sitemap-URL oder ein Website-Root
  • Für den Vergleich: ein Crawl mit --sitemap
  • Für eine feste Liste: eine TXT-, CSV-, XLSX- oder XML-Datei mit URLs

Grenzen

  • sitemap-crawl liest nur die Sitemap-Dateien und ruft nicht jede angegebene URL auf.
  • Die Prüfungen auf Abweichungen und verwaiste Seiten brauchen einen Crawl zum Vergleich.
  • Sehr große Sitemaps werden gekürzt, und die Kürzung wird markiert.

Fragen

Welche Sitemap-Formate werden gelesen?
Sitemap-Indizes, urlset-Dateien, Text-Sitemaps (eine URL pro Zeile) und gzip-Dateien, sowohl .gz-Dateien als auch gzip-kodierte Antworten. Verschachtelte Indizes werden bis zum Ende verfolgt.
Kann ich statt einer Sitemap eine URL-Liste angeben?
Ja, in einem Crawl: crawl-site --urls nimmt eine durch Kommas getrennte Liste entgegen, --urls-file eine TXT-, CSV-, XLSX- oder XML-Datei, ohne Link-Erkennung. Um eine Liste zu einem gespeicherten Scan hinzuzufügen, verwenden Sie scan-import-urls; das Tool legt vorher ein verifiziertes Backup an.
Verändert das etwas auf meiner Website?
Nein. Es ruft die Sitemap-Dateien ab und, in einem Crawl, die Seiten, die Sie angeben. Die Sitemap und die Seiten werden nicht verändert.
Findet der Sitemap-Befehl allein Abweichungen oder verwaiste URLs?
Nein. Diese Prüfungen brauchen die gecrawlte URL-Menge und laufen deshalb, wenn ein Crawl mit der Sitemap abgeglichen wird (crawl-site --sitemap). Der Befehl allein liefert den URL-Baum mit lastmod-Werten.

Testen Sie es auf Ihrer eigenen Website