
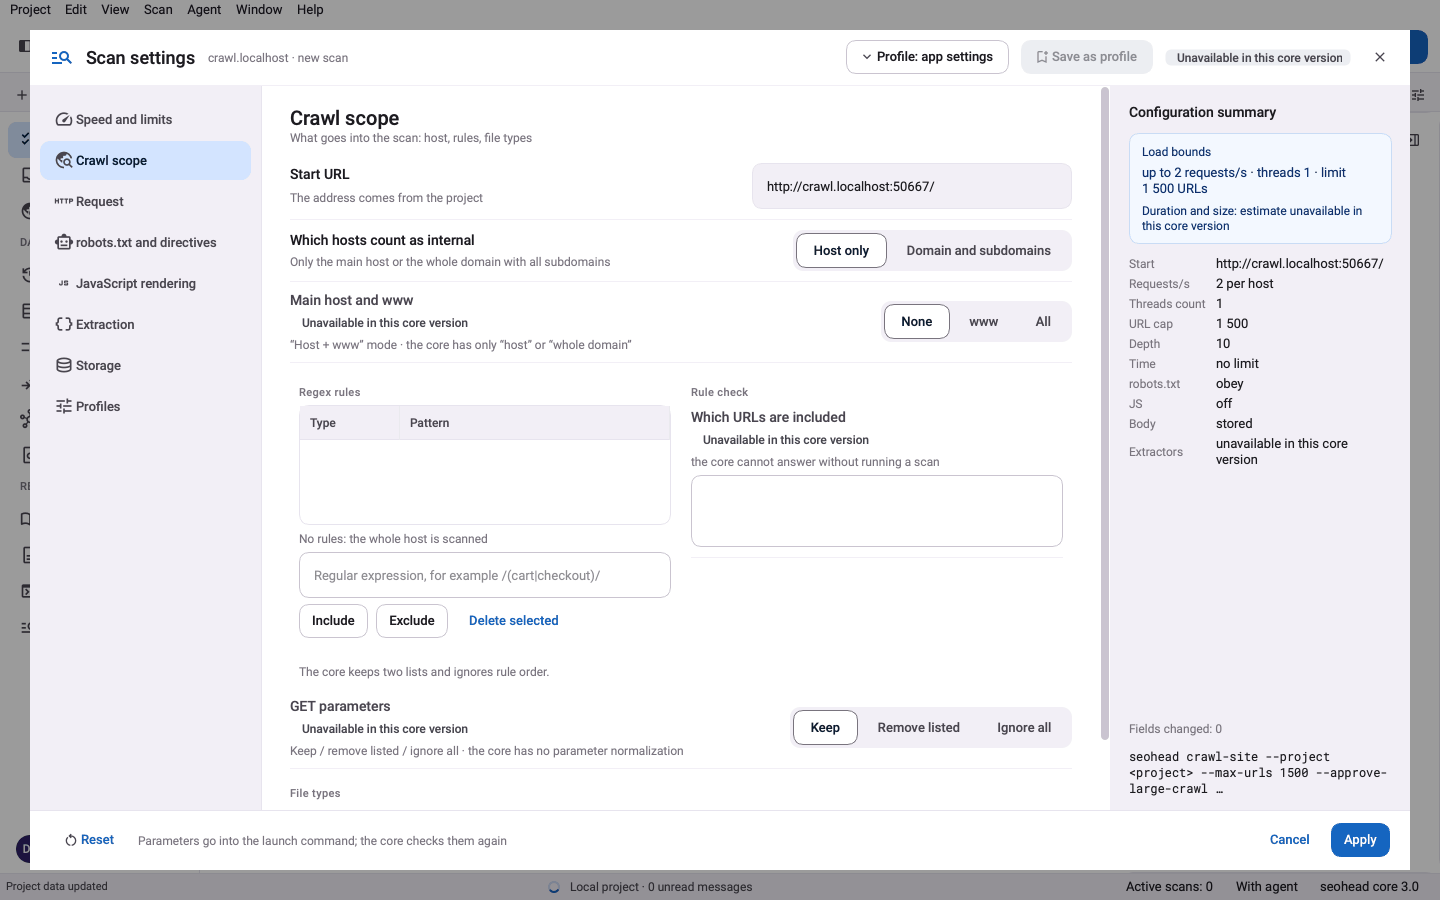
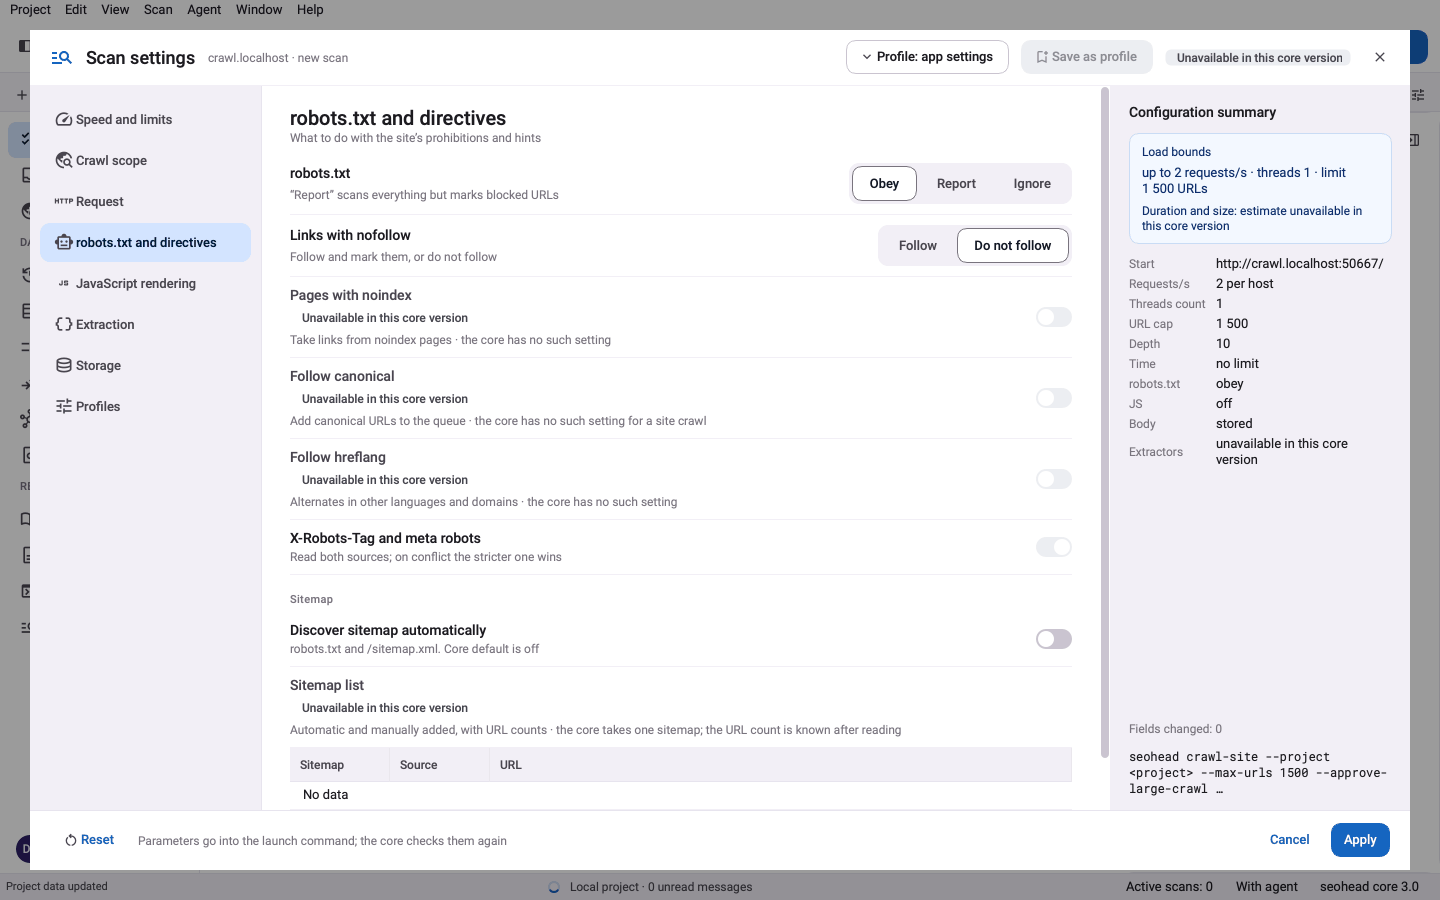
Crawl-Umfang, robots.txt und Direktiven

Legen Sie fest, was ein Crawl abrufen darf: Umfangsregeln, die robots-Richtlinie und eine robots.txt-Prüfung, die erklärt, welche Regel welche URL blockiert.

Was es leistet

robots.txt-Prüfung

robots-check ruft robots.txt ab und meldet die User-Agent-Gruppen, die angegebenen Sitemaps und ob die Pfade, die Sie angeben, crawlbar sind. Eine 4xx-Antwort wie 404 wird als fehlende robots.txt gewertet, daher ist Crawling erlaubt. Eine 429- oder 5xx-Antwort ist ein Fehler: Das Tool behauptet nie einen Zugriff, den es nicht prüfen konnte.

  • Blockierte JS- oder CSS-Dateien, die fürs Rendering nötig sind, markiert der Audit (ROBOTS_BLOCKS_RESOURCES)
  • Prüfung, ob die robots.txt eine Sitemap-Direktive enthält (SITEMAP_NOT_IN_ROBOTS)

Direktiven

Der Audit liest die seitenbezogenen Direktiven noindex, nofollow, nosnippet und unavailable_after sowie den HTTP-Header X-Robots-Tag. Außerdem markiert er eine robots-Meta-Direktive außerhalb des head-Elements, wo sie keine Wirkung hat. robots.txt steuert das Crawling, nicht die Indexierung. Deshalb werden diese Direktiven separat geprüft.

Drei Schritte, ein gespeicherter Scan

  1. Den Crawl-Umfang festlegen

    Einschluss- und Ausschlussmuster, benannte Segmente, Dateiendungsfilter, eine Tiefenbegrenzung und eine URL-Obergrenze bestimmen, welche Seiten ein Crawl abruft.

  2. Die robots-Richtlinie wählen

    Jeder Crawl kann sich an robots.txt halten, nur melden, was sie blockiert, oder sie ignorieren. Die Option lautet --robots respect, report_only oder ignore.

  3. Einen Pfad vor dem Crawl testen

    robots-check liest die Datei für einen User-Agent und listet ihre Gruppen und Sitemaps auf. Um bestimmte Pfade zu testen, übergeben Sie sie über --input mit JSON oder das MCP-Tool seo_robots_check.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
IMPORTANT_URL_BLOCKED_BY_ROBOTSEine live verfügbare Seite, die interne Links erhält, ist durch robots.txt blockiert. Diese Links haben für die Entdeckung keinen Wert, daher geht die Seite im Crawl-Pfad verloren. robots.txt blockiert das Crawling, nicht die Indexierung.ImportantBlockierte URL, die auf sie verweisenden internen Links und die passende Disallow-Regel
BLOCKED_BY_ROBOTSEine URL ist durch robots.txt blockiert. Prüfen Sie, ob die Blockierung beabsichtigt ist.ImportantBlockierte URL und die passende Regel
ROBOTS_BLOCKS_RESOURCESrobots.txt blockiert JavaScript- oder CSS-Dateien, die fürs Rendering nötig sind. Suchmaschinen können die Seite dadurch unvollständig rendern.TipBlockierte .js- oder .css-URL und die Regel, die sie blockiert
DIRECTIVES_OUTSIDE_HEADEine robots-Meta-Direktive steht außerhalb des head-Elements und wird daher nicht angewendet. Ein noindex oder nofollow an dieser Stelle hat keine Wirkung.CriticalDas Element, das der Direktive im Dokument vorausgeht
UNAVAILABLE_AFTERDie Seite trägt die Direktive unavailable_after. Sie entfernt die Seite an einem festgelegten Datum aus dem Index.ImportantWert der Direktive und Datum
NOINDEXDie Seite enthält eine noindex-Direktive. Prüfen Sie, ob das Verlassen des Index beabsichtigt ist.TipQuelle der Direktive: Meta-robots oder X-Robots-Tag
SITEMAP_NOT_IN_ROBOTSrobots.txt enthält keine Sitemap-Direktive. Eine solche Angabe mit der absoluten Sitemap-URL hilft Crawlern, die Sitemap zu finden.TipIn robots.txt gefundene Sitemap-Direktiven
Außerdem im Prüfungsregister
NOSNIPPET

Ein Befehl

bash
seohead robots-check --url https://example.com/

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Eine Website- oder Seiten-URL für robots-check
  • Für Pfade und einen User-Agent: das MCP-Tool seo_robots_check oder die Option --input mit JSON
  • Für einen Crawl: eine --robots-Richtlinie und optionale Umfangsregeln in einer Konfigurationsdatei

Grenzen

  • robots-check auf der Kommandozeile nimmt nur eine URL entgegen. Pfade und User-Agent übergeben Sie über --input oder MCP.
  • robots.txt-Regeln werden jeweils für einen User-Agent geprüft.
  • ignore ruft robots.txt überhaupt nicht ab.
  • Umfangsregeln bestimmen, was abgerufen wird. Ausschlüsse von Befunden blenden Befunde erst nach dem Crawl aus.

Fragen

Hält robots.txt eine Seite aus Google heraus?
Nein. Die Datei stoppt das Crawling. Eine blockierte Seite kann trotzdem über Links indexiert werden, und ein noindex auf dieser Seite wird nie gelesen, solange die Seite blockiert ist. Um eine Seite aus dem Index zu halten, erlauben Sie das Crawling und verwenden noindex.
Was macht robots-check, wenn robots.txt fehlt?
Eine 4xx-Antwort wie 404 bedeutet, dass keine robots.txt existiert. Der Bericht meldet dann, dass Crawling erlaubt ist. Eine 429- oder 5xx-Antwort liefert einen Fehler, und das Tool behauptet nie, dass Crawling erlaubt ist.
Kann ich nur einen Bereich einer Website crawlen?
Ja. Verwenden Sie die Umfangsmuster include bzw. exclude, scope segments_only, um benannte Segmente abzurufen, sowie Filter für Dateiendungen oder Medientypen. Tiefen- und URL-Grenzen halten den Crawl innerhalb der von Ihnen gesetzten Grenzen.
Hält sich ein Crawl standardmäßig an robots.txt?
Ja. Die Standardrichtlinie ist respect. report_only protokolliert, was robots.txt blockieren würde, ohne sich daran zu halten, und ignore überspringt robots.txt. Die Einstellung robots.user_agent_token legt fest, welche User-Agent-Regeln angewendet werden.

Testen Sie es auf Ihrer eigenen Website