
Prüfung auf Duplicate und Thin Content

Findet exakte Duplikate über den Content-Hash, Near-Duplicates, Thin Content, ein niedriges Text-HTML-Verhältnis, Boilerplate und Platzhaltertext über einen Crawl hinweg, auf einem gespeicherten Scan, offline.

Was es leistet

Exakte Duplikate und Near-Duplicates

Exakte Kopien erkennt die Prüfung über den Content-Hash. Near-Duplicates findet sie mit Simhash und LSH. Dadurch werden die Seiten nicht paarweise verglichen. Der Schwellenwert für die Ähnlichkeit liegt standardmäßig bei 0,92. Jeder Befund listet die Gruppe der Seiten auf, sodass Sie eine Seite behalten und die übrigen zusammenführen können.

  • Exakte Duplikate über den Content-Hash
  • Near-Duplicates oberhalb eines Schwellenwerts, den Sie zwischen 0 und 1 festlegen
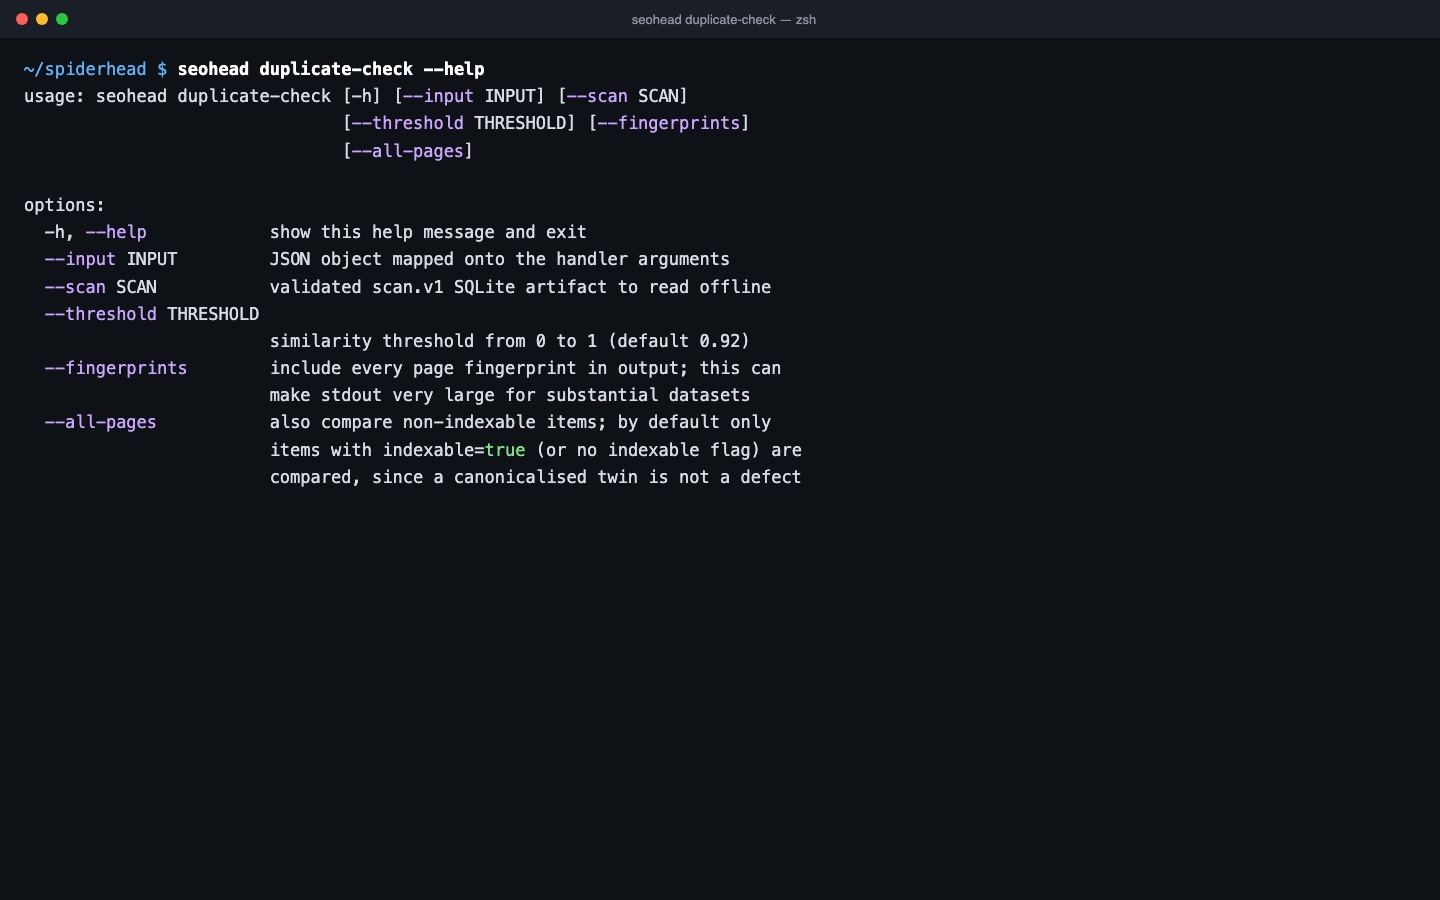
  • Verglichen werden nur indexierbare Seiten, außer Sie übergeben --all-pages
  • Gruppen mit den zugehörigen Seiten aufgelistet

Thin Content und Platzhaltertext

Eine Seite mit zu wenigen Wörtern, mit wenig sichtbarem Text im Verhältnis zu ihrem Markup oder mit Lorem Ipsum im Hauptinhalt wird einzeln gemeldet. Diese Probleme erfordern selten eine Neufassung der gesamten Website. Meist sind ein Template, ein Entwurf oder eine Filterseite die Ursache.

  • Thin Content nach Wortanzahl
  • Niedriges Text-HTML-Verhältnis
  • Lorem Ipsum im Hauptinhaltsbereich

Content-Analyse

Über Duplikate hinaus können die Tools Header-, Navigations- und Footer-Markup gruppieren. So sehen Sie, ob das Boilerplate tatsächlich überall gleich ist. Außerdem bewerten sie die Lesbarkeit. Die Lesbarkeit ist eine optionale Content-Prüfung auf Basis des Flesch-Lesbarkeitswerts.

  • boilerplate-report für Template-Markup
  • Optionale Lesbarkeitsprüfung
  • Semantische Ähnlichkeit nur aus Vektoren, die Sie selbst liefern

Drei Schritte, ein gespeicherter Scan

  1. Website in einen Scan crawlen

    Starten Sie einen Crawl. Er speichert einen nativen SQLite-Scan, der den extrahierten Text jeder Seite für die Offline-Analyse speichert.

  2. Jeden Seitentext vergleichen

    Exakte Kopien erkennt die Prüfung über den Content-Hash. Near-Duplicates findet sie mit Simhash und LSH, sodass die Seiten nicht paarweise verglichen werden.

  3. Gruppen lesen und beheben

    Jeder Befund listet die Seiten seiner Gruppe auf. Führen Sie sie per Canonical-Tag zusammen oder überarbeiten Sie die Seiten, sodass jede ihre eigene Suchintention bedient.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
DUPLICATE_BY_HASHDer Seitentext ist identisch mit dem Text einer anderen SeiteImportantHash-Gruppe mit den URLs, die ihn teilen
NEAR_DUPLICATEDer Seitentext ist fast identisch mit dem Text einer anderen Seite, oberhalb des Schwellenwerts (Standard 0,92)ImportantCluster ähnlicher URLs
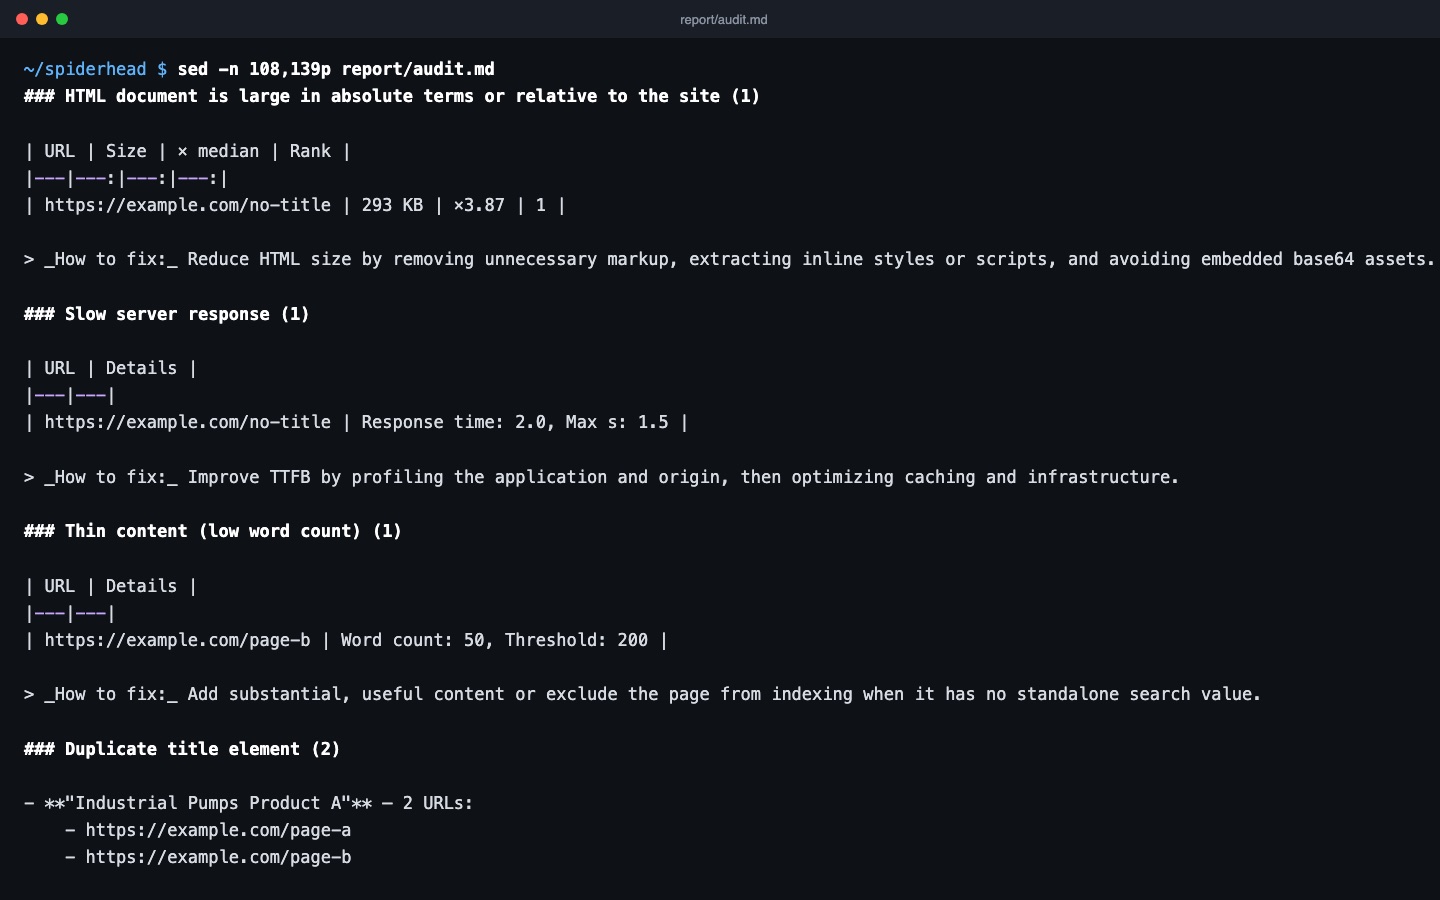
THIN_CONTENTDie Seite hat zu wenige Wörter, um in der Suche für sich allein zu bestehenImportantWortanzahl der Seite
LOW_TEXT_RATIOSichtbarer Text macht nur einen kleinen Anteil am HTML aus, das Markup überwiegt den InhaltTipText-HTML-Verhältnis der Seite
LOREM_IPSUM_PLACEHOLDERLorem-Ipsum-Platzhaltertext steht im Hauptinhaltsbereich der SeiteImportantGefundene Platzhalterpassage
READABILITY_DIFFICULTDer Text hat einen niedrigen Flesch-Lesbarkeitswert. Dies ist eine optionale Content-PrüfungTipFlesch-Wert der Seite

Ein Befehl

bash
seohead duplicate-check --scan ./scans/audit.sqlite

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Ein gespeicherter nativer Scan (SQLite) aus crawl-site, der den extrahierten Text jeder Seite speichert
  • Oder eine direkt angegebene Liste von Texten für duplicate-check
  • Keine API-Schlüssel

Grenzen

  • Die Offline-Prüfung analysiert bis zu 10.000 Dokumente und 16 MiB gespeicherten Text. Bei nur teilweiser Abdeckung weist der Bericht dies aus
  • Nicht indexierbare Seiten werden standardmäßig übersprungen
  • Verglichen wird nur der Text, den SpiderHead gespeichert hat. Dafür braucht es einen Crawl, der die Seiteninhalte behalten hat
  • Ähnlich heißt nicht immer doppelt: Der Schwellenwert ist eine Ermessensfrage

Fragen

Ändert sich dadurch etwas auf meiner Website?
Nein. Crawl und Duplicate-Prüfung lesen nur Seiten. Die Prüfung läuft offline auf der gespeicherten Scan-Datei.
Worin unterscheidet sich ein exaktes Duplikat von einem Near-Duplicate?
Ein exaktes Duplikat hat denselben Content-Hash. Ein Near-Duplicate hat andere Bytes, aber einen Text, der ähnlich genug ist, um den Schwellenwert zu erreichen. Den Schwellenwert ändern Sie mit --threshold, zwischen 0 und 1. Der Standard ist 0,92.
Werden Seiten verglichen, die nicht indexierbar sind?
Standardmäßig nicht. Verglichen werden nur indexierbare Seiten, weil eine Seite, die per Canonical auf eine andere URL verweist, kein Fehler ist. Mit --all-pages nehmen Sie auch nicht indexierbare Seiten auf.
Gibt es eine Obergrenze für die Anzahl verglichener Seiten?
Ja. Die Offline-Prüfung analysiert bis zu 10.000 Dokumente und 16 MiB gespeicherten, extrahierten Text. Wird eine Grenze erreicht, nennt der Bericht die genaue Teilabdeckung. Für nicht analysierte Seiten gibt er nie ein sauberes Ergebnis aus.
Wo ist die Boilerplate-Prüfung?
Header-, Navigations- und Footer-Markup gruppiert der eigenständige Befehl boilerplate-report. Er ist kein Teil von duplicate-check.
Brauche ich Screaming Frog?
Nein. duplicate-check liest einen Scan aus dem eigenen crawl-site von SpiderHead. Screaming-Frog-Exporte nutzt das Audit sf run für die Prüfungen auf exakte Duplikate und Thin Content.

Testen Sie es auf Ihrer eigenen Website