
Проверка дублей и тонкого контента

Находит точные дубли по хэшу содержимого, почти дубли, тонкие страницы, низкую долю текста, шаблонные блоки и заглушечный текст по всему сканированию. Работает по сохранённому скану, офлайн.

Что делает

Точные и почти дубли

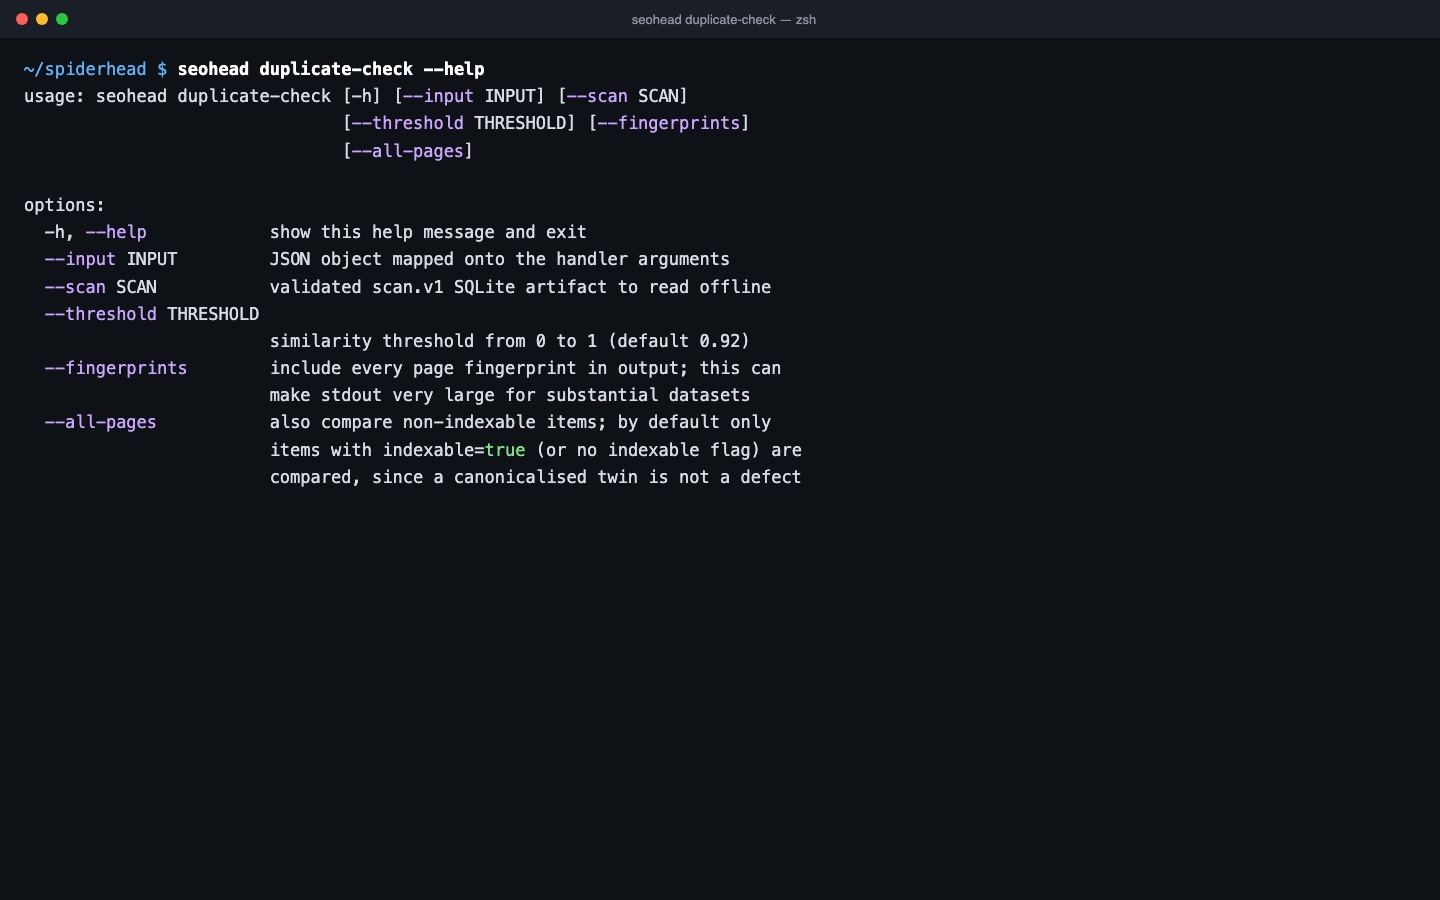
Точные копии находятся по хэшу содержимого. Почти дубли ищутся через simhash и LSH, поэтому страницы не сравниваются попарно. Порог похожести по умолчанию — 0,92. В каждой находке перечислена группа страниц: оставьте одну и объедините остальные.

  • Точные дубли по хэшу содержимого
  • Почти дубли выше порога, который можно задать от 0 до 1
  • Сравниваются только индексируемые страницы, если не передать --all-pages
  • Группы выводятся со списком страниц

Тонкий контент и заглушки

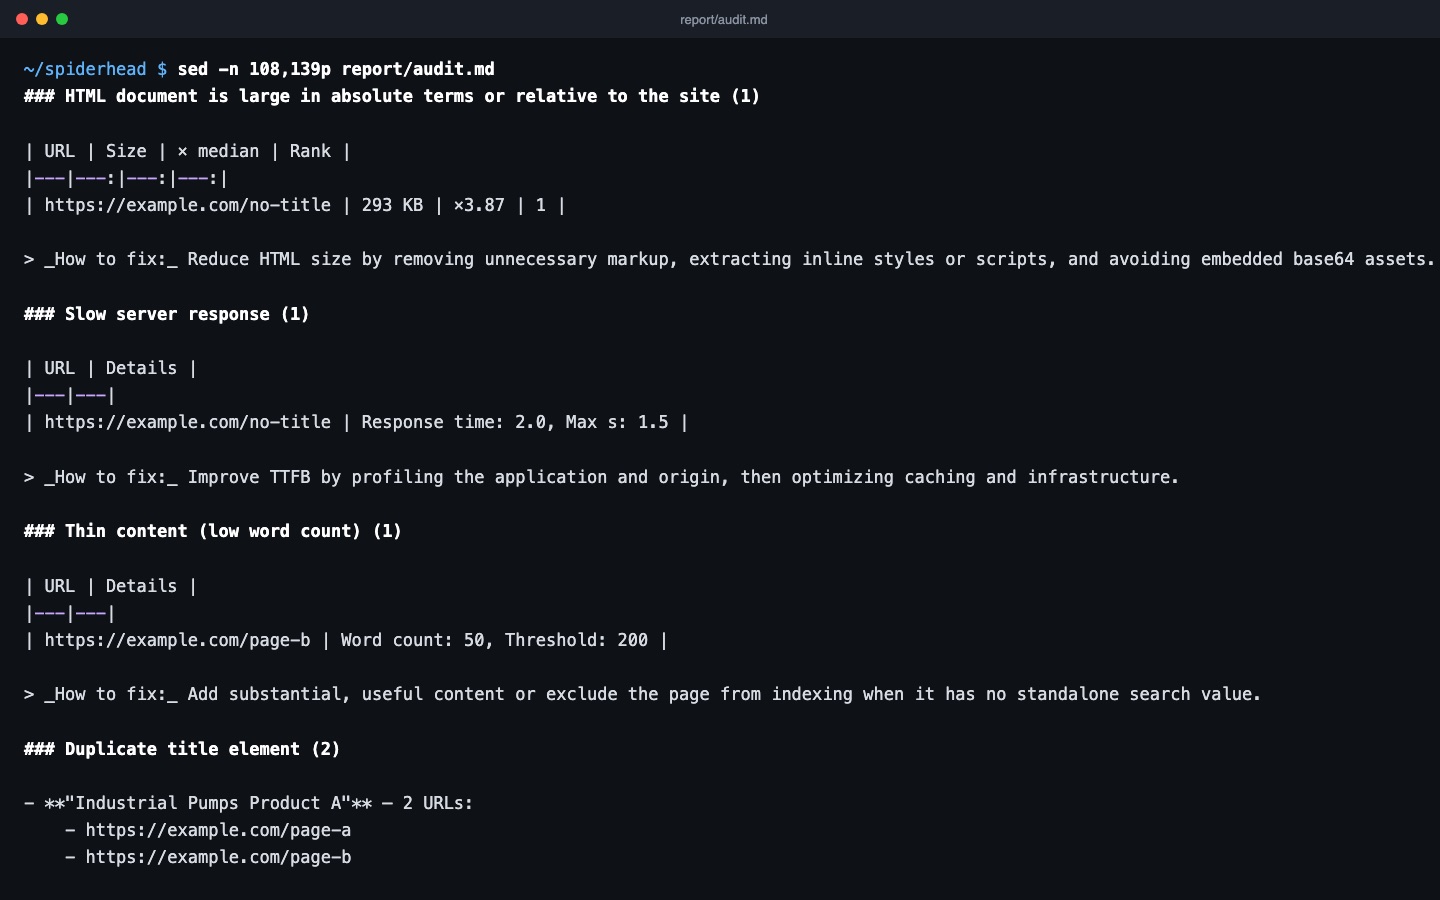
Страница с малым количеством слов, с небольшим объёмом видимого текста относительно разметки или с Lorem Ipsum в основном контенте выводится отдельным замечанием. Такие проблемы редко требуют переписать весь сайт. Чаще всего виноват шаблон, черновик или страница фильтра.

  • Тонкий контент по количеству слов
  • Низкая доля текста в HTML
  • Lorem Ipsum в области основного контента

Анализ контента

Помимо дублей, инструменты группируют разметку шапки, навигации и подвала, чтобы проверить, действительно ли шаблонные блоки одинаковы на всех страницах, и оценивают читабельность. Читабельность — необязательная проверка, которая опирается на индекс Флеша (Flesch reading ease).

  • boilerplate-report для шаблонной разметки
  • Необязательная проверка читабельности
  • Семантическое сходство — только по векторам, которые вы передаёте сами

Три шага — один сохранённый скан

  1. Соберите скан сайта

    Запустите сканирование: оно сохранит собственный скан в SQLite. В нём хранится извлечённый текст каждой страницы для офлайн-анализа.

  2. Сравните тело каждой страницы

    Точные копии находятся по хэшу содержимого. Почти дубли ищутся через simhash и LSH, поэтому страницы не сравниваются попарно.

  3. Прочитайте группы и исправьте их

    В каждой находке перечислены страницы группы. Объедините их тегом canonical или перепишите страницы так, чтобы каждая отвечала своему поисковому интенту.

Проверки в этой возможности

ПроверкаЧто значитКритичностьДоказательство
DUPLICATE_BY_HASHТело страницы совпадает с телом другой страницыImportantГруппа хэша со списком URL
NEAR_DUPLICATEТекст страницы почти совпадает с текстом другой страницы: сходство выше порога (по умолчанию 0,92)ImportantКластер похожих URL
THIN_CONTENTНа странице слишком мало слов, чтобы самостоятельно показываться в поискеImportantКоличество слов на странице
LOW_TEXT_RATIOВидимый текст занимает малую долю HTML, разметка весит больше контентаTipДоля текста к HTML на странице
LOREM_IPSUM_PLACEHOLDERЗаглушечный текст Lorem Ipsum в основной области контента страницыImportantНайденный фрагмент-заглушка
READABILITY_DIFFICULTТекст получил низкий балл по индексу читабельности Флеша. Это необязательная проверка контентаTipБалл Флеша для страницы

Одна команда

bash
seohead duplicate-check --scan ./scans/audit.sqlite

Сначала установите: руководство по установке. Каждая команда работает и как MCP-инструмент для ИИ-агентов.

Что нужно

  • Сохранённый собственный скан (SQLite) из crawl-site: в нём хранится извлечённый текст каждой страницы
  • Или список текстов, переданный прямо в duplicate-check
  • Ключи API не нужны

Ограничения

  • Офлайн-проверка анализирует до 10 000 документов и 16 МиБ сохранённого текста; частичное покрытие выводится в отчёте
  • Неиндексируемые страницы по умолчанию пропускаются
  • Сравнивается только текст, который сохранил SpiderHead, поэтому нужен скан с сохранёнными телами страниц
  • Похожее не всегда дубль: порог — это ваше решение

Вопросы

Меняет ли это что-то на моём сайте?
Нет. Сканирование и проверка дублей только читают страницы. Проверка идёт офлайн, по сохранённому файлу скана.
Чем точный дубль отличается от почти дубля?
У точного дубля совпадает хэш содержимого. У почти дубля байты разные, но текст достаточно похож, чтобы пройти порог. Порог меняется через --threshold, от 0 до 1. По умолчанию — 0,92.
Сравниваются ли неиндексируемые страницы?
По умолчанию нет. Сравниваются только индексируемые страницы: страница, которая ведёт canonical на другой URL, не считается ошибкой. Чтобы включить неиндексируемые страницы, добавьте --all-pages.
Есть ли лимит на количество сравниваемых страниц?
Да. Офлайн-проверка анализирует до 10 000 документов и 16 МиБ извлечённого текста. Если лимит достигнут, отчёт пишет точное частичное покрытие. Результат «чисто» он никогда не выводит для страниц, которые не анализировались.
Где проверка шаблонного кода?
Разметка шапки, навигации и подвала группируется отдельной командой boilerplate-report. В duplicate-check её нет.
Нужен ли Screaming Frog?
Нет. duplicate-check читает скан, сделанный собственным crawl-site SpiderHead. Экспорты Screaming Frog используются аудитом sf run для проверок точных дублей и тонкого контента.

Что ещё посмотреть

Проверьте на своём сайте