
Contrôle des contenus dupliqués et pauvres

Repérez les doublons exacts (par hash de contenu), les quasi-doublons, les pages pauvres, le faible ratio de texte, le code de gabarit et le texte de remplissage dans un crawl ou un scan enregistré, hors ligne.

Ce qu'elle fait

Doublons exacts et quasi-doublons

Les copies exactes sont repérées grâce à un hash de contenu. Les quasi-doublons sont détectés avec simhash et LSH : les pages ne sont donc pas comparées une à une. Le seuil de similarité vaut 0,92 par défaut. Chaque constat liste le groupe de pages concernées, ce qui permet de choisir celle à conserver et de consolider les autres.

  • Doublons exacts par hash de contenu
  • Quasi-doublons au-dessus d’un seuil réglable de 0 à 1
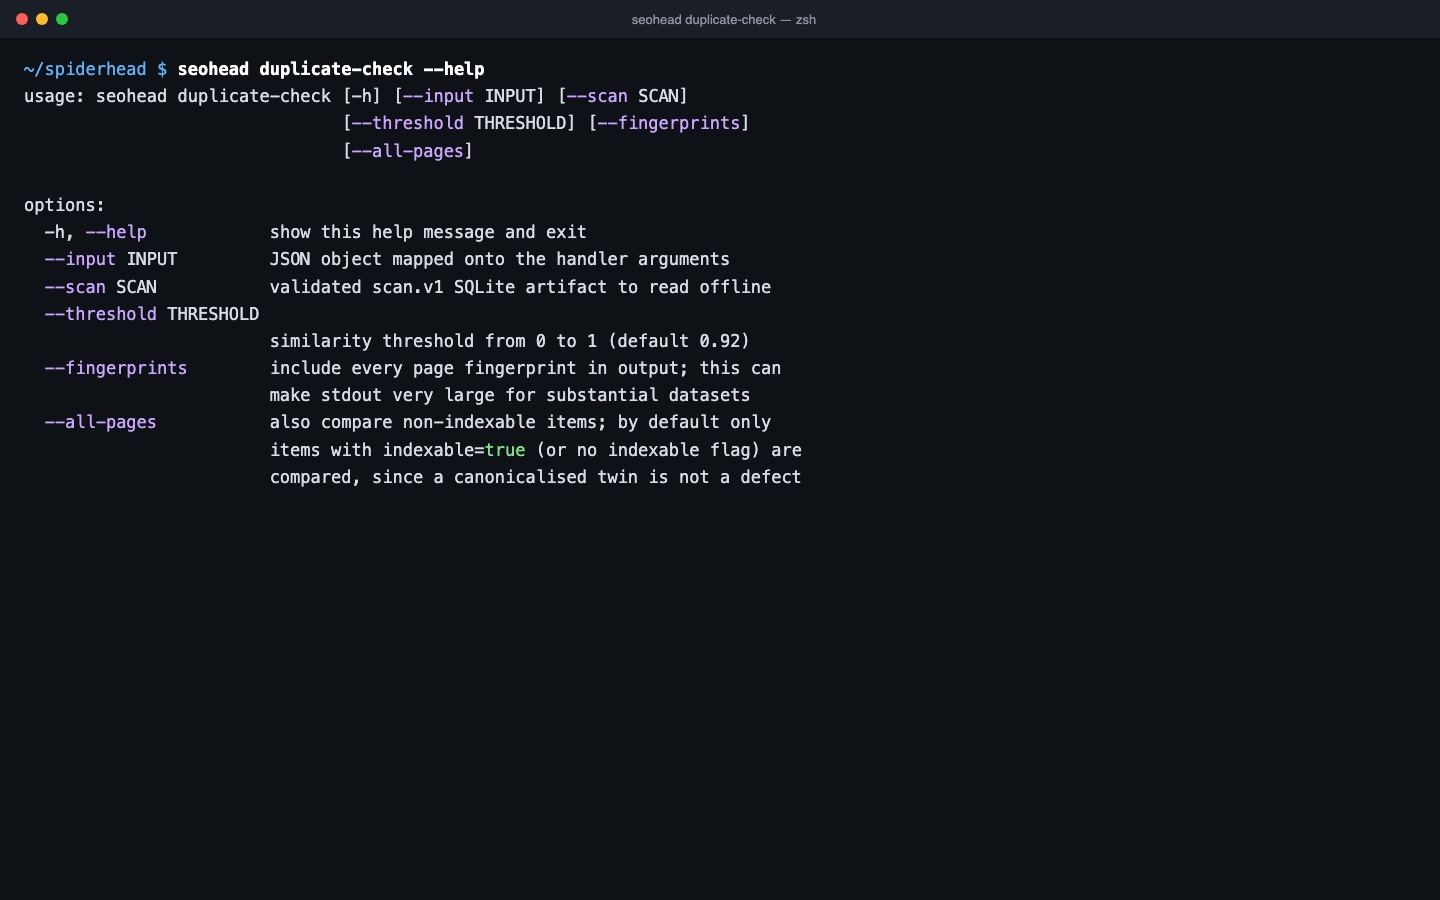
  • Seules les pages indexables sont comparées, sauf si vous passez --all-pages
  • Groupes listés avec leurs pages

Contenu pauvre et texte de remplissage

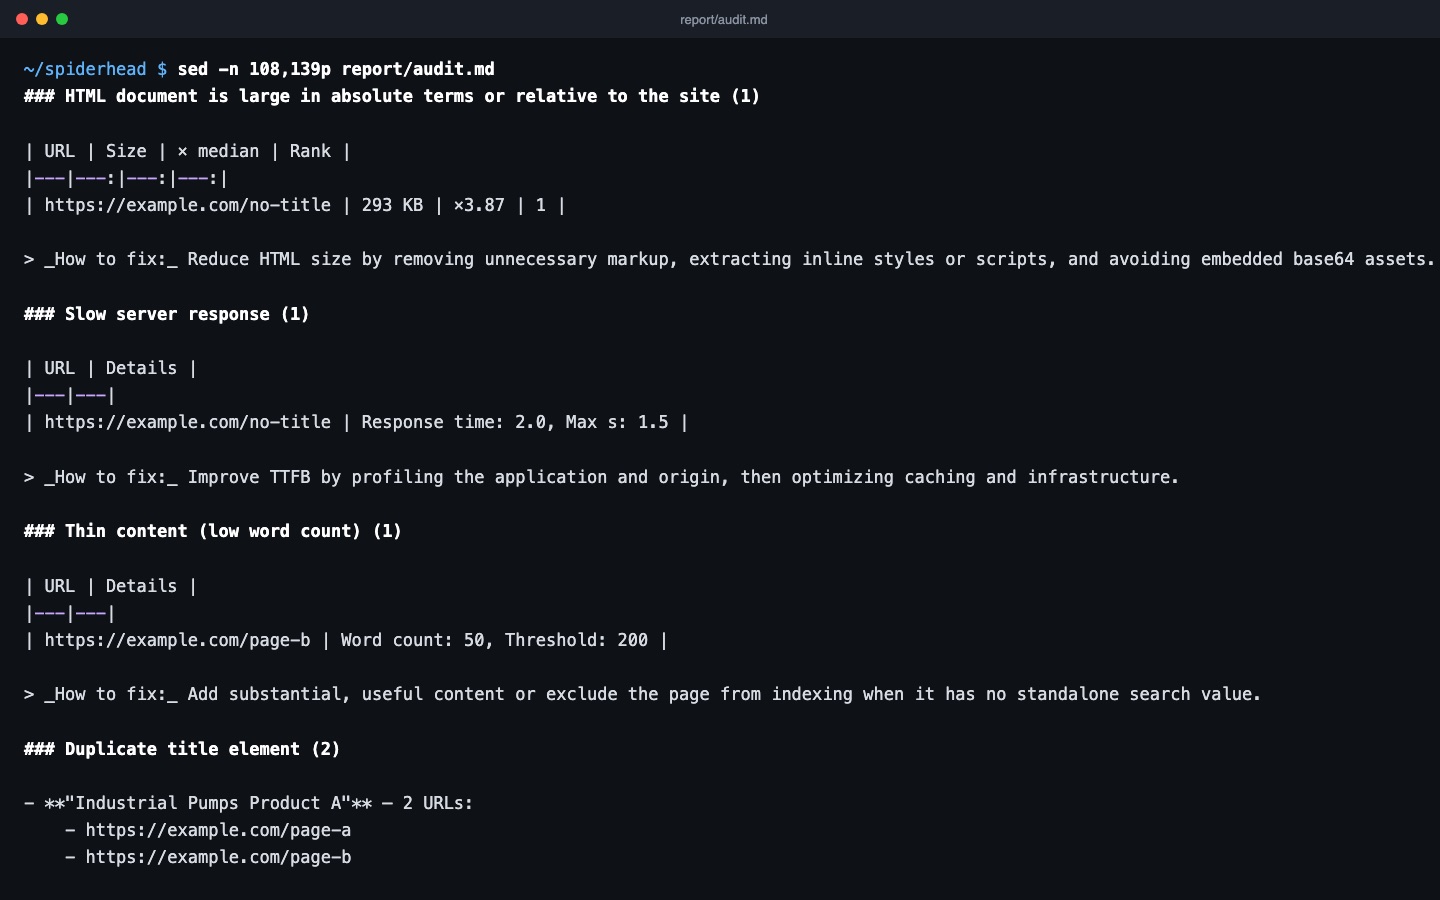
Une page avec trop peu de mots, peu de texte visible par rapport à son balisage, ou du Lorem Ipsum dans son contenu principal est signalée séparément. Ces problèmes exigent rarement de réécrire tout le site : la cause est en général un gabarit, un brouillon ou une page de filtre.

  • Contenu pauvre selon le nombre de mots
  • Faible ratio texte/HTML
  • Lorem Ipsum dans la zone de contenu principal

Analyse du contenu

Au-delà des doublons, l’outil peut regrouper le balisage de l’en-tête, de la navigation et du pied de page, pour vérifier si le code de gabarit est réellement identique partout, et évaluer la lisibilité. La lisibilité est un contrôle de contenu facultatif, fondé sur le score de lisibilité de Flesch.

  • boilerplate-report pour le balisage de gabarit
  • Contrôle de lisibilité facultatif
  • Similarité sémantique à partir des seuls vecteurs que vous fournissez

Trois étapes, un seul scan enregistré

  1. Crawler le site dans un scan

    Lancez un crawl. Il enregistre un scan natif SQLite qui conserve le texte extrait de chaque page pour l’analyse hors ligne.

  2. Comparer le corps de chaque page

    Les copies exactes sont repérées grâce au hash de contenu. Les quasi-doublons sont détectés avec simhash et LSH, sans comparaison paire à paire.

  3. Lire les groupes et corriger

    Chaque constat liste les pages de son groupe. Consolidez-les avec une balise canonical, ou réécrivez les pages pour que chacune réponde à sa propre intention de recherche.

Contrôles de cette fonctionnalité

ContrôleSignificationGravitéPreuve
DUPLICATE_BY_HASHLe corps de la page est identique à celui d’une autre pageImportantGroupe de hash avec les URL qui le partagent
NEAR_DUPLICATELe texte de la page est presque identique à celui d’une autre page, au-dessus du seuil de similarité (0,92 par défaut)ImportantGroupe d’URL similaires
THIN_CONTENTLa page a trop peu de mots pour se positionner seule dans les résultats de rechercheImportantNombre de mots de la page
LOW_TEXT_RATIOLe texte visible représente une faible part du HTML : le balisage l’emporte sur le contenuTipRatio texte/HTML de la page
LOREM_IPSUM_PLACEHOLDERDu texte de remplissage Lorem Ipsum se trouve dans la zone de contenu principal de la pageImportantPassage de remplissage repéré
READABILITY_DIFFICULTLe texte obtient un score de lisibilité de Flesch faible. Il s’agit d’un contrôle de contenu facultatifTipScore de Flesch de la page

Une seule commande

bash
seohead duplicate-check --scan ./scans/audit.sqlite

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Un scan natif enregistré (SQLite) issu de crawl-site, qui conserve le texte extrait de chaque page
  • Ou une liste de textes saisie directement pour duplicate-check
  • Aucune clé d’API

Limites

  • La vérification hors ligne analyse jusqu’à 10 000 documents et 16 Mo de texte conservé ; une couverture partielle est signalée
  • Les pages non indexables sont ignorées par défaut
  • Seul le texte conservé par SpiderHead est comparé : il faut donc un crawl ayant gardé le corps des pages
  • Similaire ne veut pas toujours dire dupliqué : le seuil relève d’un jugement

Questions

Est-ce que cela modifie quelque chose sur mon site ?
Non. Le crawl et le contrôle des doublons ne font que lire les pages. La vérification s’effectue hors ligne, sur le fichier de scan enregistré.
Quelle différence entre un doublon exact et un quasi-doublon ?
Un doublon exact a le même hash de contenu. Un quasi-doublon a des octets différents, mais un texte assez proche pour franchir le seuil. Vous modifiez le seuil avec --threshold, de 0 à 1. La valeur par défaut est 0,92.
Les pages non indexables sont-elles comparées ?
Non, par défaut. Seules les pages indexables sont comparées, car une page qui pointe via une balise canonical vers une autre URL n’est pas un défaut. Ajoutez --all-pages pour inclure les pages non indexables.
Existe-t-il une limite au nombre de pages comparées ?
Oui. La vérification hors ligne analyse jusqu’à 10 000 documents et 16 Mo de texte extrait conservé. Si une limite est atteinte, le rapport indique la couverture partielle exacte. Il ne déclare jamais un résultat propre pour des pages qu’il n’a pas analysées.
Où se trouve le contrôle du code de gabarit ?
Le balisage de l’en-tête, de la navigation et du pied de page est regroupé par la commande séparée boilerplate-report. Il ne fait pas partie de duplicate-check.
Ai-je besoin de Screaming Frog ?
Non. duplicate-check lit un scan produit par le crawl-site de SpiderHead. Les exports de Screaming Frog sont utilisés par sf run pour les contrôles de doublons exacts et de contenu pauvre.