
Controllo di contenuto duplicato e povero

Trova duplicati esatti per hash del contenuto, quasi duplicati, pagine povere, basso rapporto di testo, boilerplate e testo segnaposto su una scansione, su una scansione salvata, offline.

Cosa fa

Duplicati esatti e quasi

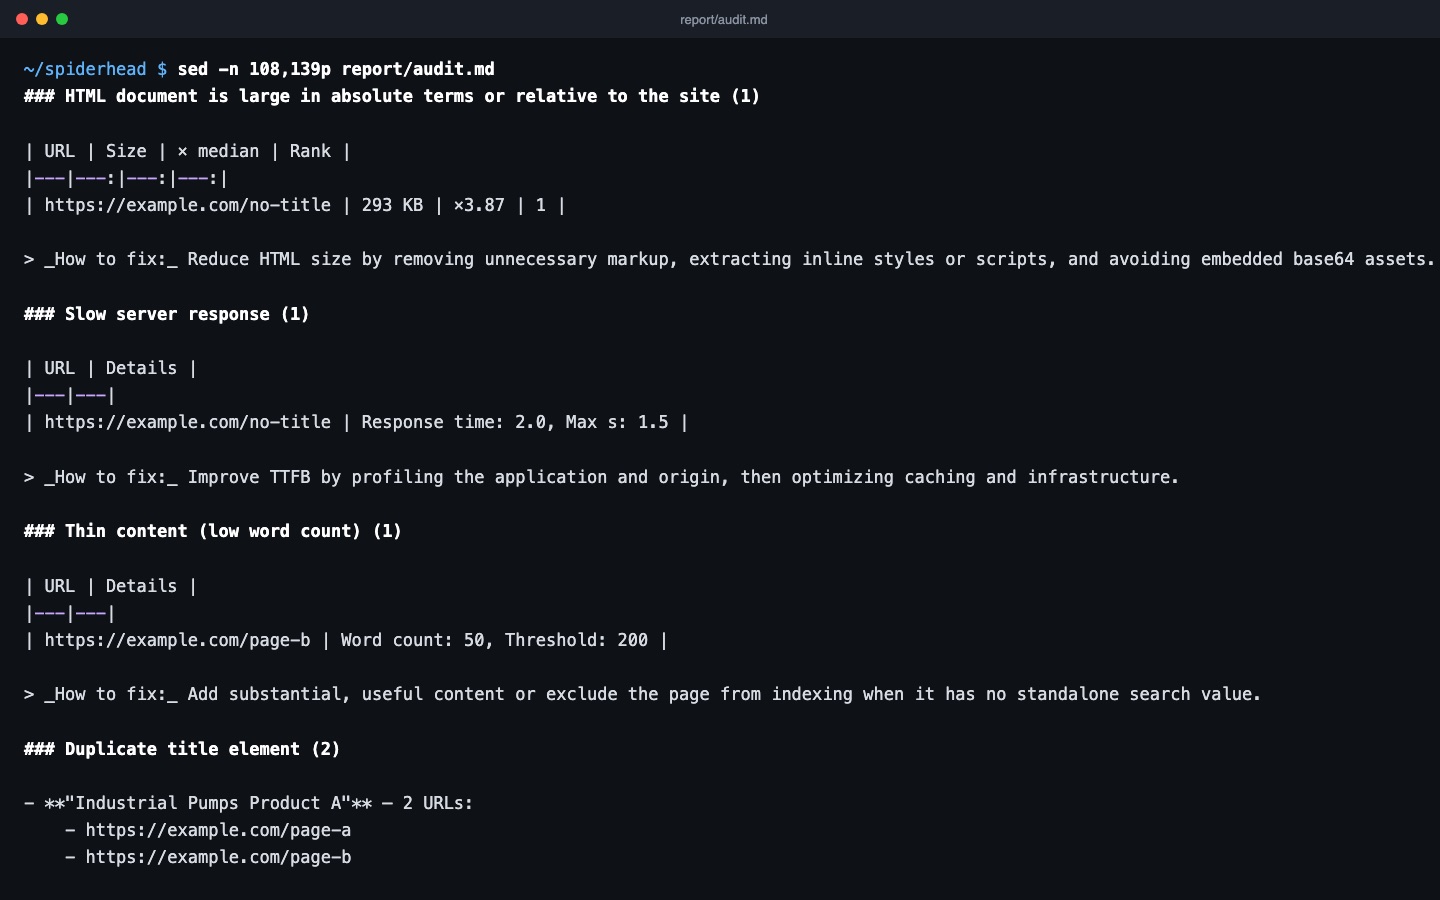
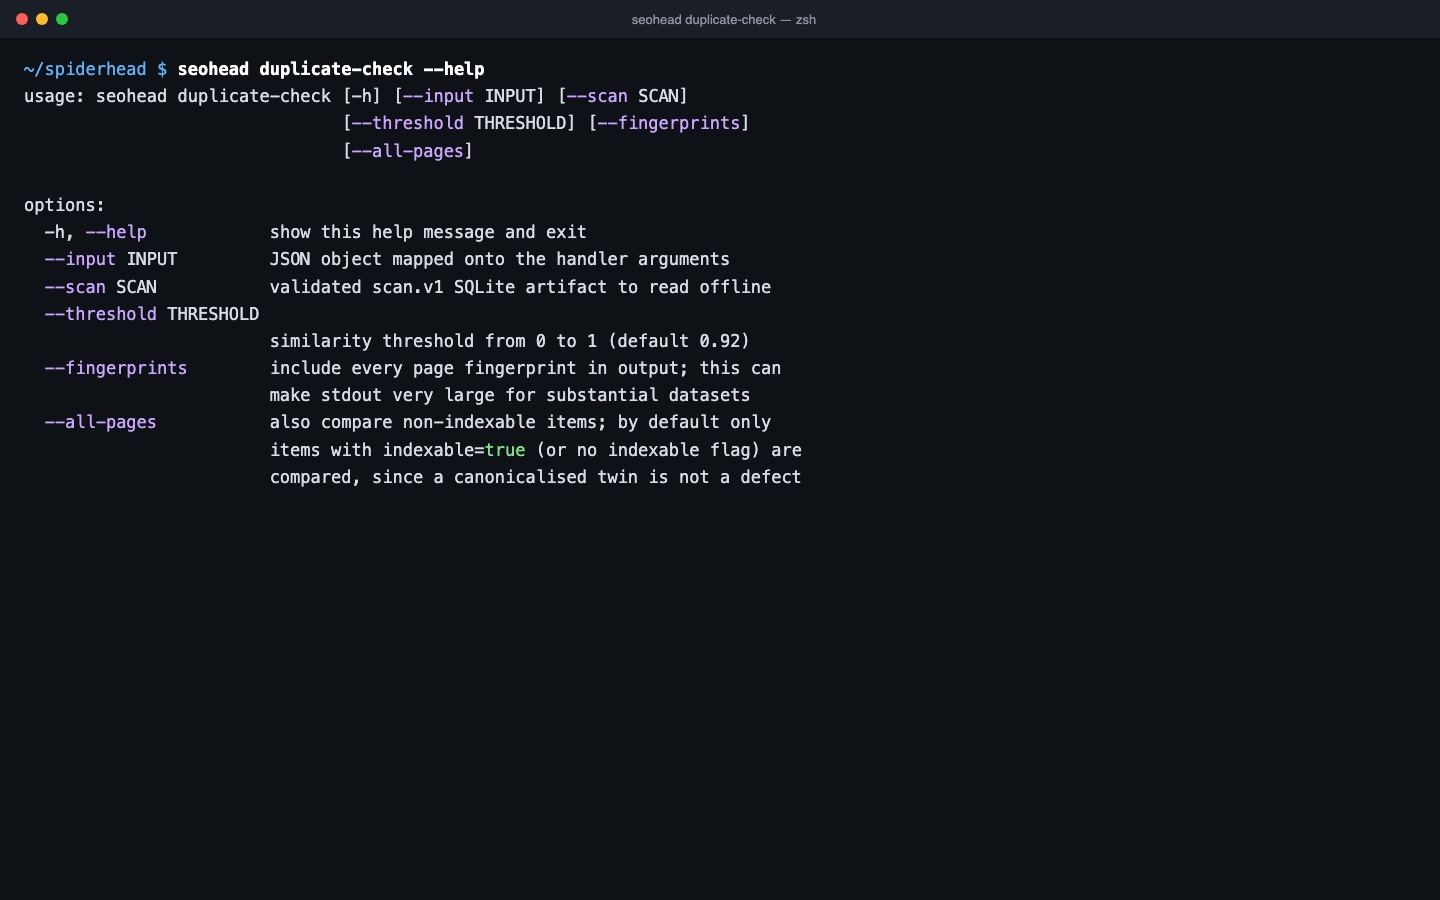
Le copie esatte si trovano per hash del contenuto. I quasi duplicati si trovano con simhash e LSH, quindi le pagine non vengono confrontate a coppie, e la soglia di similarità è 0,92 per impostazione predefinita. Ogni segnalazione elenca il gruppo di pagine, così scegli quale tenere e consolidi le altre.

  • Duplicati esatti per hash del contenuto
  • Quasi duplicati oltre una soglia che puoi impostare da 0 a 1
  • Solo le pagine indicizzabili vengono confrontate, salvo passare --all-pages
  • Gruppi elencati con le loro pagine

Contenuto povero e segnaposto

Una pagina con troppo poche parole, con poco testo visibile rispetto al suo markup, o con Lorem Ipsum nel contenuto principale è segnalata per conto suo. Questi problemi raramente richiedono la riscrittura dell'intero sito. Di solito la causa è un template, una bozza o una pagina filtro.

  • Contenuto povero per numero di parole
  • Basso rapporto testo-HTML
  • Lorem Ipsum nell'area del contenuto principale

Analisi del contenuto

Oltre ai duplicati, gli strumenti sanno raggruppare il markup di header, navigazione e footer per vedere se il boilerplate è davvero lo stesso ovunque, e valutare la leggibilità. La leggibilità è un controllo dei contenuti opzionale basato sul punteggio Flesch reading-ease.

  • boilerplate-report per il markup dei template
  • Controllo di leggibilità opzionale
  • Similarità semantica solo da vettori che fornisci tu

Tre passaggi, una scansione salvata

  1. Scansiona il sito in una scansione

    Esegui una scansione. Salva una scansione nativa SQLite che conserva il testo estratto di ogni pagina per l'analisi offline.

  2. Confronta ogni corpo pagina

    Le copie esatte si trovano per hash del contenuto. I quasi duplicati con simhash e LSH, quindi le pagine non vengono confrontate a coppie.

  3. Leggi i gruppi e correggili

    Ogni segnalazione elenca le pagine del suo gruppo. Consolida con un tag canonical o riscrivi le pagine così che ognuna serva la sua intenzione di ricerca.

Controlli di questa funzionalità

ControlloCosa significaGravitàEvidenza
DUPLICATE_BY_HASHIl corpo della pagina è identico al corpo di un'altra paginaImportantGruppo di hash con le URL che lo condividono
NEAR_DUPLICATEIl testo della pagina è quasi identico a quello di un'altra, oltre la soglia di similarità (predefinito 0,92)ImportantCluster di URL simili
THIN_CONTENTLa pagina ha troppo poche parole per reggersi da sola nella ricercaImportantConteggio parole della pagina
LOW_TEXT_RATIOIl testo visibile è una piccola parte dell'HTML, quindi il markup pesa più del contenutoTipRapporto testo-HTML della pagina
LOREM_IPSUM_PLACEHOLDERTesto segnaposto Lorem Ipsum nell'area del contenuto principale della paginaImportantPassaggio segnaposto trovato
READABILITY_DIFFICULTIl testo ha un punteggio Flesch reading-ease basso. È un controllo dei contenuti opzionaleTipPunteggio Flesch della pagina

Un solo comando

bash
seohead duplicate-check --scan ./scans/audit.sqlite

Prima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.

Cosa ti serve

  • Una scansione nativa salvata (SQLite) da crawl-site, che conserva il testo estratto di ogni pagina
  • Oppure una lista di testi in linea per duplicate-check
  • Nessuna chiave API

Limiti

  • Il controllo offline analizza fino a 10.000 documenti e 16 MiB di testo conservato; la copertura parziale è riportata
  • Le pagine non indicizzabili sono saltate per impostazione predefinita
  • Viene confrontato solo il testo conservato da SpiderHead, quindi serve una scansione che abbia tenuto i corpi
  • Simile non è sempre duplicato: una soglia è una questione di giudizio

Domande

Cambia qualcosa sul mio sito?
No. La scansione e il controllo dei duplicati si limitano a leggere le pagine. Il controllo gira offline sul file di scansione salvato.
Che differenza c'è tra duplicato esatto e quasi duplicato?
Un duplicato esatto ha lo stesso hash di contenuto. Un quasi duplicato ha byte diversi ma un testo abbastanza simile da superare la soglia. Puoi cambiare la soglia con --threshold, da 0 a 1. Il predefinito è 0,92.
Le pagine non indicizzabili vengono confrontate?
Non per impostazione predefinita. Solo le pagine indicizzabili vengono confrontate, perché una pagina che canonicalizza verso un'altra URL non è un difetto. Aggiungi --all-pages per includere le pagine non indicizzabili.
C'è un limite al numero di pagine confrontate?
Sì. Il controllo offline analizza fino a 10.000 documenti e 16 MiB di testo estratto conservato. Se un limite viene raggiunto, il rapporto dichiara l'esatta copertura parziale. Non riporta mai un risultato pulito per pagine che non ha analizzato.
Dov'è il controllo del boilerplate?
Il markup di header, nav e footer è raggruppato dal comando separato boilerplate-report. Non fa parte di duplicate-check.
Serve Screaming Frog?
No. duplicate-check legge una scansione fatta dal crawl-site di SpiderHead. Gli export Screaming Frog sono usati dall'audit sf run per i controlli su duplicati esatti e contenuto povero.