
Verificador de conteúdo duplicado e raso

Encontre duplicados exatos pelo hash do conteúdo, quase duplicados, páginas rasas, baixa proporção de texto, boilerplate e textos de preenchimento em um rastreamento ou num scan salvo, offline.

O que faz

Duplicados exatos e quase duplicados

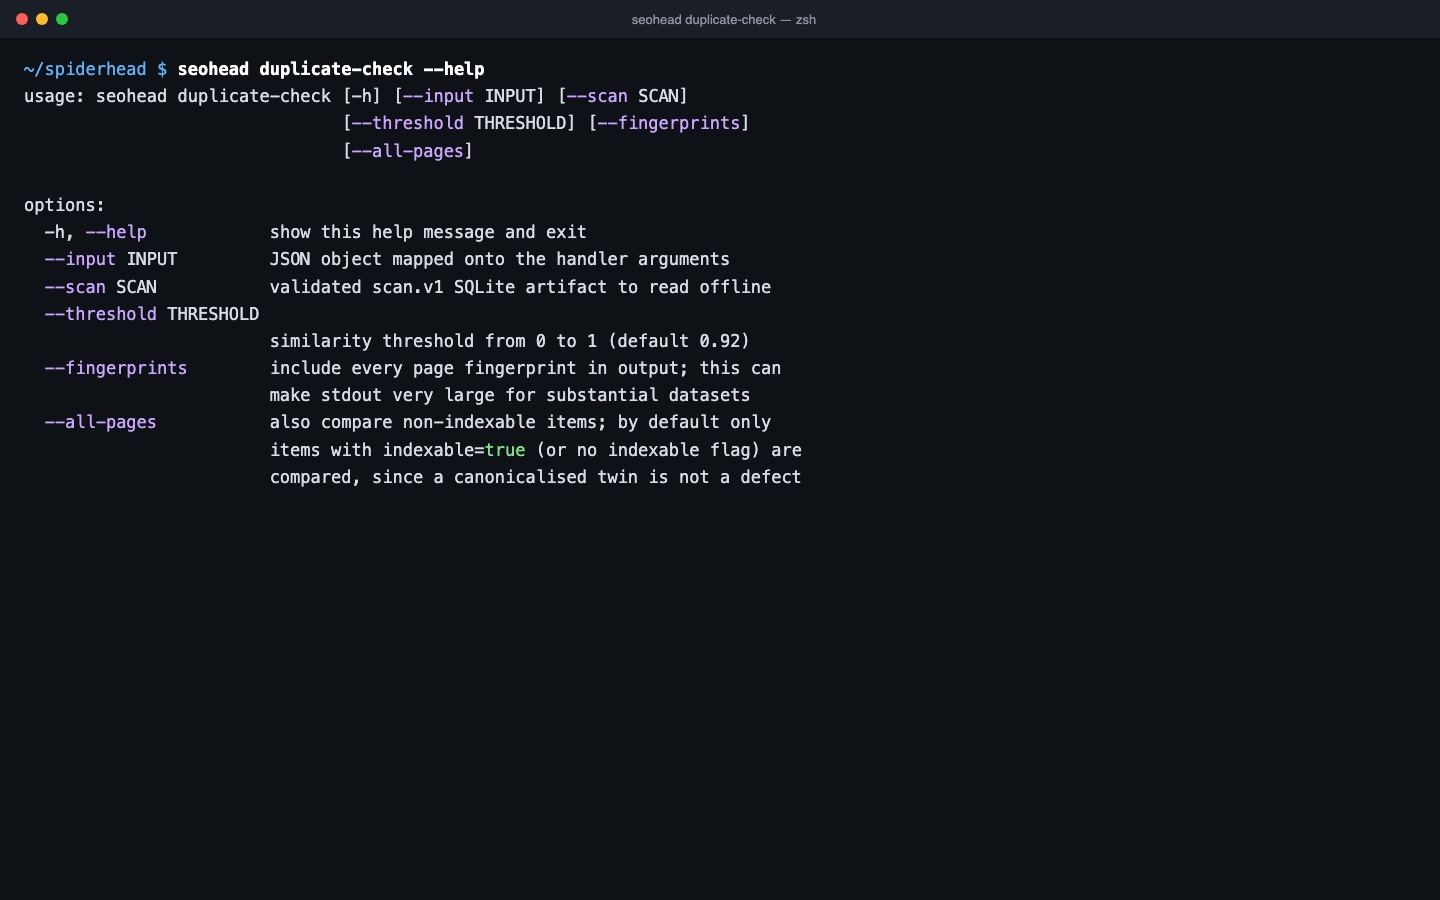
Cópias exatas são encontradas pelo hash do conteúdo. Quase duplicados são encontrados com simhash e LSH, então as páginas não são comparadas par a par. O limite de similaridade é 0,92 por padrão. Cada problema lista o grupo de páginas, para você escolher uma que fica e consolidar as demais.

  • Duplicados exatos pelo hash do conteúdo
  • Quase duplicados acima de um limite que você define de 0 a 1
  • Só páginas indexáveis são comparadas, a menos que você use --all-pages
  • Grupos listados com as respectivas páginas

Conteúdo raso e texto de preenchimento

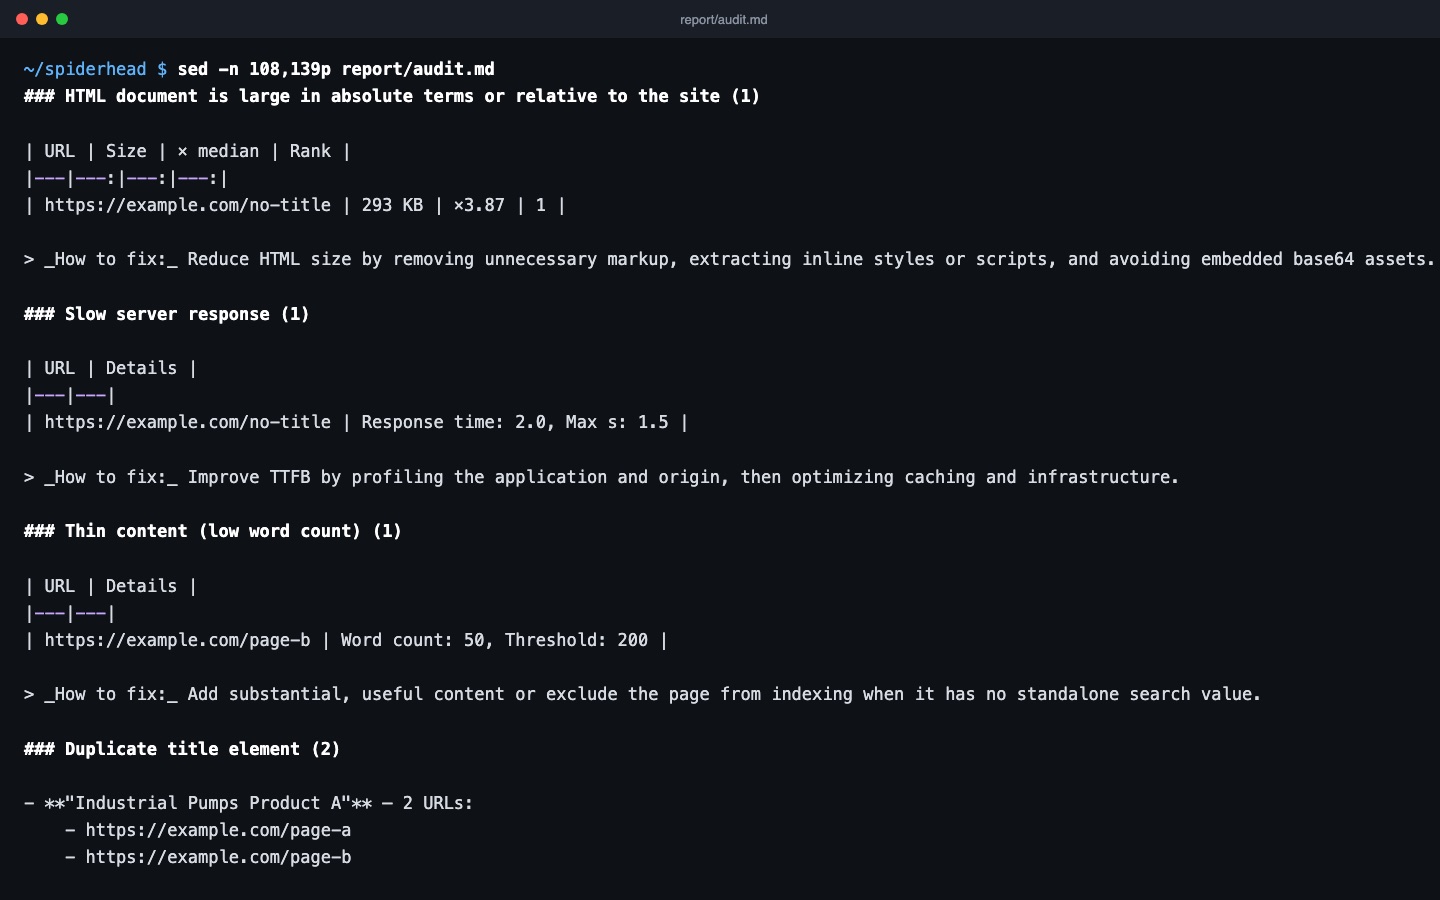
Uma página com poucas palavras, com pouco texto visível em relação à marcação HTML, ou com Lorem Ipsum no conteúdo principal é reportada à parte. Esses problemas raramente exigem reescrever o site inteiro. Geralmente a causa é um template, um rascunho ou uma página de filtro.

  • Conteúdo raso pela contagem de palavras
  • Baixa proporção entre texto e HTML
  • Lorem Ipsum na área de conteúdo principal

Análise de conteúdo

Além dos duplicados, as ferramentas agrupam a marcação de cabeçalho, navegação e rodapé para ver se o boilerplate é realmente igual em todas as páginas, e calculam a legibilidade. A legibilidade é uma verificação opcional de conteúdo, baseada no índice de facilidade de leitura de Flesch.

  • boilerplate-report para a marcação de template
  • Verificação opcional de legibilidade
  • Similaridade semântica apenas a partir de vetores que você fornecer

Três passos, um rastreamento salvo

  1. Rastreie o site em um scan

    Faça um rastreamento. Ele salva um scan nativo em SQLite que guarda o texto extraído de cada página para análise offline.

  2. Compare o corpo de todas as páginas

    Cópias exatas são encontradas pelo hash do conteúdo. Quase duplicados são encontrados com simhash e LSH, então as páginas não são comparadas par a par.

  3. Leia os grupos e corrija

    Cada problema lista as páginas do seu grupo. Consolide com uma tag canonical ou reescreva as páginas para que cada uma atenda à sua própria intenção de busca.

Verificações deste recurso

VerificaçãoO que significaGravidadeEvidência
DUPLICATE_BY_HASHO corpo da página é idêntico ao de outra páginaImportantGrupo de hash com as URLs que o compartilham
NEAR_DUPLICATEO texto da página é quase idêntico ao de outra página, acima do limite de similaridade (padrão 0,92)ImportantCluster de URLs semelhantes
THIN_CONTENTA página tem palavras insuficientes para se sustentar sozinha na buscaImportantContagem de palavras da página
LOW_TEXT_RATIOO texto visível é uma parcela pequena do HTML, então a marcação pesa mais que o conteúdoTipProporção entre texto e HTML da página
LOREM_IPSUM_PLACEHOLDERHá texto de preenchimento Lorem Ipsum na área de conteúdo principal da páginaImportantTrecho de placeholder encontrado
READABILITY_DIFFICULTO texto tem índice baixo de facilidade de leitura de Flesch. Esta é uma verificação opcional de conteúdoTipÍndice Flesch da página

Um comando

bash
seohead duplicate-check --scan ./scans/audit.sqlite

Instale primeiro: guia de instalação. Todo comando também funciona como ferramenta MCP para agentes de IA.

O que você precisa

  • Um scan nativo salvo (SQLite) feito pelo crawl-site, que guarda o texto extraído de cada página
  • Ou uma lista de textos inline para o duplicate-check
  • Sem chaves de API

Limites

  • A verificação offline analisa até 10.000 documentos e 16 MiB de texto guardado; a cobertura parcial é informada
  • Páginas não indexáveis são ignoradas por padrão
  • Só é comparado o texto que o SpiderHead guardou, então é preciso um rastreamento que tenha guardado o corpo das páginas
  • Similar nem sempre é duplicado: o limite é uma questão de critério

Perguntas

A ferramenta altera algo no meu site?
Não. O rastreamento e a verificação de duplicados apenas leem as páginas. A verificação roda offline, sobre o arquivo do scan salvo.
Qual é a diferença entre duplicado exato e quase duplicado?
Um duplicado exato tem o mesmo hash do conteúdo. Um quase duplicado tem bytes diferentes, mas um texto parecido o bastante para passar do limite. Você muda o limite com --threshold, de 0 a 1. O padrão é 0,92.
Páginas não indexáveis são comparadas?
Não por padrão. Só páginas indexáveis são comparadas, porque uma página com canonical apontando para outra URL não é um defeito. Adicione --all-pages para incluir páginas não indexáveis.
Existe limite de quantas páginas são comparadas?
Sim. A verificação offline analisa até 10.000 documentos e 16 MiB de texto extraído guardado. Se um limite for atingido, o relatório informa a cobertura parcial exata. Ele nunca informa resultado limpo para páginas que não foram analisadas.
Onde fica a verificação de boilerplate?
A marcação de cabeçalho, navegação e rodapé é agrupada pelo comando separado boilerplate-report. Ela não faz parte do duplicate-check.
Preciso do Screaming Frog?
Não. O duplicate-check lê um scan feito pelo próprio crawl-site do SpiderHead. As exportações do Screaming Frog são usadas pela auditoria sf run nas verificações de duplicados exatos e de conteúdo raso.

Teste no seu próprio site