
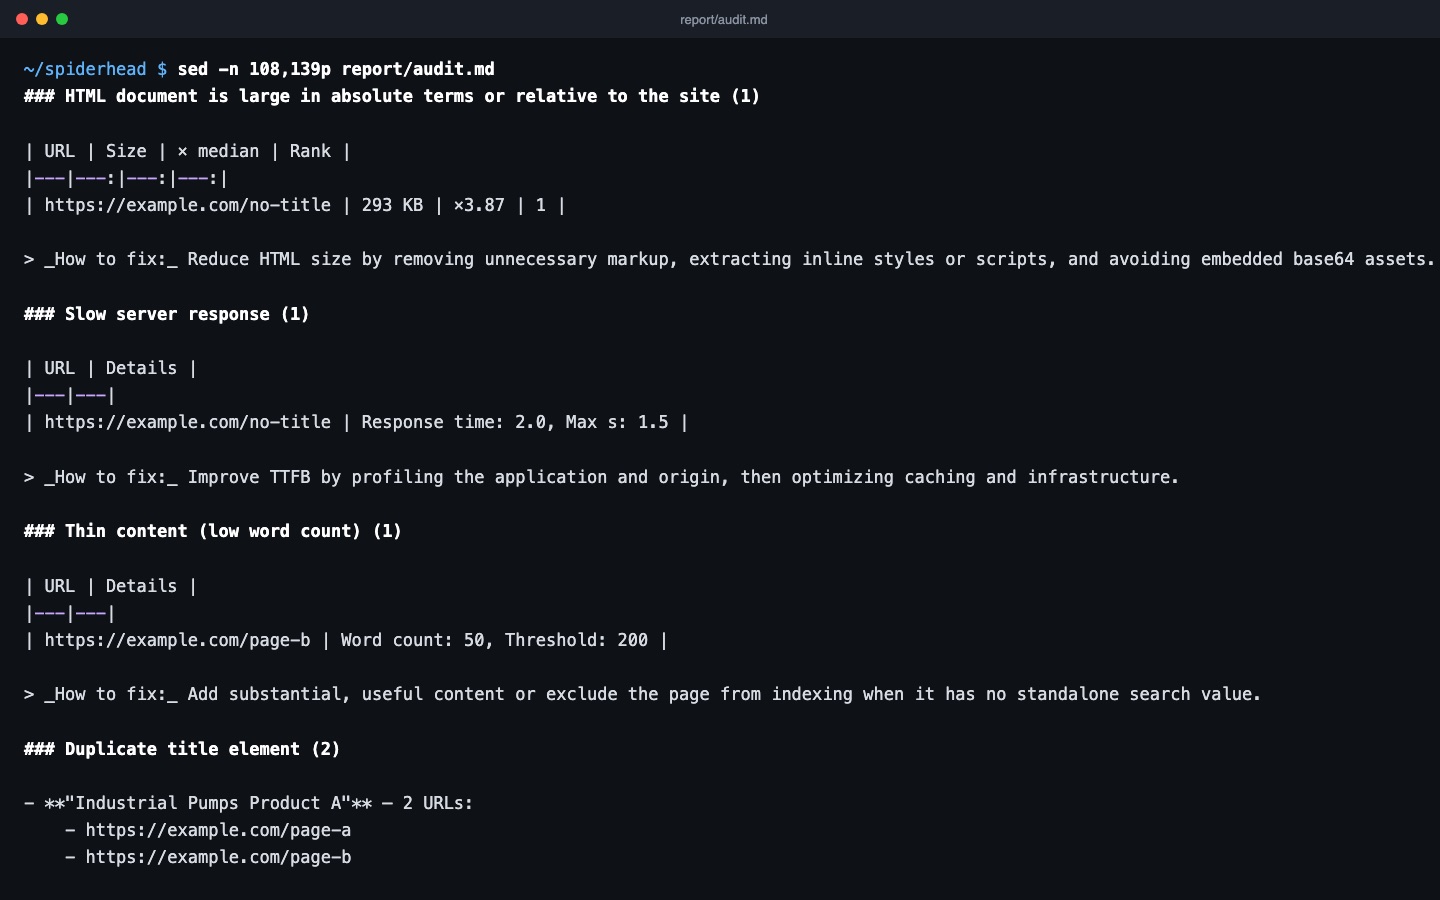
Comprobador de contenido duplicado y pobre

Encuentra duplicados exactos por hash de contenido, casi duplicados, páginas con contenido pobre, baja proporción de texto, boilerplate y texto de relleno en todo un rastreo. Funciona sobre un escaneo guardado y sin conexión.

Qué hace

Duplicados exactos y casi duplicados

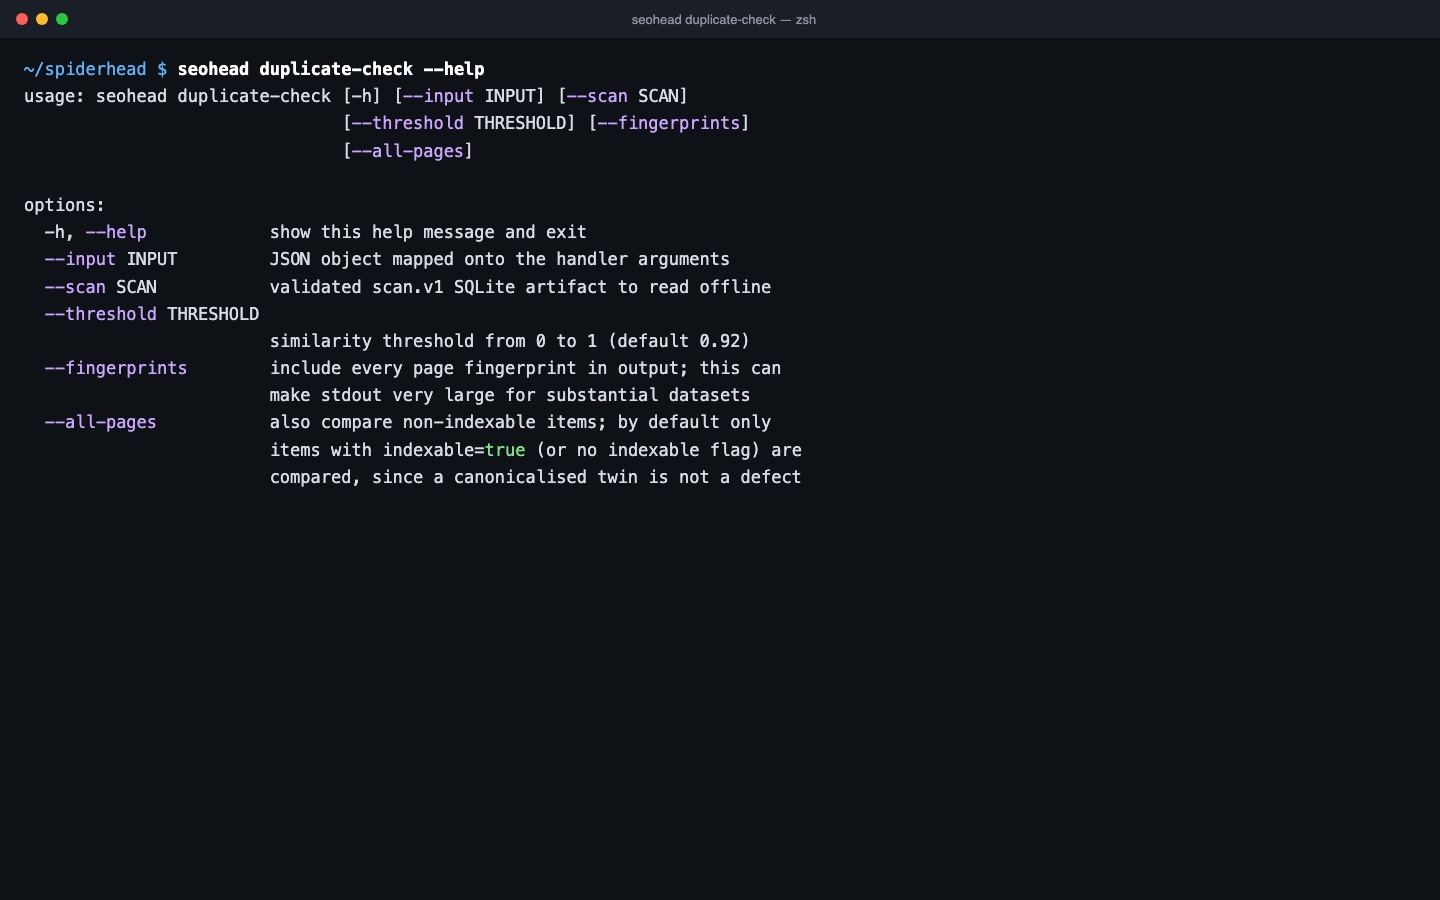
Las copias exactas se encuentran por hash de contenido. Los casi duplicados se detectan con simhash y LSH, así que las páginas no se comparan una por una. El umbral de similitud es 0,92 por defecto. Cada incidencia muestra el grupo de páginas, para que elijas cuál conservar y consolides el resto.

  • Duplicados exactos por hash de contenido
  • Casi duplicados por encima de un umbral que puedes fijar entre 0 y 1
  • Solo se comparan páginas indexables, salvo que uses --all-pages
  • Grupos mostrados con sus páginas

Contenido pobre y texto de relleno

Una página con muy pocas palabras, con poco texto visible en comparación con su marcado, o con Lorem Ipsum en su contenido principal se informa por separado. Estos problemas rara vez requieren reescribir todo el sitio. Normalmente la causa es una plantilla, un borrador o una página de filtro.

  • Contenido pobre por número de palabras
  • Baja proporción de texto frente a HTML
  • Lorem Ipsum en el área de contenido principal

Análisis de contenido

Más allá de los duplicados, las herramientas pueden agrupar el marcado de cabecera, navegación y pie para ver si el boilerplate es realmente igual en todas partes, y puntuar la legibilidad. La legibilidad es una comprobación de contenido opcional basada en la puntuación de facilidad de lectura de Flesch.

  • boilerplate-report para el marcado de plantilla
  • Comprobación de legibilidad opcional
  • Similitud semántica solo a partir de vectores que tú aportas

Tres pasos, un análisis guardado

  1. Rastrea el sitio en un escaneo

    Lanza un rastreo. Guarda un escaneo nativo en SQLite que conserva el texto extraído de cada página para analizarlo sin conexión.

  2. Compara el cuerpo de cada página

    Las copias exactas se encuentran por hash de contenido. Los casi duplicados se detectan con simhash y LSH, así que las páginas no se comparan una por una.

  3. Revisa los grupos y corrígelos

    Cada incidencia lista las páginas de su grupo. Consolídalas con una etiqueta canonical o reescribe las páginas para que cada una responda a su propia intención de búsqueda.

Comprobaciones de esta función

ComprobaciónQué significaGravedadEvidencia
DUPLICATE_BY_HASHEl cuerpo de la página es idéntico al de otra páginaImportantGrupo de hash con las URL que lo comparten
NEAR_DUPLICATEEl texto de la página es casi idéntico al de otra, por encima del umbral de similitud (0,92 por defecto)ImportantGrupo de URL similares
THIN_CONTENTLa página tiene muy pocas palabras para sostenerse por sí sola en la búsquedaImportantNúmero de palabras de la página
LOW_TEXT_RATIOEl texto visible es una parte pequeña del HTML, así que el marcado pesa más que el contenidoTipProporción de texto frente a HTML de la página
LOREM_IPSUM_PLACEHOLDERHay texto de relleno Lorem Ipsum en el área de contenido principal de la páginaImportantFragmento de relleno encontrado
READABILITY_DIFFICULTEl texto tiene una puntuación Flesch de facilidad de lectura baja. Es una comprobación de contenido opcionalTipPuntuación Flesch de la página

Un solo comando

bash
seohead duplicate-check --scan ./scans/audit.sqlite

Primero, instala SpiderHead: guía de instalación. Cada comando también funciona como herramienta MCP para agentes de IA.

Qué necesitas

  • Un escaneo nativo guardado (SQLite) de crawl-site, que conserva el texto extraído de cada página
  • O una lista en línea de textos para duplicate-check
  • Sin claves de API

Límites

  • La comprobación sin conexión analiza hasta 10 000 documentos y 16 MiB de texto conservado; si la cobertura es parcial, se indica.
  • Las páginas no indexables se omiten por defecto.
  • Solo se compara el texto que SpiderHead conservó, así que hace falta un rastreo que guardara el cuerpo de las páginas.
  • Parecido no siempre es duplicado: el umbral depende de tu criterio.

Preguntas

¿Cambia algo en mi sitio?
No. El rastreo y la comprobación de duplicados solo leen páginas. La comprobación se ejecuta sin conexión sobre el archivo de escaneo guardado.
¿Cuál es la diferencia entre un duplicado exacto y un casi duplicado?
Un duplicado exacto tiene el mismo hash de contenido. Un casi duplicado tiene bytes distintos, pero un texto lo bastante parecido como para superar el umbral. Puedes cambiar el umbral con --threshold, entre 0 y 1. El valor por defecto es 0,92.
¿Se comparan las páginas no indexables?
No por defecto. Solo se comparan las páginas indexables, porque una página que apunta con canonical a otra URL no es un defecto. Añade --all-pages para incluir las páginas no indexables.
¿Hay un límite en el número de páginas que se comparan?
Sí. La comprobación sin conexión analiza hasta 10 000 documentos y 16 MiB de texto extraído conservado. Si se alcanza un límite, el informe indica la cobertura parcial exacta. Nunca da un resultado limpio para páginas que no analizó.
¿Dónde está la comprobación de boilerplate?
El marcado de cabecera, navegación y pie se agrupa con el comando boilerplate-report, que es independiente. No forma parte de duplicate-check.
¿Necesito Screaming Frog?
No. duplicate-check lee un escaneo hecho por el propio crawl-site de SpiderHead. Las exportaciones de Screaming Frog las usa la auditoría sf run para las comprobaciones de duplicados exactos y de contenido pobre.

Pruébalo en tu propio sitio