
重複コンテンツと薄いコンテンツのチェッカー

クロールで保存したスキャンを使い、オフラインで確認します。コンテンツハッシュによる完全一致の重複、類似コンテンツ、内容の薄いページ、テキスト比率の低いページ、共通部分のマークアップ、ダミーテキストを検出します。

できること

完全一致の重複と類似コンテンツ

完全一致のコピーは、コンテンツハッシュで検出します。類似コンテンツの検出にはsimhashとLSHを使うため、ページを総当たりで比較することはありません。類似度のしきい値の初期値は0.92です。検出結果にはページのグループが一覧で出るので、残すページを1つ選んで、ほかを統合できます。

  • コンテンツハッシュによる完全一致の重複
  • 0から1の間で設定できるしきい値を超える類似コンテンツ
  • 比較するのは、インデックス可能なページだけです(--all-pagesを指定した場合を除く)
  • グループごとにページを一覧表示

内容の薄いコンテンツとダミーテキスト

語数が少なすぎるページ、マークアップに比べて表示テキストが少ないページ、メインコンテンツにLorem Ipsumが残っているページは、それぞれ個別に報告されます。これらの問題は、サイト全体を書き直さなくても解決できる場合がほとんどです。原因は、テンプレート、下書き、フィルターページであることが多いためです。

  • 語数による、内容の薄いコンテンツ
  • テキストとHTMLの比率が低いページ
  • メインコンテンツ領域にあるLorem Ipsum

コンテンツ分析

重複の検出に加えて、ヘッダー、ナビゲーション、フッターのマークアップをグループ化し、共通部分が本当にすべてのページで同じかを確認できます。読みやすさのスコアも出せます。読みやすさは任意のコンテンツチェックで、Fleschの読みやすさスコアに基づきます。

  • テンプレートのマークアップを調べるboilerplate-report
  • 任意の読みやすさチェック
  • 意味的な類似度は、自分で用意したベクトルがある場合のみ

3ステップで、スキャンを1件保存

  1. サイトをクロールしてスキャンを作成

    クロールを実行します。各ページから抽出したテキストを保存した、ネイティブのSQLiteスキャンができ、オフライン分析に使えます。

  2. すべてのページ本文を比較

    完全一致のコピーは、コンテンツハッシュで検出します。類似コンテンツの検出にはsimhashとLSHを使うため、ページを総当たりで比較することはありません。

  3. グループを確認して修正

    検出結果ごとに、グループに含まれるページが一覧に出ます。canonicalタグで統合するか、各ページが固有の検索意図に応えるよう書き直します。

この機能のチェック項目

チェック項目意味重要度根拠
DUPLICATE_BY_HASHページ本文が、別のページの本文と完全に同じですImportantハッシュが同じURLのグループ
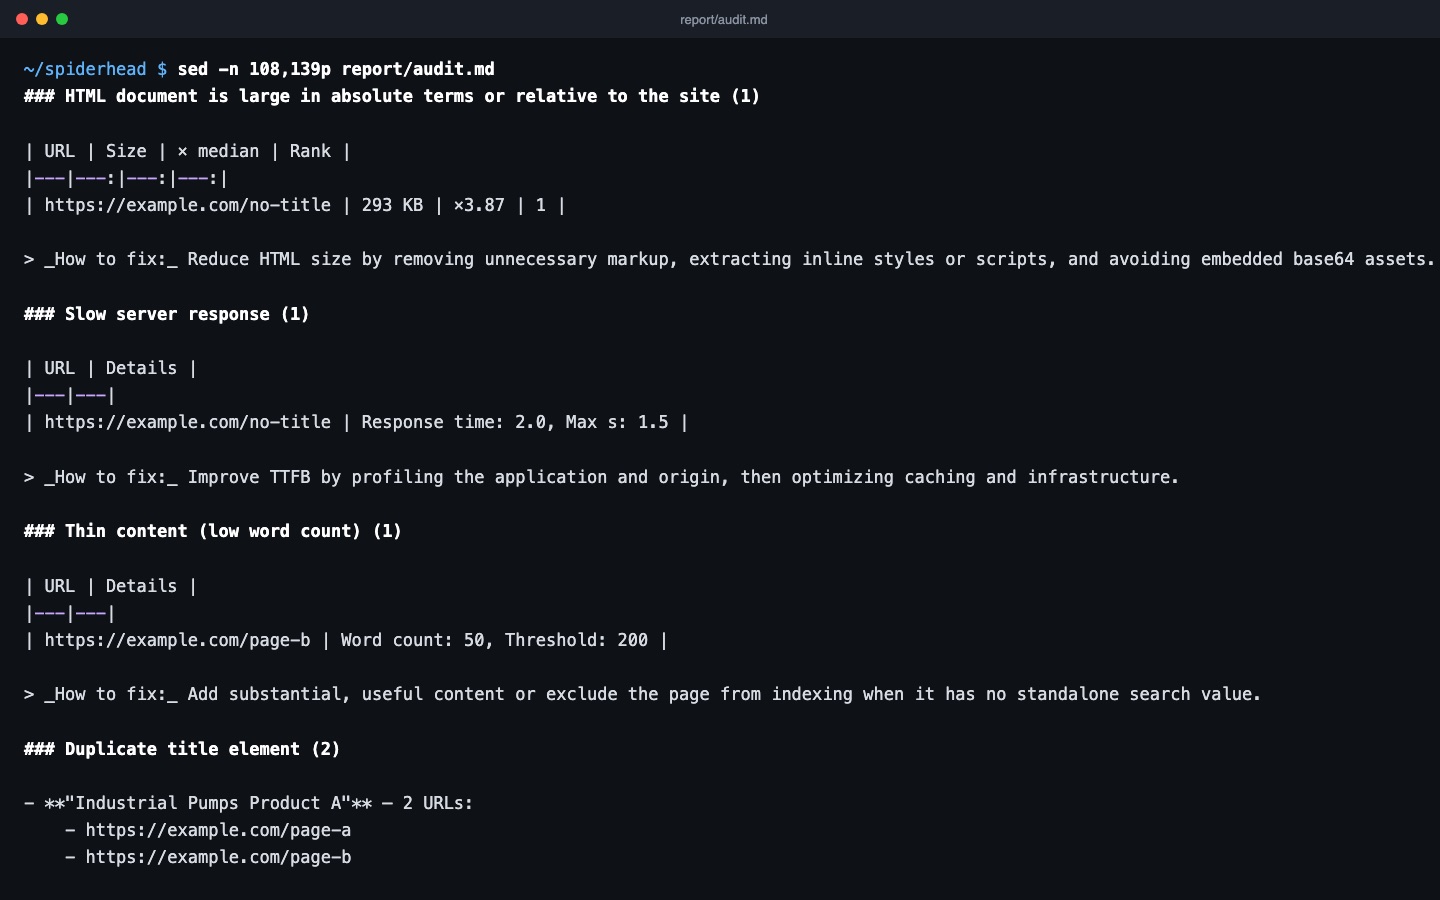
NEAR_DUPLICATEページのテキストが、別のページとほぼ同じで、類似度のしきい値(初期値0.92)を超えていますImportant類似するURLのクラスター
THIN_CONTENT検索で単独で通用するには、ページの語数が少なすぎますImportantページの語数
LOW_TEXT_RATIOHTMLに占める表示テキストの割合が小さく、コンテンツよりマークアップの方が多くなっていますTipページのテキストとHTMLの比率
LOREM_IPSUM_PLACEHOLDERページのメインコンテンツ領域に、Lorem IpsumのダミーテキストがありますImportant一致したダミーテキストの箇所
READABILITY_DIFFICULTテキストのFleschの読みやすさスコアが低い状態です。これは任意のコンテンツチェックですTipページのFleschスコア

コマンド1つで実行

bash
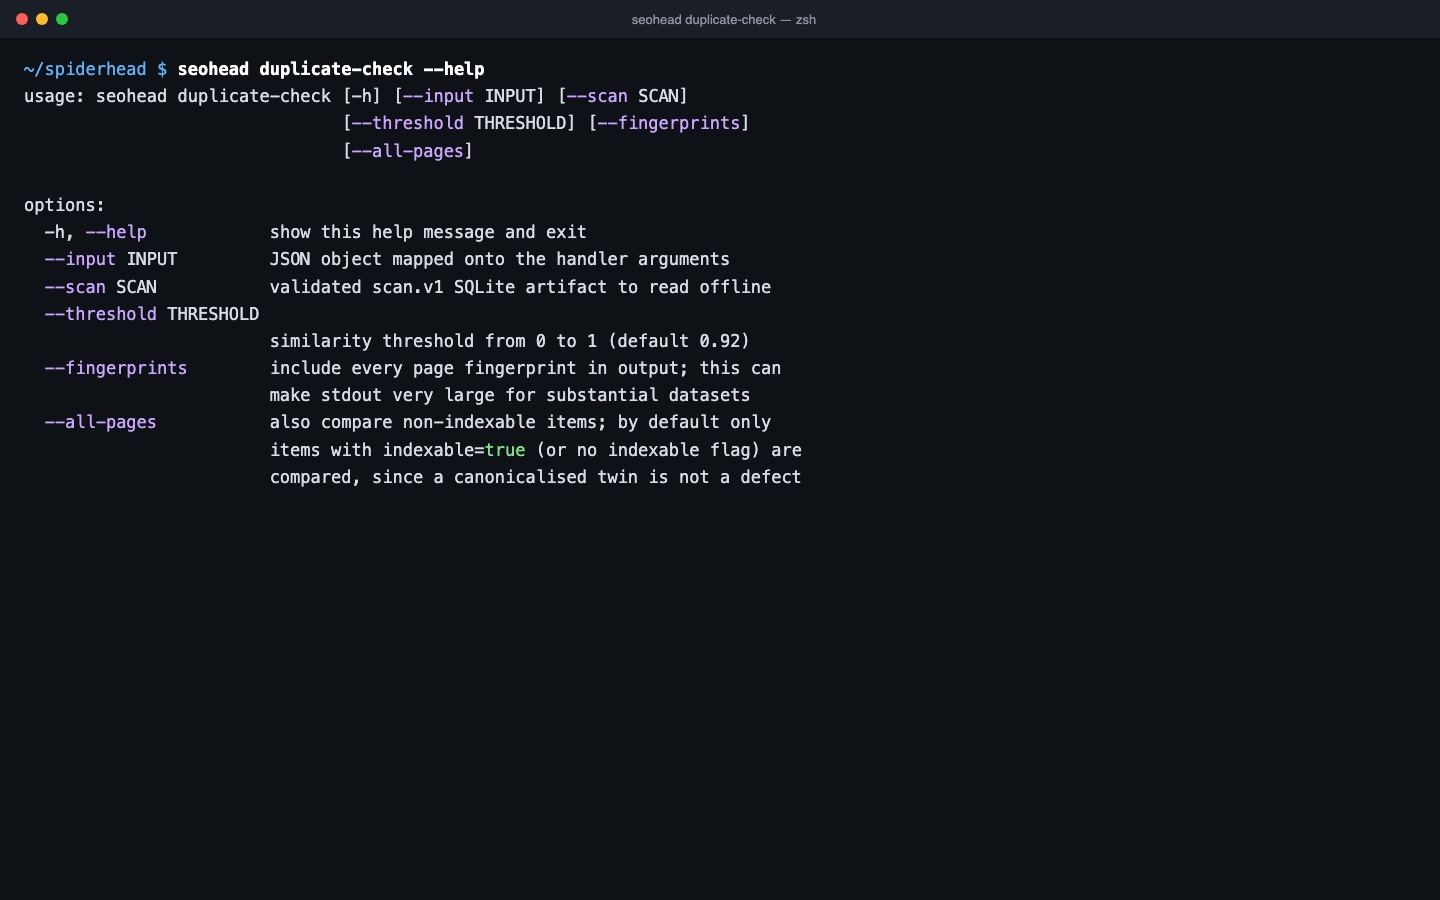
seohead duplicate-check --scan ./scans/audit.sqlite

先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。

必要なもの

  • crawl-siteで作成した、ネイティブの保存済みスキャン(SQLite)。各ページから抽出したテキストを保存しています
  • またはduplicate-check用の、テキストのインラインリスト
  • APIキーは不要

制限事項

  • オフラインのチェックで分析できるのは、最大10,000ドキュメントと16 MiBの保存済みテキストです。一部しか対象にできなかった場合は、その旨が報告されます
  • インデックス不可のページは、初期設定ではスキップされます
  • 比較できるのは、SpiderHeadが保存したテキストだけです。本文を保存したクロールが必要です
  • 似ているからといって、重複とは限りません。しきい値の設定は判断が必要です

よくある質問

サイトに変更を加えますか?
加えません。クロールと重複チェックは、ページを読み取るだけです。チェックは、保存済みのスキャンファイルに対してオフラインで実行します。
完全一致の重複と類似コンテンツの違いは何ですか?
完全一致の重複は、コンテンツハッシュが同じものです。類似コンテンツは、バイト列は異なっても、しきい値を超えるほどテキストが似ているものです。しきい値は--thresholdで、0から1の間で変更できます。初期値は0.92です。
インデックス不可のページも比較しますか?
初期設定では比較しません。別のURLに正規化されているページは欠陥ではないため、比較するのはインデックス可能なページだけです。インデックス不可のページも含めるには、--all-pagesを付けます。
比較できるページ数に上限はありますか?
あります。オフラインのチェックで分析できるのは、最大10,000ドキュメントと、16 MiBの保存済み抽出テキストです。上限に達した場合、レポートに対象範囲が部分的であることが正確に記載されます。分析していないページについて、問題なしと報告することはありません。
共通部分のチェックはどこにありますか?
ヘッダー、ナビゲーション、フッターのマークアップは、別コマンドのboilerplate-reportでグループ化します。duplicate-checkには含まれません。
Screaming Frogは必要ですか?
不要です。duplicate-checkが読むのは、SpiderHead独自のcrawl-siteで作成したスキャンです。Screaming Frogのエクスポートは、sf runの監査で、完全一致の重複と内容の薄いコンテンツのチェックに使います。