
Audit der internen Verlinkung und Crawl-Tiefe

Erstellen Sie aus einem Crawl den Link-Graphen Ihrer Website: verwaiste Seiten, große Klicktiefe, Sackgassen, Seiten, die nur aus der Navigation verlinkt sind, Inlinks, die nur nofollow sind, und einen Link-Score im Vergleich zum Median der Website.

Was es leistet

Struktur

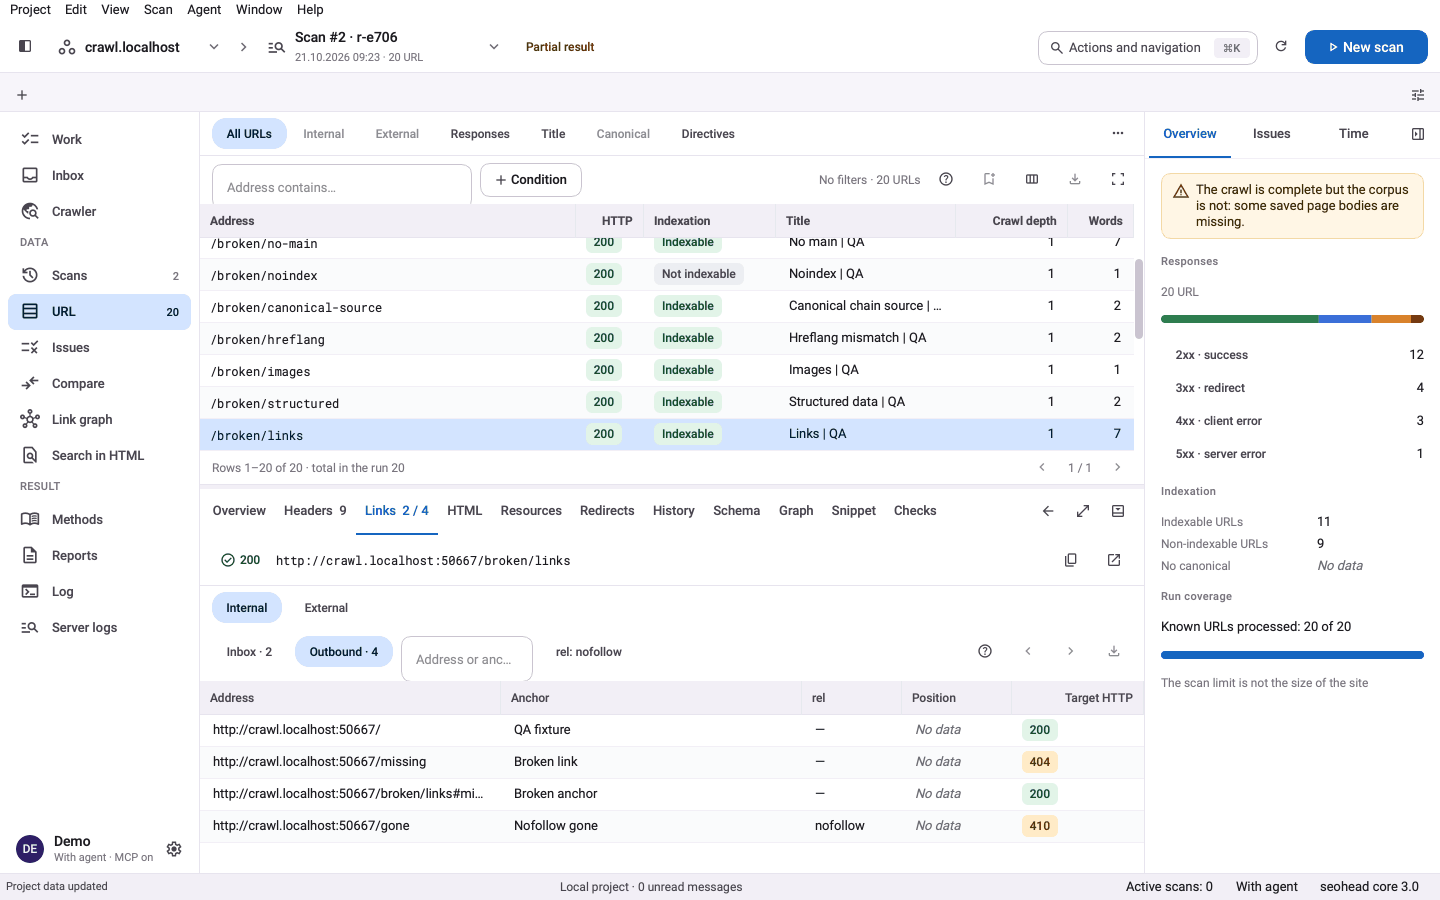
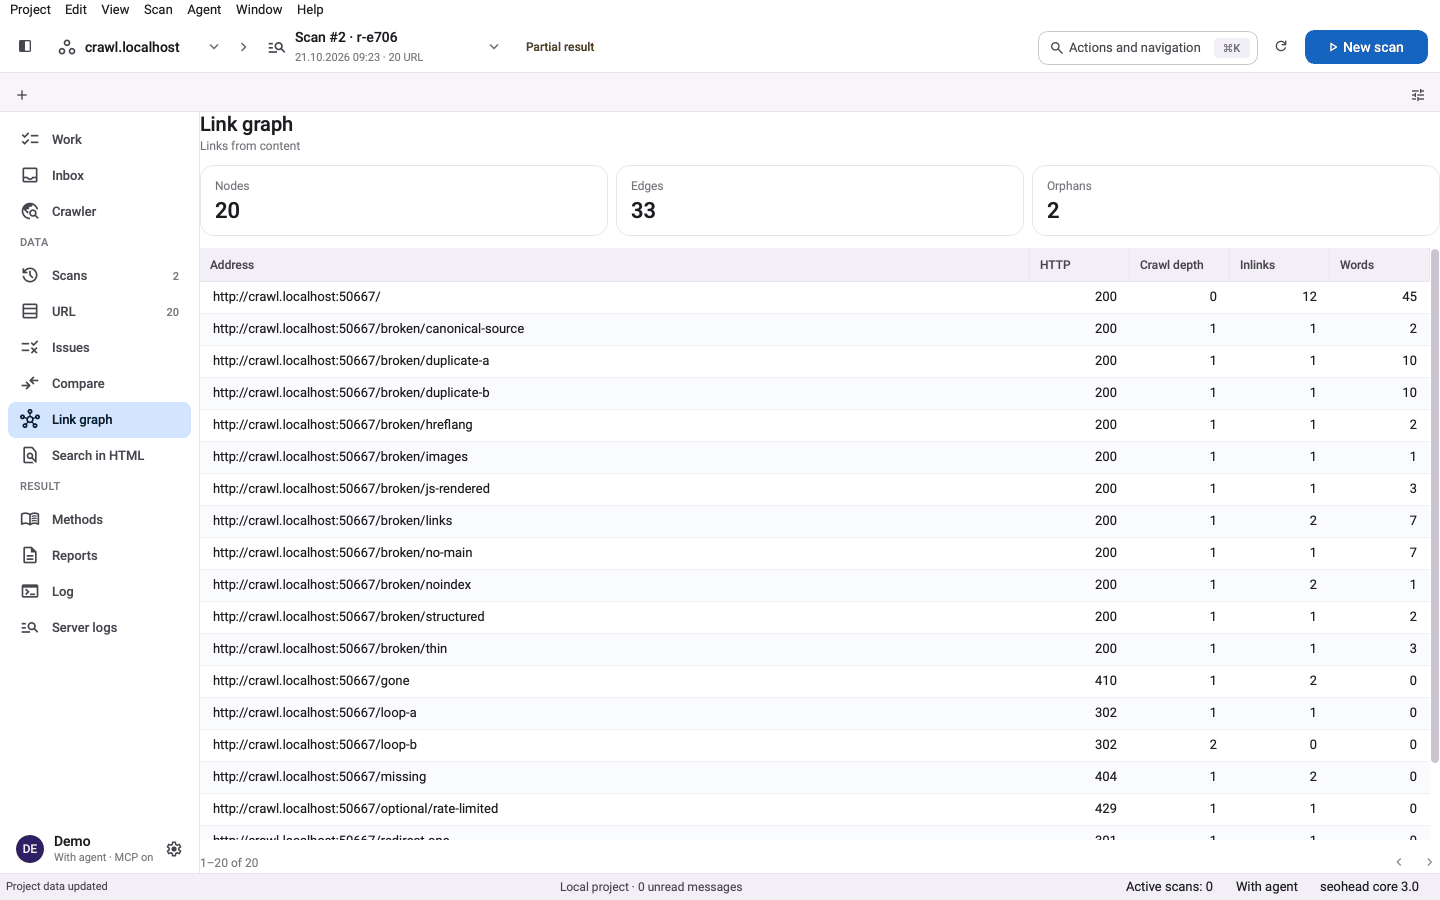
crawl-site folgt von einer Start-URL aus Links innerhalb derselben Domain und speichert jeden Link in einer einzigen SQLite-Datei. Jede Seite erhält ihre Inlinks, Outlinks, die Klicktiefe ab der Start-URL und die Position jedes Links: Navigation, Fußzeile oder Fließtext. So lässt sich unterscheiden, ob eine Seite aus dem Inhalt verlinkt ist oder nur in einem Menü auftaucht.

  • Inlinks und Outlinks pro Seite
  • Klicktiefe ab der Start-URL
  • Linkposition: Navigation, Kopfbereich, Seitenleiste, Fußzeile, Inhalt
  • Entdeckungspfad jeder Seite

Schwachstellen

Die Prüfungen melden Seiten, die kein interner Link erreicht, Sackgassen ohne ausgehende Links, Seiten, die nur aus Boilerplate-Bereichen verlinkt sind, und Seiten, bei denen jeder Inlink nofollow ist. Ein Link-Score zeigt Seiten, die weit unter dem Median der Website liegen. Zu jedem Befund nennt die Prüfliste eine Korrektur, etwa einen kontextuellen Link von einer verwandten Seite.

  • Waisenseiten und Sackgassen
  • Seiten, die nur aus Navigation, Kopfbereich, Seitenleiste oder Fußzeile verlinkt sind
  • Inlinks nur mit nofollow
  • Seiten mit zu vielen Klicks bis zur Start-URL

Ankertexte

Generische Ankertexte wie „hier“, „Weiterlesen“ oder „hier klicken“ sagen Lesern und Suchmaschinen nicht, worum es beim Ziel geht. Interne Links mit leerem Ankertext werden ebenfalls gemeldet, sofern kein barrierefreies Label vorhanden ist.

  • Generische Ankertexte
  • Interne Links mit leerem Ankertext
  • Ankertext zusammen mit der Quellseite angezeigt

Drei Schritte, ein gespeicherter Scan

  1. Website ab einer Start-URL crawlen

    crawl-site folgt von der Start-URL aus Links innerhalb derselben Domain, beachtet standardmäßig die robots.txt und speichert jeden Link in einer einzigen SQLite-Datei.

  2. Link-Graph erstellen

    Jede Seite erhält ihre Inlinks, Outlinks, die Klicktiefe ab der Start-URL und die Position jedes Links: Navigation, Fußzeile oder Fließtext.

  3. Waisenseiten, Sackgassen und schwache Links markieren

    Die Prüfungen melden Seiten ohne eingehende Links, Sackgassen, Seiten, die nur aus Boilerplate oder mit nofollow verlinkt sind, sowie Ankertexte wie „hier“.

Prüfungen in dieser Funktion

PrüfungBedeutungSchweregradBeleg
ORPHAN_PAGEDie Seite hat im Crawl keine internen InlinksImportantAnzahl der Inlinks für die URL
DEEP_CLICK_DEPTHDie Seite liegt mehr Klicks von der Start-URL entfernt, als der konfigurierte Grenzwert vorsiehtImportantKlicktiefe und kürzester Pfad von der Start-URL
NO_INTERNAL_OUTLINKSSackgassenseite ohne ausgehende interne LinksImportantSeiten-URL und Anzahl der Outlinks
INLINK_BOILERPLATE_ONLYDie Seite wird nur aus Navigation, Kopfbereich, Seitenleiste oder Fußzeile verlinkt, nie aus dem InhaltImportantLinkpositionen nach Template-Bereich
ONLY_NOFOLLOW_INLINKSJeder interne Link auf die Seite ist nofollowImportantListe der Inlinks mit rel-Attributen
LOW_LINK_SCOREDer interne Link-Score liegt weit unter dem Median der WebsiteTipScore der Seite im Vergleich zum Median der Website
GENERIC_ANCHOR_TEXTAnkertexte wie „hier“, „Weiterlesen“ oder „hier klicken“ beschreiben das Ziel nichtTipQuellseite und Ankertext
Außerdem im Prüfungsregister
INTERNAL_LINK_NO_ANCHORSITEMAP_ORPHAN

Ein Befehl

bash
seohead crawl-site --url https://example.com --max-urls 1000 --scan-out ./scans/links.sqlite

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Eine Start-URL für crawl-site
  • Oder Inlinks-Exporte von Screaming Frog für den Audit-Pfad
  • Ein vollständiger Crawl für Aussagen über die gesamte Website

Grenzen

  • Ein Teil-Crawl kann eine Waisenseite nicht belegen: Die fehlenden Seiten könnten den einzigen Link enthalten
  • Bei einem Teil-Crawl wird INLINK_BOILERPLATE_ONLY übersprungen und LOW_LINK_SCORE wird nicht ausgegeben
  • Durch JavaScript ergänzte Links sieht der Crawl nur, wenn er die Seiten rendert
  • Über den Fix-Text hinaus gibt es keine Vorschläge, welche Seite auf welche andere verlinken sollte

Fragen

Ändert das etwas auf meiner Website?
Nein. Der Crawl liest nur Seiten. Standardmäßig folgt er der robots.txt; mit --robots können Sie auf report-only oder ignore umstellen. Das Ergebnis ist eine SQLite-Datei, die Sie selbst prüfen.
Wie viele Seiten crawlt das Tool?
Das Standardlimit liegt bei 200 URLs. Erhöhen Sie es mit --max-urls auf bis zu 1.000.000. Mit --max-urls 0 crawlen Sie die gesamte Website. Ein abgebrochener Crawl lässt sich mit --resume fortsetzen.
Ist das Ergebnis vollständig, wenn der Crawl früh endet?
Nicht für Aussagen über den gesamten Link-Graphen. Bei einem Teil-Crawl könnten die fehlenden Seiten den einzigen Link zu einer Seite enthalten. Deshalb werden Prüfungen wie INLINK_BOILERPLATE_ONLY übersprungen, und LOW_LINK_SCORE wird nicht ausgegeben. Führen Sie einen vollständigen Crawl aus, bevor Sie dem Score vertrauen.
Wie schnell crawlt das Tool?
Die Rate legen Sie mit --max-urls-per-second oder --min-delay fest. Für eine Live-Website ist 1 bis 2 Anfragen pro Sekunde ein rücksichtsvoller Ausgangswert.
Nutzt es Sitemaps?
Ja, als zusätzliche Quelle für URLs: Mit --sitemap werden XML-URLs ergänzt oder abgeglichen. Eine Sitemap-URL ohne internen Inlink wird als Sitemap-Waise gemeldet.

Testen Sie es auf Ihrer eigenen Website