
Riprendere una scansione interrotta

Le scansioni sono riprendibili. Una scansione è un artefatto SQLite conservato con la sua provenienza, quindi una scansione interrotta continua da dove si era fermata invece di ripartire da zero.

Cosa fa

Scansioni conservate

Una scansione nativa è un unico file SQLite che tiene insieme evidenze, coda e impostazioni complete. Puoi ispezionarla, esportarla, crearne snapshot, fissarla in pin, potarla, rimettere in coda, fare il diff dei corpi e rianalizzarla offline senza ricontattare il sito. Una scansione finita è immutabile.

  • scan-reanalyze rianalizza l'HTML conservato
  • Snapshot e pin per le baseline

Ripristino

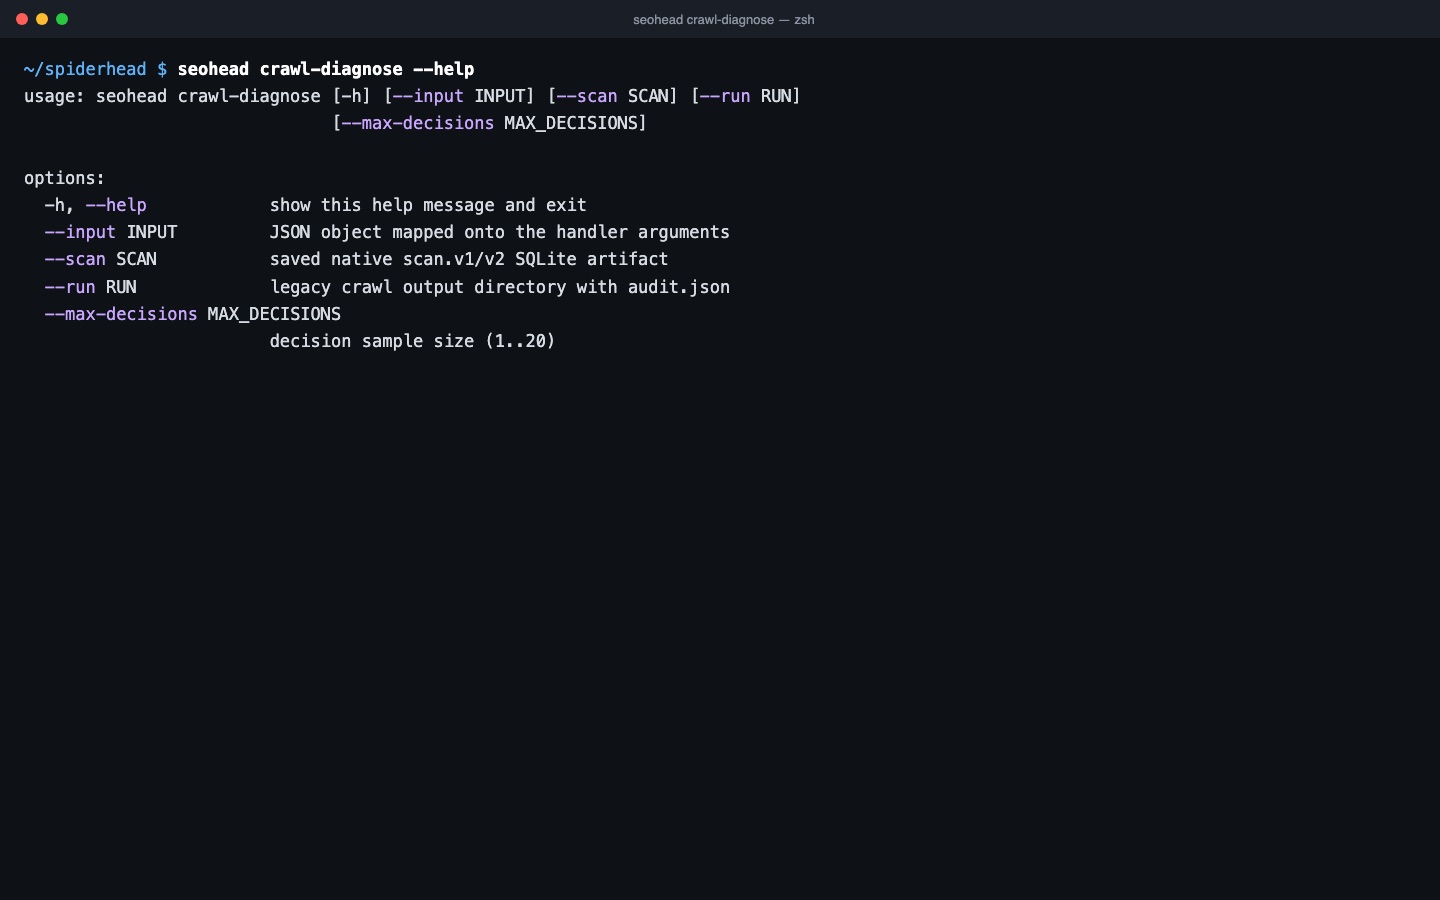
Esegui crawl-site --resume con il percorso della scansione e la scansione continua dalla coda salvata sotto le regole salvate. All'uscita, crawl-site ti dice se il run è finito, fermato in anticipo o ha proseguito uno precedente. crawl-diagnose legge la scansione offline e spiega cosa l'ha fermata, senza alcuna richiesta di rete.

Tre passaggi, una scansione salvata

  1. Il file di scansione è il checkpoint

    Una scansione SQLite tiene coda, evidenze e impostazioni complete in un solo file. Sono scritti nella stessa transazione, quindi un arresto non li separa.

  2. Riprendi dal solo file

    Esegui seohead crawl-site --resume con il percorso della scansione. La URL di partenza e le impostazioni si leggono dal file, quindi la scansione continua sotto le stesse regole.

  3. Diagnostica cosa l'ha fermata

    crawl-diagnose legge la scansione offline. Mostra coda, robots, ambito e stato dei budget, i tipi di contenuto e i fallimenti registrati, senza richieste di rete.

Controlli di questa funzionalità

ControlloCosa significaGravitàEvidenza
NO_RESPONSELa URL è andata in timeout, ha fallito il DNS o ha rifiutato la connessione. Un'origine ferma si vede spesso qui.CriticalURL e tipo di fallimento nella scansione
SERVER_ERROR_5XXLa pagina restituisce uno stato 5xx, per esempio quando l'origine smette di rispondere sotto carico.CriticalURL e codice di stato
BROKEN_PAGE_4XXLa pagina restituisce uno stato 4xx, quindi è rotta per utenti e crawler.CriticalURL e codice di stato
BLOCKED_BY_ROBOTSrobots.txt blocca la URL. Conferma che il blocco sia voluto prima di riprendere.ImportantURL e regola di robots.txt

Un solo comando

bash
seohead crawl-diagnose --scan ./scans/audit.sqlite

Prima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.

Cosa ti serve

  • Il file di scansione scritto da crawl-site --scan-out
  • La stessa build di SpiderHead che l'ha scritto (oppure --producer-build SHA)
  • Per un run legacy su cartella: il comando identico e lo stesso --out-dir

Limiti

  • Una scansione finita o fallita non si può riprendere
  • Una scansione fermata dal proprio budget di URL o di tempo si riprende sotto quello stesso budget; alzalo e scansiona verso un nuovo file
  • Le scansioni che hanno usato header di credenziali non si possono riprendere
  • Alla ripresa si possono cambiare solo le impostazioni di frequenza

Domande

Posso cambiare URL o impostazioni quando riprendo?
No. Con --resume sono accettate solo le opzioni di frequenza (--max-urls-per-second, --min-delay). La URL di partenza e ogni altra impostazione si leggono dal file, quindi una scansione non continua mai sotto le regole di un'altra.
La ripresa richiede la stessa build di SpiderHead?
Sì. Una ripresa da una revisione sorgente diversa è rifiutata, e il messaggio nomina entrambe le revisioni. se questo checkout non può essere verificato come la build che ha scritto il file, passa --producer-build con il suo SHA.
Una scansione ripresa riscarica le pagine?
No. Una pagina già scritta nella scansione non viene scaricata due volte. Il run ripreso continua dalla coda salvata.
Una scansione fermata sembrerà completa?
No. L'output JSON e l'audit salvato registrano partial, finish_reason e resumed, quindi una scansione parziale non risulta mai un sito intero.
Come riprendo una scansione che usava --out-dir?
Esegui di nuovo il comando identico con lo stesso --out-dir. Decide la ripresa il checkpoint crawl_state.json in quella cartella. Se ambito o limiti sono cambiati, la scansione ricomincia da zero di proposito.