
Retomar um rastreamento interrompido

Os rastreamentos podem ser retomados. Um scan é um arquivo SQLite salvo com a origem registrada, então um rastreamento parado continua de onde parou, sem começar de novo.

O que faz

Scans salvos

Um scan nativo é um único arquivo SQLite que guarda as evidências, a fila e todas as configurações juntas. Você pode inspecionar, exportar, criar snapshots, fixar, podar, colocar de novo na fila, comparar corpos e reanalisar offline, sem consultar o site outra vez. Um scan concluído é imutável.

  • scan-reanalyze reprocessa o HTML salvo
  • Snapshots e fixações para linhas de base

Recuperação

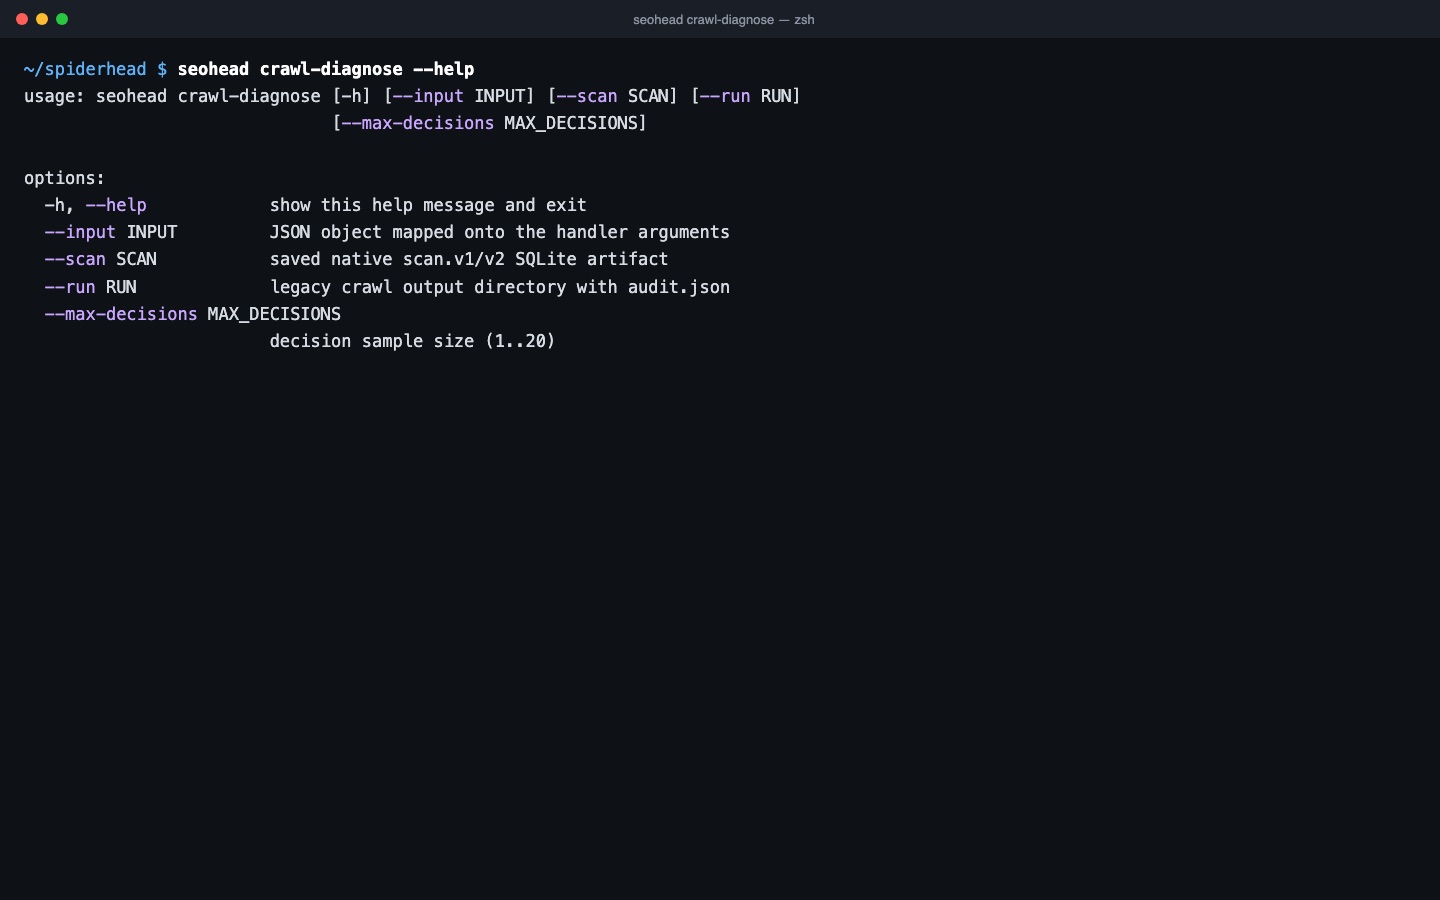
Execute crawl-site --resume com o caminho do scan, e o rastreamento continua a partir da fila salva, com as regras salvas. Ao encerrar, o crawl-site informa se a execução foi concluída, parou antes do fim ou continuou uma execução anterior. O crawl-diagnose lê o scan offline e explica o que o interrompeu, sem nenhuma requisição de rede.

Três passos, um rastreamento salvo

  1. O arquivo de scan é o checkpoint

    Um scan SQLite guarda a fila, as evidências e todas as configurações em um único arquivo. Elas são gravadas na mesma transação, então uma parada não separa uma coisa da outra.

  2. Retome só com o arquivo

    Execute seohead crawl-site --resume com o caminho do scan. A URL inicial e as configurações são lidas do arquivo, então o rastreamento segue as mesmas regras.

  3. Diagnostique o que parou

    O crawl-diagnose lê o scan offline. Ele mostra o estado da fila, do robots, do escopo e do orçamento, os tipos de conteúdo e as falhas registradas, sem nenhuma requisição de rede.

Verificações deste recurso

VerificaçãoO que significaGravidadeEvidência
NO_RESPONSEA URL deu timeout, falhou no DNS ou recusou a conexão. Um servidor de origem que parou costuma aparecer aqui.CriticalURL e tipo de falha no scan
SERVER_ERROR_5XXA página responde com status 5xx, por exemplo quando o servidor de origem para de responder sob carga.CriticalURL e código de status
BROKEN_PAGE_4XXA página responde com status 4xx, então está quebrada para usuários e rastreadores.CriticalURL e código de status
BLOCKED_BY_ROBOTSO robots.txt bloqueia a URL. Confirme se o bloqueio é intencional antes de retomar.ImportantURL e a regra do robots.txt

Um comando

bash
seohead crawl-diagnose --scan ./scans/audit.sqlite

Instale primeiro: guia de instalação. Todo comando também funciona como ferramenta MCP para agentes de IA.

O que você precisa

  • O arquivo de scan gravado por crawl-site --scan-out
  • A mesma build do SpiderHead que o gravou (ou --producer-build SHA)
  • Para uma execução em pasta antiga: o mesmo comando e o mesmo --out-dir

Limites

  • Um scan concluído ou com falha não pode ser retomado
  • Um rastreamento que parou no limite próprio de URLs ou de tempo continua com esse mesmo limite; para aumentá-lo, rastreie em um novo scan
  • Rastreamentos que usaram cabeçalhos de credenciais não podem ser retomados
  • Ao retomar, só as configurações de taxa podem ser alteradas

Perguntas

Posso mudar a URL ou as configurações ao retomar?
Não. Só as opções de taxa (--max-urls-per-second, --min-delay) são aceitas com --resume. A URL inicial e todas as outras configurações são lidas do arquivo, então um rastreamento nunca continua com as regras de outro.
A retomada exige a mesma build do SpiderHead?
Sim. Uma retomada a partir de outra revisão do código-fonte é recusada, e a mensagem indica as duas revisões. Se não for possível verificar que esta cópia é a build que gravou o arquivo, passe --producer-build com o SHA dela.
Uma retomada vai buscar as páginas de novo?
Não. Uma página que já foi gravada no scan não é buscada duas vezes. A execução retomada continua a partir da fila salva.
Um rastreamento interrompido pode parecer concluído?
Não. A saída JSON e o registro de auditoria salvo indicam partial, finish_reason e resumed, então um scan parcial nunca é lido como o site inteiro.
Como retomar um rastreamento que usou --out-dir?
Execute de novo o mesmo comando com o mesmo --out-dir. O checkpoint crawl_state.json dessa pasta decide a retomada. Se o escopo ou os limites mudaram, o rastreamento começa do zero, de propósito.

Teste no seu próprio site