Продолжение прерванного обхода
Обходы продолжаемы. Скан — сохранённый SQLite-артефакт с происхождением, поэтому остановленный обход продолжается с места остановки, а не начинается заново.
Продолжение прерванного обхода
Сканы сохраняются
Каждый скан хранится: смотрите, выгружайте, снимайте снапшоты, закрепляйте, чистите, ставьте в очередь заново, сравнивайте тела и пересчитывайте офлайн — без обращения к сайту.
- scan-reanalyze пересобирает сохранённый HTML
- Снапшоты и закрепления для базовых линий
Восстановление
Прерванные прогоны записаны и продолжаемы; crawl-diagnose объясняет, что остановило обход.
Три шага — один сохранённый скан
Файл скана — контрольная точка
SQLite-скан держит очередь, доказательства и все настройки в одном файле. Они пишутся одной транзакцией, поэтому остановка их не разъединяет.
Продолжение из одного файла
Запустите seohead crawl-site --resume с путём к скану. Стартовый URL и настройки читаются из файла — обход продолжается по тем же правилам.
Диагностика остановки
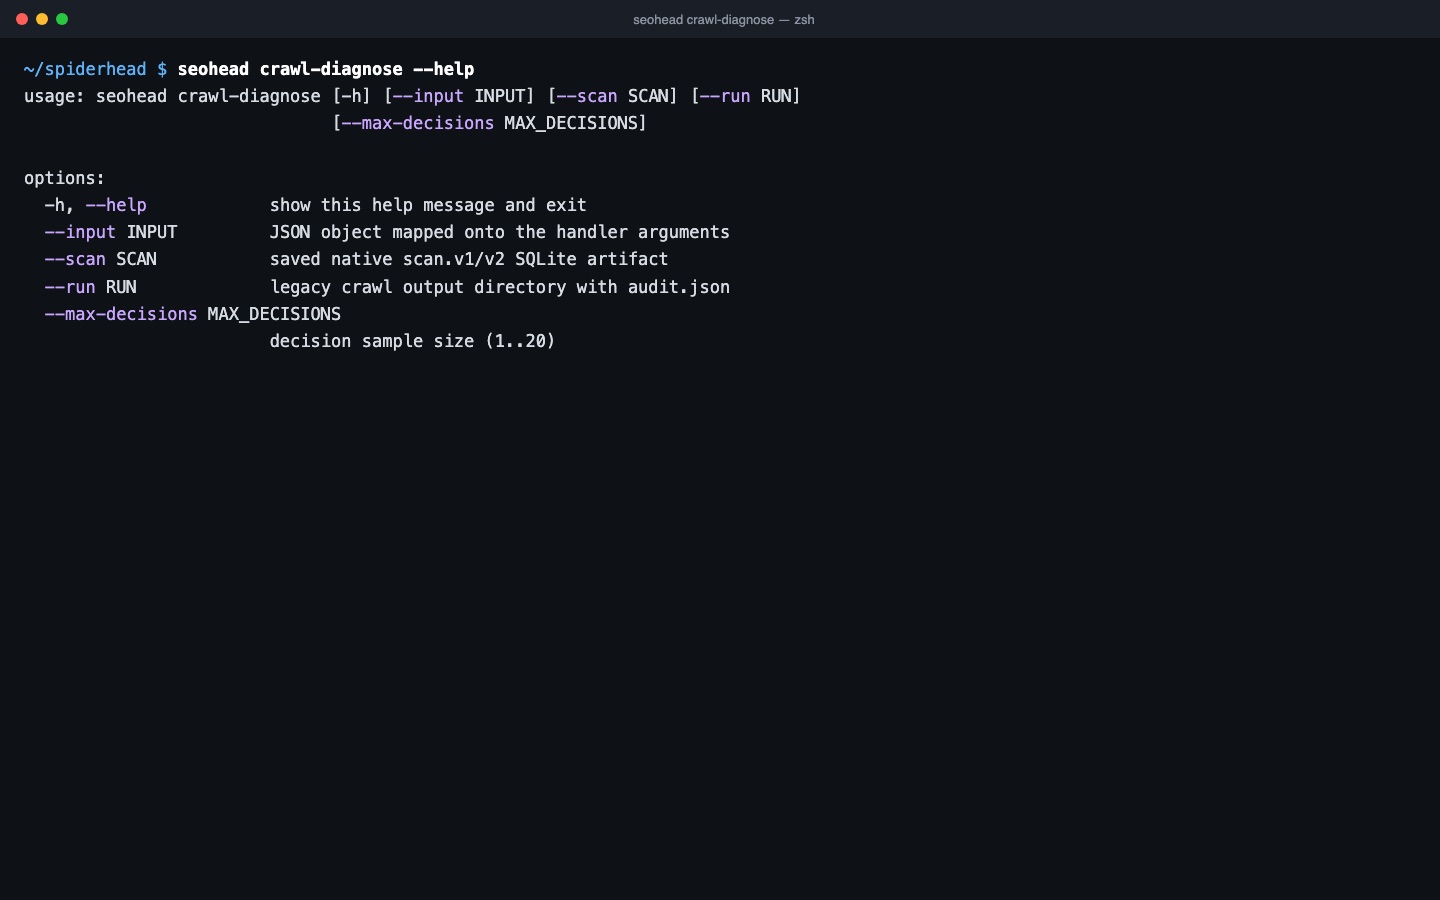
crawl-diagnose читает скан офлайн: очередь, robots, область, состояние бюджета, типы контента и записанные сбои — без единого сетевого запроса.
Проверки в этой возможности
| Проверка | Что значит | Критичность | Доказательство |
|---|---|---|---|
NO_RESPONSE | Таймаут, ошибка DNS или отказ соединения. Остановившийся сервер часто проявляется именно здесь. | Critical | URL и тип сбоя в скане |
SERVER_ERROR_5XX | Страница отвечает 5xx — например, когда сервер перестаёт отвечать под нагрузкой. | Critical | URL и код ответа |
BROKEN_PAGE_4XX | Страница отвечает 4xx — она битая и для людей, и для краулеров. | Critical | URL и код ответа |
BLOCKED_BY_ROBOTS | URL заблокирован robots.txt. Перед продолжением убедитесь, что блокировка намеренна. | Important | URL и правило robots.txt |
Одна команда
seohead crawl-diagnose --scan ./scans/audit.sqliteСначала установите: руководство по установке. Каждая команда работает и как MCP-инструмент для ИИ-агентов.