
Reanudar un rastreo interrumpido

Los rastreos se pueden reanudar. Un escaneo es un archivo SQLite conservado con su procedencia, así que un rastreo detenido continúa desde donde se quedó en lugar de empezar de nuevo.

Qué hace

Escaneos conservados

Un escaneo nativo es un único archivo SQLite que guarda juntos las pruebas, la cola y todos los ajustes. Puedes inspeccionarlo, exportarlo, crear instantáneas, fijarlo, depurarlo, volver a poner en cola, comparar cuerpos y volver a analizarlo sin conexión, sin volver a contactar con el sitio. Un escaneo terminado es inmutable.

  • scan-reanalyze vuelve a analizar el HTML conservado
  • Instantáneas y fijaciones para usar como líneas base

Recuperación

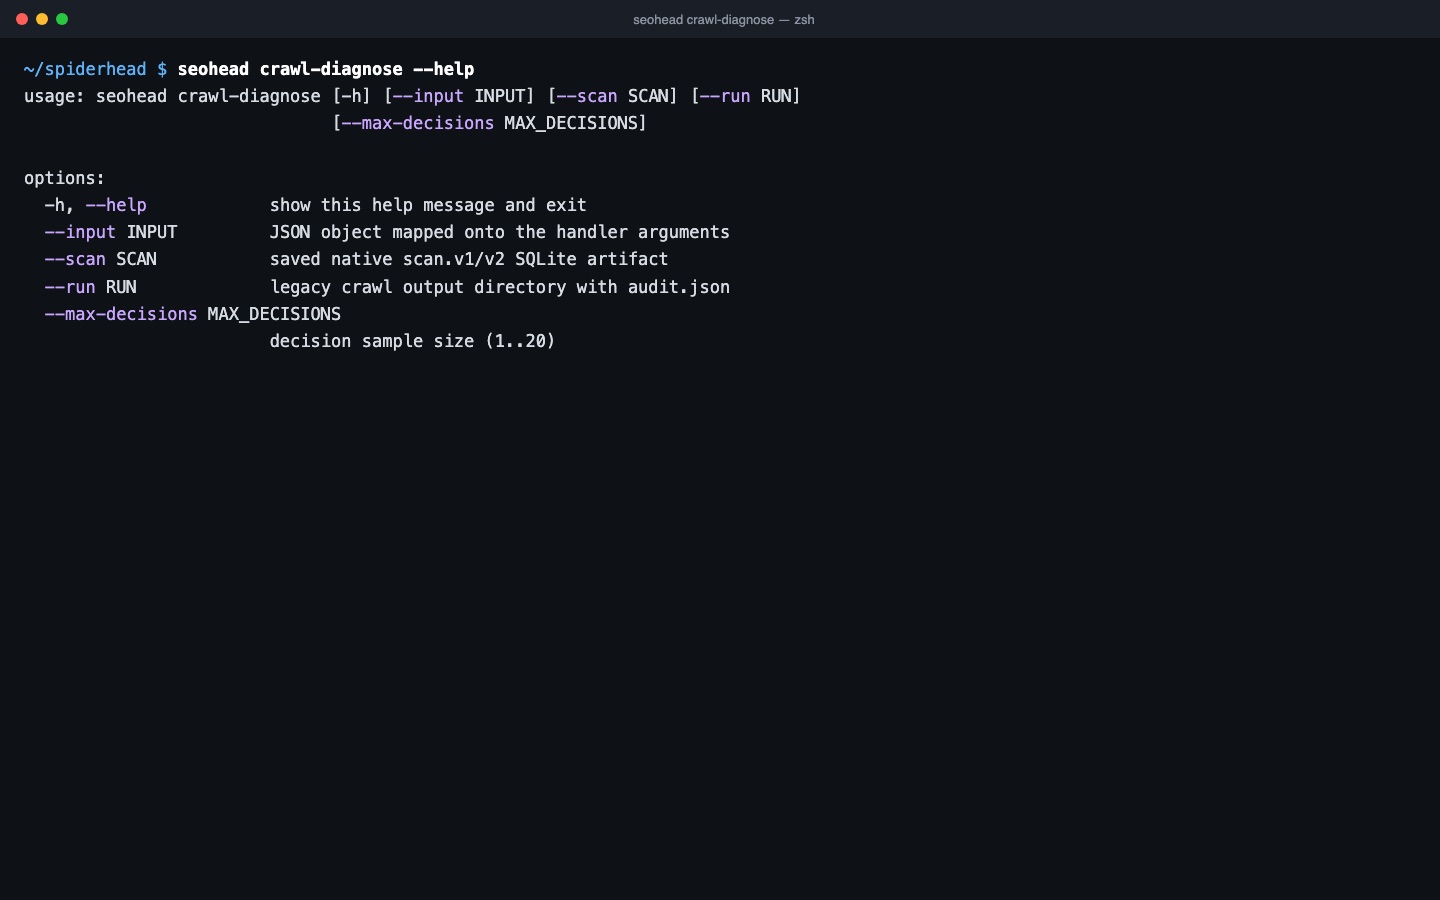
Ejecuta crawl-site --resume con la ruta del escaneo y el rastreo continúa desde la cola guardada, con las reglas almacenadas. Al terminar, crawl-site indica si la ejecución acabó, se detuvo antes o continuó una anterior. crawl-diagnose lee el escaneo sin conexión y explica qué lo detuvo, sin ninguna petición de red.

Tres pasos, un análisis guardado

  1. El archivo de escaneo es el punto de control

    Un escaneo SQLite guarda la cola, las pruebas y todos los ajustes en un único archivo. Se escriben en la misma transacción, así que una parada no los separa.

  2. Reanudar solo con el archivo

    Ejecuta seohead crawl-site --resume con la ruta del escaneo. La URL de inicio y los ajustes se leen del archivo, así que el rastreo continúa con las mismas reglas.

  3. Diagnosticar qué lo detuvo

    crawl-diagnose lee el escaneo sin conexión. Muestra el estado de la cola, robots, el alcance y el presupuesto, los tipos de contenido y los fallos registrados, sin ninguna petición de red.

Comprobaciones de esta función

ComprobaciónQué significaGravedadEvidencia
NO_RESPONSELa URL agotó el tiempo de espera, falló la resolución DNS o rechazó la conexión. Un origen detenido suele aparecer aquí.CriticalURL y tipo de fallo en el escaneo
SERVER_ERROR_5XXLa página devuelve un estado 5xx, por ejemplo cuando el origen deja de responder bajo carga.CriticalURL y código de estado
BROKEN_PAGE_4XXLa página devuelve un estado 4xx, así que está rota para los usuarios y los rastreadores.CriticalURL y código de estado
BLOCKED_BY_ROBOTSrobots.txt bloquea la URL. Confirma que el bloqueo es intencionado antes de reanudar.ImportantURL y la regla de robots.txt

Un solo comando

bash
seohead crawl-diagnose --scan ./scans/audit.sqlite

Primero, instala SpiderHead: guía de instalación. Cada comando también funciona como herramienta MCP para agentes de IA.

Qué necesitas

  • El archivo de escaneo que escribe crawl-site --scan-out
  • La misma compilación de SpiderHead que lo escribió (o --producer-build SHA)
  • Para una ejecución en carpeta antigua: el mismo comando y el mismo --out-dir

Límites

  • Un escaneo terminado o fallido no se puede reanudar
  • Un rastreo que se detuvo por su propio límite de URL o de tiempo se reanuda con ese mismo límite; para subirlo, rastrea en un escaneo nuevo
  • Los rastreos que usaron cabeceras con credenciales no se pueden reanudar
  • Al reanudar solo se pueden cambiar los ajustes de velocidad

Preguntas

¿Puedo cambiar la URL o los ajustes al reanudar?
No. Con --resume solo se aceptan las opciones de velocidad (--max-urls-per-second, --min-delay). La URL de inicio y el resto de ajustes se leen del archivo, así que un rastreo nunca continúa con las reglas de otro.
¿La reanudación necesita la misma compilación de SpiderHead?
Sí. Una reanudación desde otra revisión del código fuente se rechaza y el mensaje indica ambas revisiones. Si no se puede verificar que esta copia es la compilación que escribió el archivo, añade --producer-build con su SHA.
¿Un rastreo reanudado volverá a descargar las páginas?
No. Una página ya registrada en el escaneo no se descarga dos veces. La ejecución reanudada continúa desde la cola guardada.
¿Parecerá completo un rastreo detenido?
No. La salida JSON y la auditoría guardada registran partial, finish_reason y resumed, así que un escaneo parcial nunca se lee como si fuera todo el sitio.
¿Cómo reanudo un rastreo que usó --out-dir?
Vuelve a ejecutar el mismo comando con el mismo --out-dir. El punto de control crawl_state.json de esa carpeta decide la reanudación. Si cambiaron el alcance o los límites, el rastreo empieza de cero a propósito.

Pruébalo en tu propio sitio