
Reprendre un crawl interrompu

Les crawls peuvent être repris. Un scan est un fichier SQLite conservé, qui garde sa provenance : un crawl arrêté reprend donc là où il s’est arrêté, au lieu de repartir de zéro.

Ce qu'elle fait

Scans conservés

Un scan natif est un seul fichier SQLite qui regroupe les preuves, la file d’attente et l’ensemble des réglages. Vous pouvez l’inspecter, l’exporter, en faire un instantané, l’épingler, le purger, le remettre en file d’attente, comparer le contenu des réponses et le réanalyser hors ligne, sans solliciter de nouveau le site. Un scan terminé est immuable.

  • scan-reanalyze réanalyse le HTML conservé
  • Instantanés et épingles pour les points de référence

Reprise

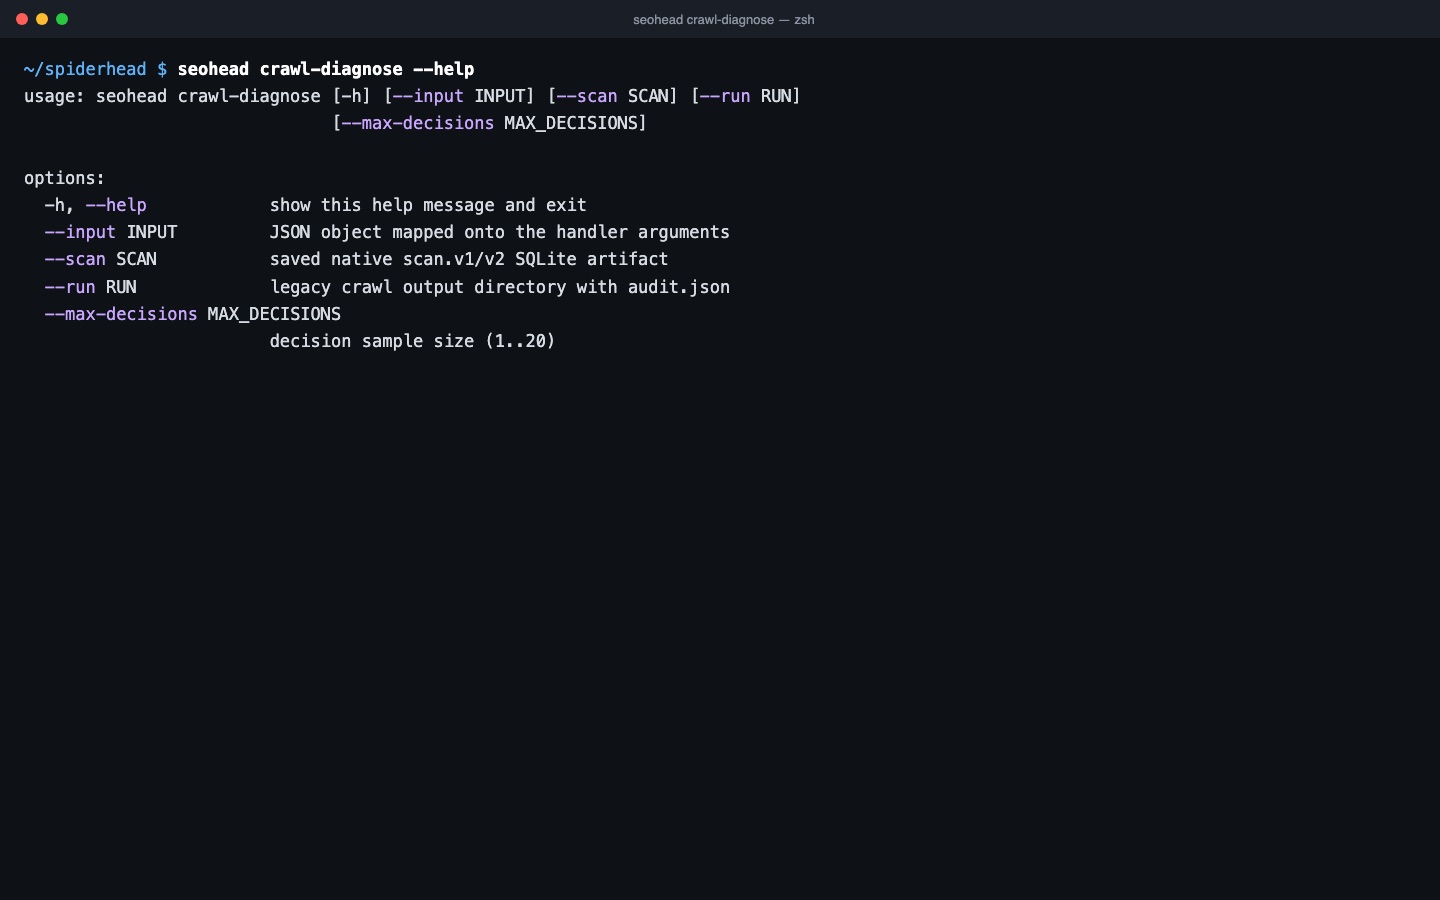
Lancez crawl-site --resume avec le chemin du scan : le crawl reprend depuis la file d’attente enregistrée, selon les règles enregistrées. À la sortie, crawl-site indique si l’exécution s’est terminée, s’est arrêtée prématurément ou a repris une exécution précédente. crawl-diagnose lit le scan hors ligne et explique ce qui a arrêté le crawl, sans aucune requête réseau.

Trois étapes, un seul scan enregistré

  1. Le fichier de scan sert de point de contrôle

    Un scan SQLite conserve dans un seul fichier la file d’attente, les preuves et l’ensemble des réglages. Ils sont écrits dans la même transaction, donc un arrêt ne les dissocie pas.

  2. Reprendre à partir du seul fichier

    Lancez seohead crawl-site --resume avec le chemin du scan. L’URL de départ et les réglages sont lus dans le fichier : le crawl reprend donc selon les mêmes règles.

  3. Diagnostiquer la cause de l’arrêt

    crawl-diagnose lit le scan hors ligne. Il affiche la file d’attente, l’état de robots.txt, du périmètre et du budget, les types de contenu et les échecs enregistrés, sans aucune requête réseau.

Contrôles de cette fonctionnalité

ContrôleSignificationGravitéPreuve
NO_RESPONSEL’URL a dépassé le délai d’attente, la résolution DNS a échoué ou la connexion a été refusée. Un serveur à l’arrêt apparaît souvent ici.CriticalURL et type d’échec dans le scan
SERVER_ERROR_5XXLa page renvoie un code HTTP 5xx, par exemple lorsque le serveur cesse de répondre sous charge.CriticalURL et code HTTP
BROKEN_PAGE_4XXLa page renvoie un code HTTP 4xx : elle est cassée pour les internautes comme pour les crawlers.CriticalURL et code HTTP
BLOCKED_BY_ROBOTSrobots.txt bloque l’URL. Vérifiez que ce blocage est voulu avant de reprendre.ImportantURL et règle robots.txt

Une seule commande

bash
seohead crawl-diagnose --scan ./scans/audit.sqlite

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Le fichier de scan écrit par crawl-site --scan-out
  • Le même build de SpiderHead que celui qui l’a écrit (ou --producer-build SHA)
  • Pour une exécution en mode dossier (ancien format) : la même commande et le même --out-dir

Limites

  • Un scan terminé ou en échec ne peut pas être repris
  • Un crawl arrêté par sa propre limite d’URL ou de temps reprend avec cette même limite ; pour la relever, relancez un nouveau crawl dans un nouveau scan
  • Les crawls qui ont utilisé des en-têtes d’identification ne peuvent pas être repris
  • Seuls les réglages de débit peuvent être modifiés à la reprise

Questions

Puis-je changer l’URL ou les réglages à la reprise ?
Non. Seules les options de débit (--max-urls-per-second, --min-delay) sont acceptées avec --resume. L’URL de départ et tous les autres réglages sont lus dans le fichier : un même crawl ne reprend donc jamais avec les règles d’un autre.
La reprise exige-t-elle la même build de SpiderHead ?
Oui. Une reprise depuis une autre révision des sources est refusée, et le message indique les deux révisions. Si cette copie du code ne peut pas être vérifiée comme le build ayant écrit le fichier, passez --producer-build avec son SHA.
Les pages seront-elles crawlées de nouveau ?
Non. Une page déjà enregistrée dans le scan n’est pas requêtée deux fois. La reprise continue depuis la file d’attente enregistrée.
Un crawl arrêté aura-t-il l’air complet ?
Non. La sortie JSON et l’audit enregistré indiquent partial, finish_reason et resumed : un scan partiel ne se lit jamais comme un site entier.
Comment reprendre un crawl qui utilisait --out-dir ?
Relancez la même commande avec le même --out-dir. C’est le point de contrôle crawl_state.json de ce dossier qui décide de la reprise. Si le périmètre ou les limites ont changé, le crawl repart de zéro, volontairement.