
Auditoria de linkagem interna e profundidade de rastreamento

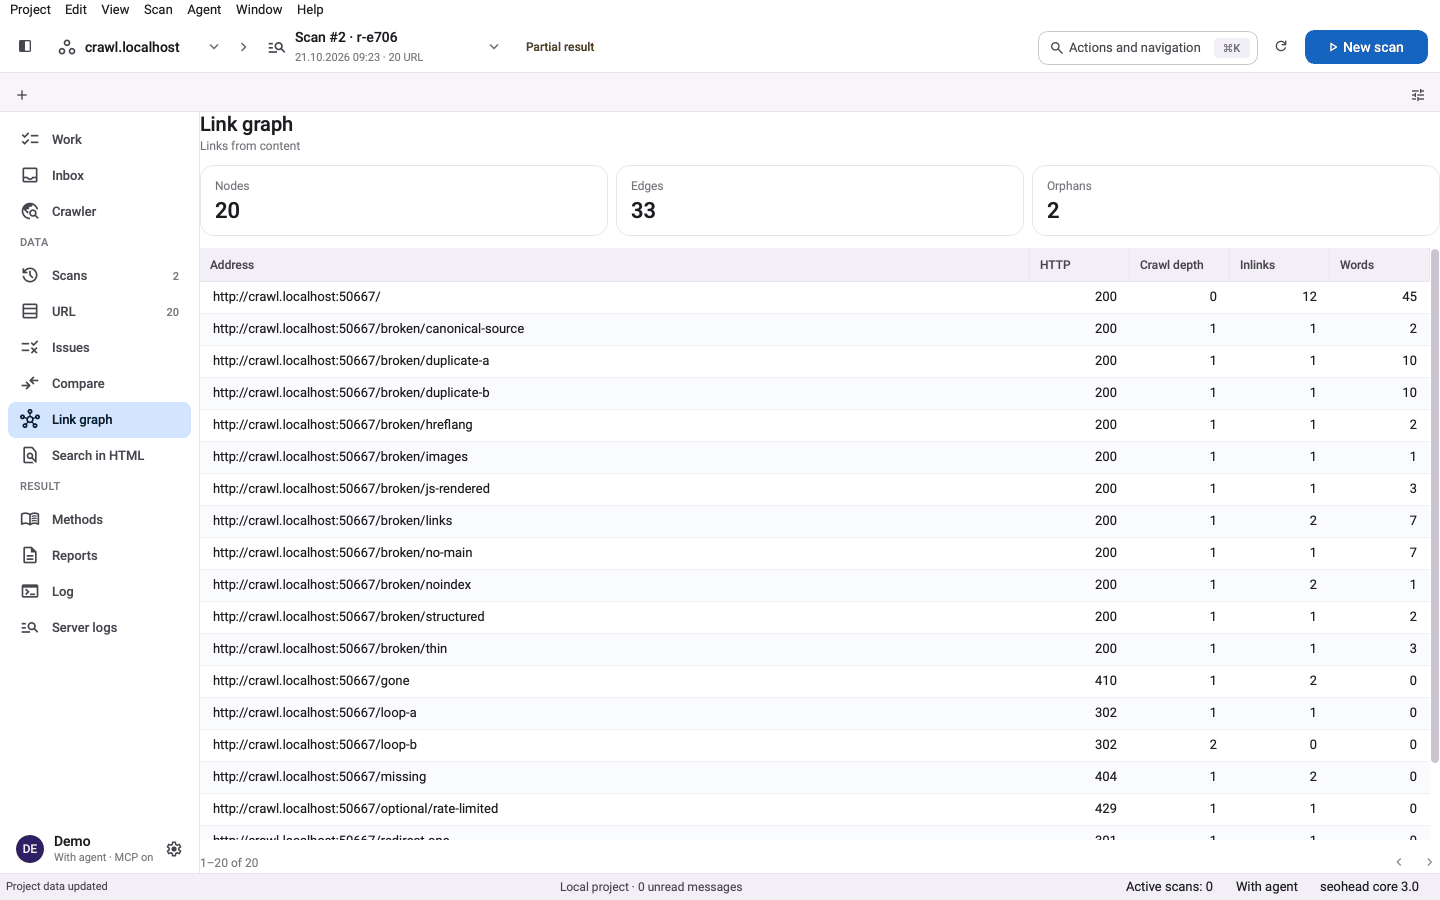
Mapeie o grafo de links internos de um rastreamento: páginas órfãs, cliques demais até chegar à página, becos sem saída, páginas que recebem links só da navegação, links de entrada só com nofollow e um score de links comparado com a mediana do site.

O que faz

Estrutura

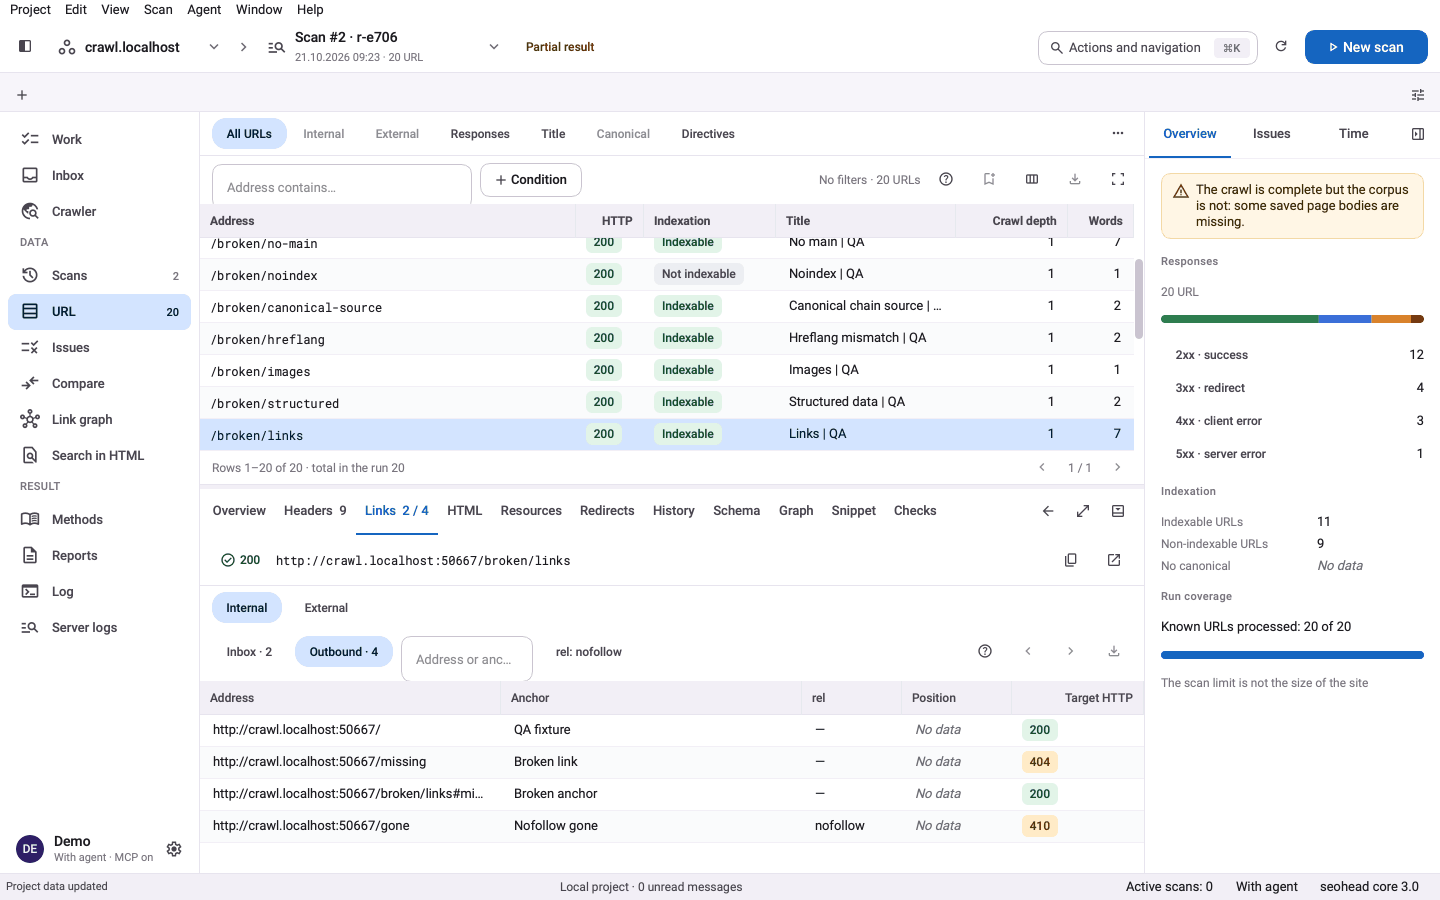
O crawl-site segue links do mesmo host a partir de uma URL inicial e guarda cada link em um único arquivo SQLite. Para cada página, ele registra os links de entrada, os links de saída, a profundidade de cliques a partir da URL inicial e a posição de cada link: navegação, rodapé ou texto do corpo. Assim dá para separar as páginas linkadas a partir do conteúdo das que só aparecem em um menu.

  • Links de entrada e de saída por página
  • Profundidade de cliques a partir da URL inicial
  • Posição do link: navegação, cabeçalho, barra lateral, rodapé, conteúdo
  • Caminho de descoberta de cada página

Pontos fracos

As verificações apontam páginas que nenhum link interno alcança, becos sem saída sem links de saída, páginas linkadas só a partir de trechos repetidos do template e páginas em que todos os links de entrada são nofollow. Um score de links mostra as páginas muito abaixo da mediana do site. O registro dá a cada problema uma correção, como um link contextual vindo de uma página relacionada.

  • Páginas órfãs e becos sem saída
  • Páginas linkadas só pela navegação, cabeçalho, barra lateral ou rodapé
  • Links de entrada apenas nofollow
  • Páginas com cliques demais até a URL inicial

Âncoras

Texto âncora genérico, como “aqui”, “leia mais” ou “clique aqui”, não diz ao leitor nem aos buscadores do que se trata o destino. Links internos com texto âncora vazio também são apontados, a menos que haja um rótulo acessível.

  • Texto âncora genérico
  • Links internos com texto âncora vazio
  • Texto âncora exibido junto com a página de origem

Três passos, um rastreamento salvo

  1. Rastreie o site a partir de uma URL inicial

    O crawl-site segue links do mesmo host a partir da URL inicial, respeita o robots.txt por padrão e guarda cada link em um único arquivo SQLite.

  2. Mapeie o grafo de links

    Cada página recebe seus links de entrada, links de saída, profundidade de cliques a partir da URL inicial e a posição de cada link: navegação, rodapé ou texto do corpo.

  3. Marque órfãs, becos sem saída e links fracos

    As verificações apontam páginas que nenhum link alcança, becos sem saída, páginas linkadas só a partir de trechos repetidos ou com nofollow, e âncoras como “aqui”.

Verificações deste recurso

VerificaçãoO que significaGravidadeEvidência
ORPHAN_PAGEA página não tem links internos de entrada no rastreamentoImportantQuantidade de links de entrada da URL
DEEP_CLICK_DEPTHA página exige mais cliques a partir da URL inicial do que o mínimo configuradoImportantProfundidade de cliques e o caminho mais curto a partir da URL inicial
NO_INTERNAL_OUTLINKSBeco sem saída: a página não tem links internos de saídaImportantURL da página e quantidade de links de saída
INLINK_BOILERPLATE_ONLYA página só recebe links da navegação, do cabeçalho, da barra lateral ou do rodapé, nunca do texto do corpoImportantPosição dos links de entrada por área do template
ONLY_NOFOLLOW_INLINKSTodos os links internos para a página são nofollowImportantLista de links de entrada com os atributos rel
LOW_LINK_SCOREO score de links interno fica muito abaixo da mediana do siteTipScore da página comparado com a mediana do site
GENERIC_ANCHOR_TEXTTextos como “aqui”, “leia mais” ou “clique aqui” não descrevem o destinoTipPágina de origem e texto âncora
Também no registro de verificações
INTERNAL_LINK_NO_ANCHORSITEMAP_ORPHAN

Um comando

bash
seohead crawl-site --url https://example.com --max-urls 1000 --scan-out ./scans/links.sqlite

Instale primeiro: guia de instalação. Todo comando também funciona como ferramenta MCP para agentes de IA.

O que você precisa

  • Uma URL inicial para o crawl-site
  • Ou exportações de Inlinks do Screaming Frog para o caminho de auditoria
  • Um rastreamento completo para conclusões sobre o grafo inteiro

Limites

  • Um rastreamento parcial não comprova que uma página é órfã: as páginas que faltaram podem conter o único link para ela
  • Em rastreamento parcial, o INLINK_BOILERPLATE_ONLY é ignorado e o LOW_LINK_SCORE não é exibido
  • Links adicionados por JavaScript só são vistos se o rastreamento renderizar as páginas
  • Além do texto da correção, ele não sugere quais páginas devem linkar para quais outras

Perguntas

Isso muda alguma coisa no meu site?
Não. O rastreamento só lê páginas. Por padrão, ele segue o robots.txt, e você pode configurar apenas relatório ou ignorar com --robots. Os resultados vão para um arquivo SQLite que você revisa por conta própria.
Quantas páginas ele rastreia?
O limite padrão é de 200 URLs. Aumente com --max-urls, até 1.000.000. Use --max-urls 0 para um rastreamento completo. Um rastreamento interrompido pode ser retomado com --resume.
O resultado fica completo se o rastreamento parar antes do fim?
Não, para conclusões sobre o grafo inteiro. Em um rastreamento parcial, as páginas que faltaram podem ter o único link de uma página, por isso verificações como INLINK_BOILERPLATE_ONLY são ignoradas e o LOW_LINK_SCORE não é exibido. Faça um rastreamento completo antes de confiar no score.
Qual é a velocidade do rastreamento?
Você define o ritmo com --max-urls-per-second ou --min-delay. Um ritmo de 1 a 2 requisições por segundo é um ponto de partida cuidadoso para um site em produção.
Ele usa sitemaps?
Sim, como fonte extra de URLs: --sitemap usa as URLs do XML como ponto de partida ou as confere com o que foi encontrado, e uma URL de sitemap sem nenhum link interno de entrada é apontada como órfã de sitemap.

Teste no seu próprio site