
Auditoría de enlazado interno y profundidad de clics

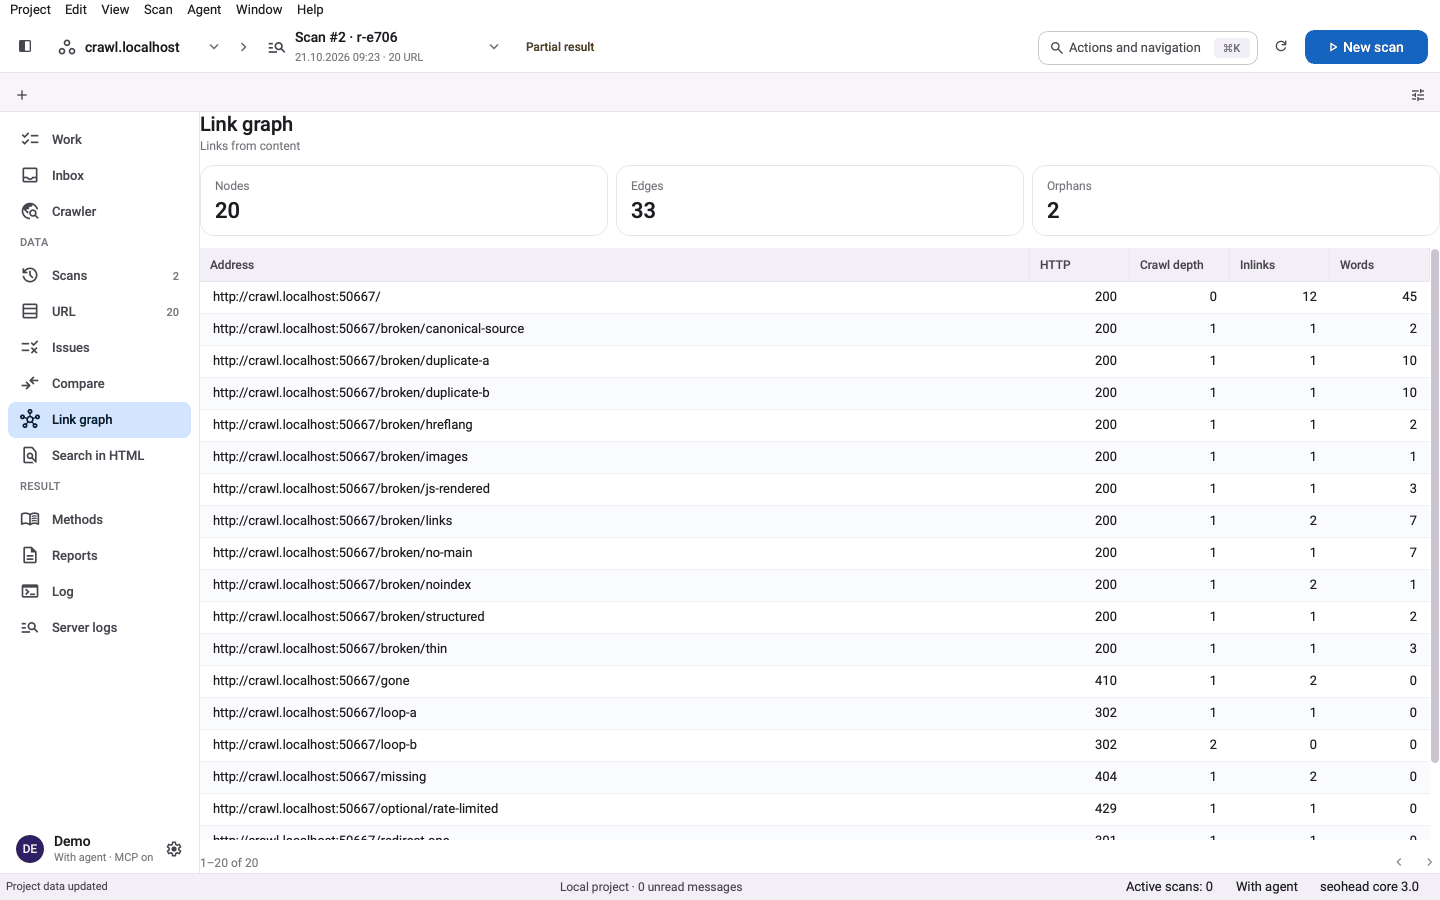
Mapea el grafo de enlaces internos a partir de un rastreo: páginas huérfanas, profundidad de clics excesiva, páginas sin salida, páginas enlazadas solo desde la navegación, enlaces entrantes solo con nofollow y una puntuación de enlaces comparada con la mediana del sitio.

Qué hace

Estructura

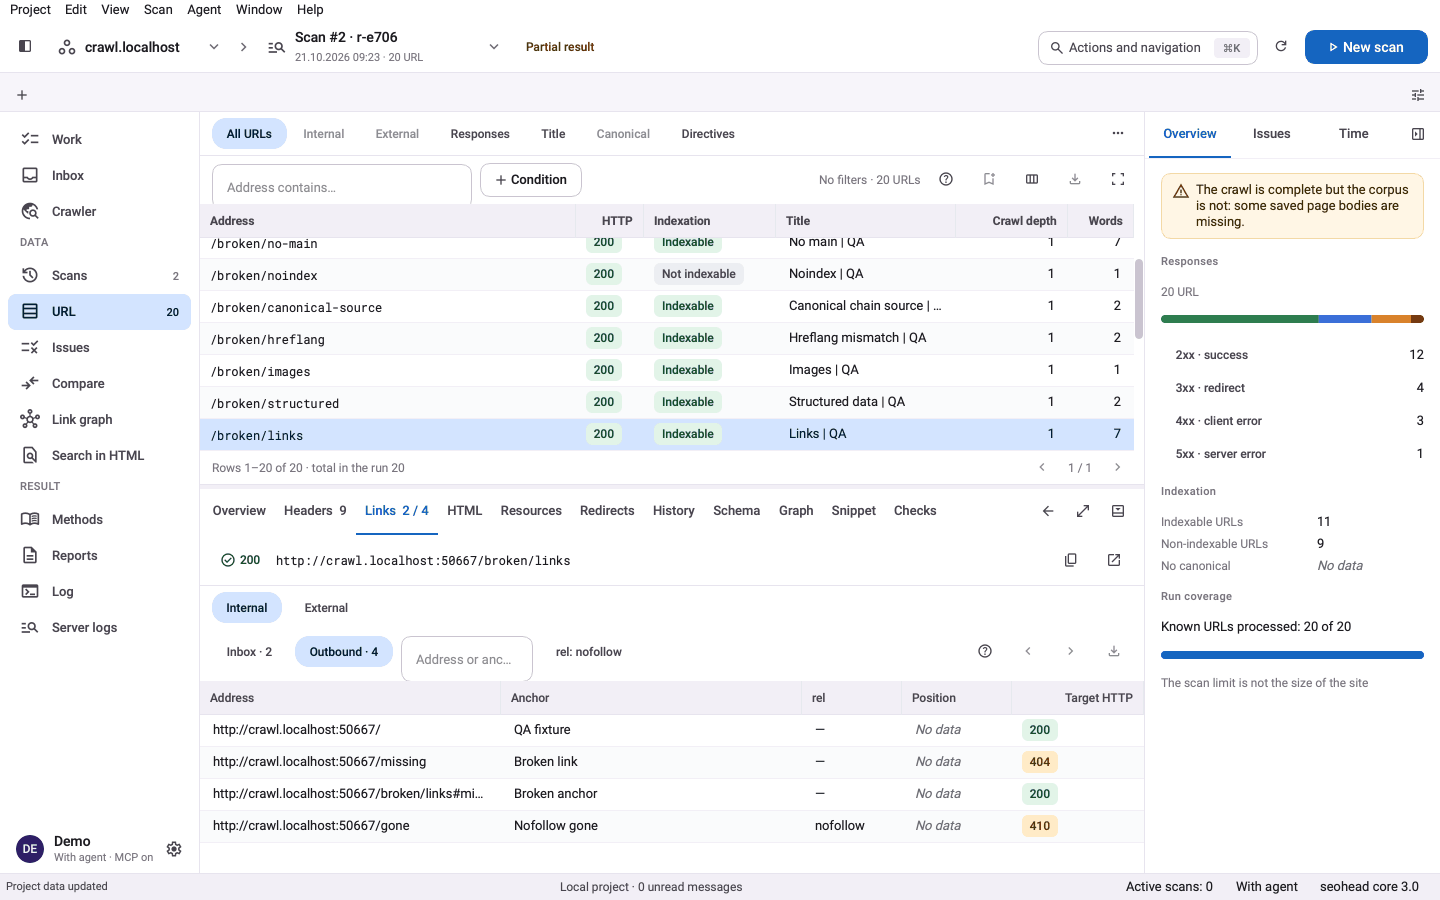
crawl-site sigue los enlaces del mismo host desde una URL de inicio y guarda todos los enlaces en un único archivo SQLite. Para cada página obtiene sus enlaces entrantes y salientes, la profundidad de clics desde la URL de inicio y la posición de cada enlace: navegación, pie de página o texto del cuerpo. Así se distinguen las páginas enlazadas desde el contenido de las que solo aparecen en un menú.

  • Enlaces entrantes y salientes por página
  • Profundidad de clics desde la URL de inicio
  • Posición del enlace: navegación, cabecera, barra lateral, pie de página, contenido
  • Ruta de descubrimiento de cada página

Puntos débiles

Las comprobaciones señalan las páginas a las que ningún enlace interno llega, las páginas sin salida, las páginas enlazadas solo desde elementos repetidos de la plantilla y las páginas cuyos enlaces entrantes son todos nofollow. Una puntuación de enlaces muestra las páginas muy por debajo de la mediana del sitio. El registro asigna a cada incidencia una corrección, como un enlace contextual desde una página relacionada.

  • Páginas huérfanas y páginas sin salida
  • Páginas enlazadas solo desde la navegación, la cabecera, la barra lateral o el pie de página
  • Enlaces entrantes solo con nofollow
  • Páginas demasiado alejadas de la URL de inicio en clics

Textos ancla

Un texto ancla genérico, como «aquí», «leer más» o «haz clic aquí», no dice a quien lee ni a los buscadores de qué trata el destino. También se informa de los enlaces internos con texto ancla vacío, salvo que se indique una etiqueta accesible.

  • Textos ancla genéricos
  • Enlaces internos con texto ancla vacío
  • Texto ancla mostrado junto a la página de origen

Tres pasos, un análisis guardado

  1. Rastrea el sitio desde una URL de inicio

    crawl-site sigue los enlaces del mismo host desde la URL de inicio, respeta robots.txt por defecto y guarda todos los enlaces en un único archivo SQLite.

  2. Mapea el grafo de enlaces

    Cada página obtiene sus enlaces entrantes y salientes, la profundidad de clics desde la URL de inicio y la posición de cada enlace: navegación, pie de página o texto del cuerpo.

  3. Marca huérfanas, páginas sin salida y enlaces débiles

    Las comprobaciones señalan las páginas que ningún enlace alcanza, las páginas sin salida, las páginas enlazadas solo desde elementos repetidos o con nofollow, y los textos ancla como «aquí».

Comprobaciones de esta función

ComprobaciónQué significaGravedadEvidencia
ORPHAN_PAGELa página no tiene enlaces internos entrantes en el rastreoImportantNúmero de enlaces entrantes de la URL
DEEP_CLICK_DEPTHLa página está a más clics de la URL de inicio que el mínimo configuradoImportantProfundidad de clics y la ruta más corta desde la URL de inicio
NO_INTERNAL_OUTLINKSPágina sin salida: no tiene enlaces internos salientesImportantURL de la página y número de enlaces salientes
INLINK_BOILERPLATE_ONLYLa página solo recibe enlaces desde la navegación, la cabecera, la barra lateral o el pie de página, nunca desde el contenido del cuerpoImportantPosición de los enlaces entrantes por zona de la plantilla
ONLY_NOFOLLOW_INLINKSTodos los enlaces internos a la página son nofollowImportantLista de enlaces entrantes con sus atributos rel
LOW_LINK_SCORELa puntuación de enlaces internos está muy por debajo de la mediana del sitioTipPuntuación de la página frente a la mediana del sitio
GENERIC_ANCHOR_TEXTUn texto ancla como «aquí», «leer más» o «haz clic aquí» no describe el destinoTipPágina de origen y texto ancla
También en el registro de comprobaciones
INTERNAL_LINK_NO_ANCHORSITEMAP_ORPHAN

Un solo comando

bash
seohead crawl-site --url https://example.com --max-urls 1000 --scan-out ./scans/links.sqlite

Primero, instala SpiderHead: guía de instalación. Cada comando también funciona como herramienta MCP para agentes de IA.

Qué necesitas

  • Una URL de inicio para crawl-site
  • O exportaciones Inlinks de Screaming Frog para la ruta de auditoría
  • Un rastreo completo para afirmaciones sobre todo el grafo

Límites

  • Un rastreo parcial no puede demostrar que una página es huérfana: las páginas que faltan podrían contener el único enlace
  • En un rastreo parcial se omite INLINK_BOILERPLATE_ONLY y no se muestra LOW_LINK_SCORE
  • Los enlaces que añade JavaScript solo se ven si el rastreo renderiza las páginas
  • Más allá del texto de la corrección, no sugiere qué páginas deberían enlazar a cuáles

Preguntas

¿Cambia algo en mi sitio?
No. El rastreo solo lee páginas. Sigue robots.txt por defecto, y puedes usar report-only o ignorarlo con --robots. Los resultados están en un archivo SQLite que revisas tú.
¿Cuántas páginas rastrea?
El límite por defecto es de 200 URL. Auméntalo con --max-urls, hasta 1 000 000. Usa --max-urls 0 para un rastreo completo. Un rastreo detenido se puede continuar con --resume.
¿Es completo el resultado si el rastreo se detiene pronto?
No para afirmaciones sobre todo el grafo. En un rastreo parcial, las páginas que faltan podrían contener el único enlace a una página; por eso se omiten comprobaciones como INLINK_BOILERPLATE_ONLY y no se muestra LOW_LINK_SCORE. Haz un rastreo completo antes de fiarte de la puntuación.
¿A qué velocidad rastrea?
Tú fijas la velocidad con --max-urls-per-second o --min-delay. Un ritmo de 1 a 2 peticiones por segundo es un punto de partida prudente para un sitio en funcionamiento.
¿Usa sitemaps?
Sí, como fuente adicional de URL: --sitemap añade URL a partir de los XML o las concilia con ellas, y una URL del sitemap sin enlace interno entrante se informa como huérfana de sitemap.

Pruébalo en tu propio sitio