
Struttura
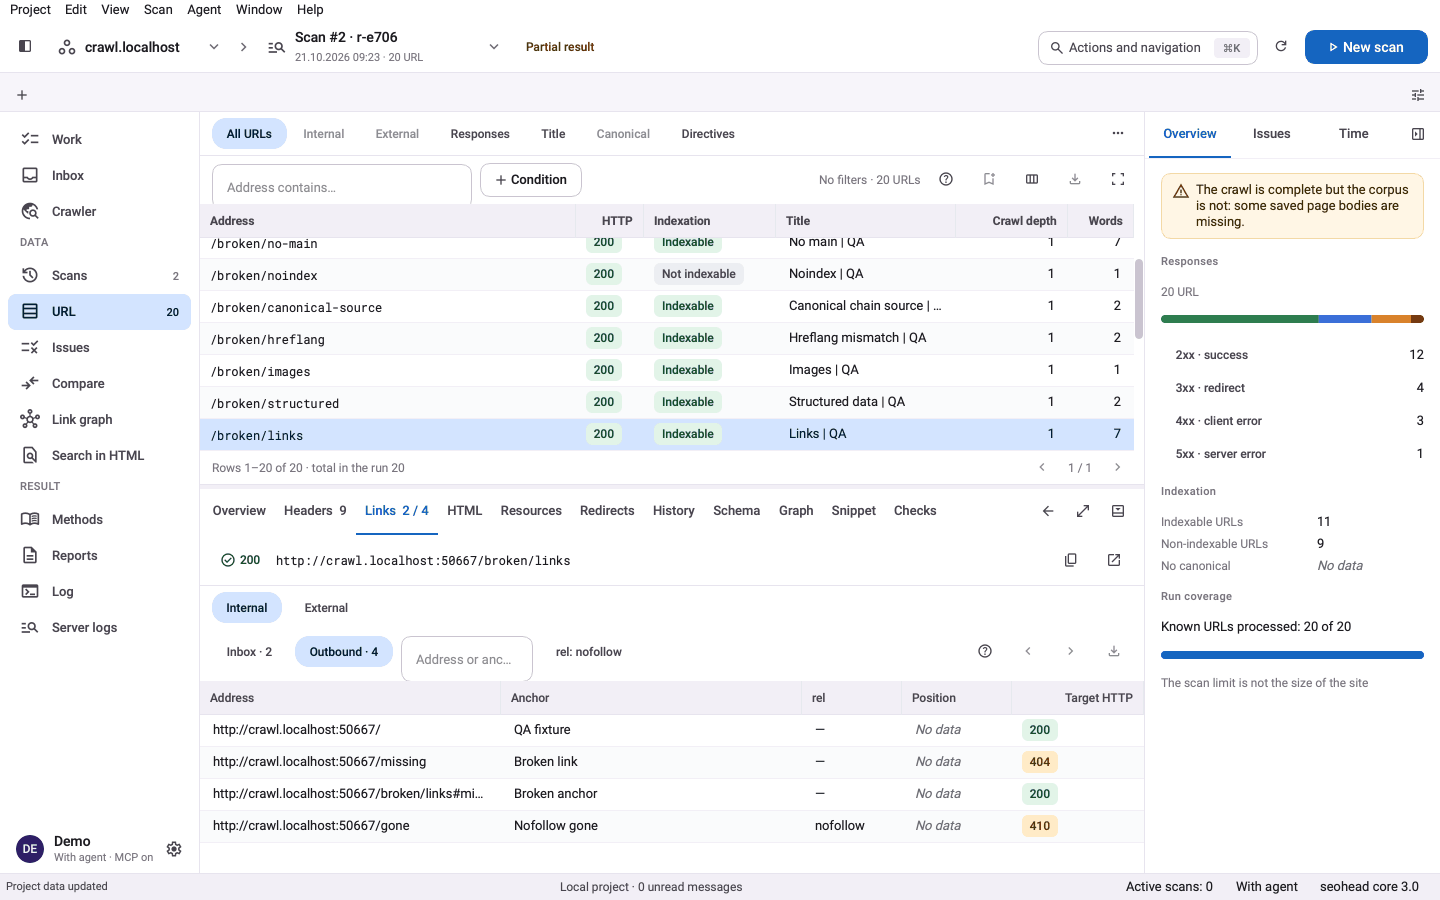
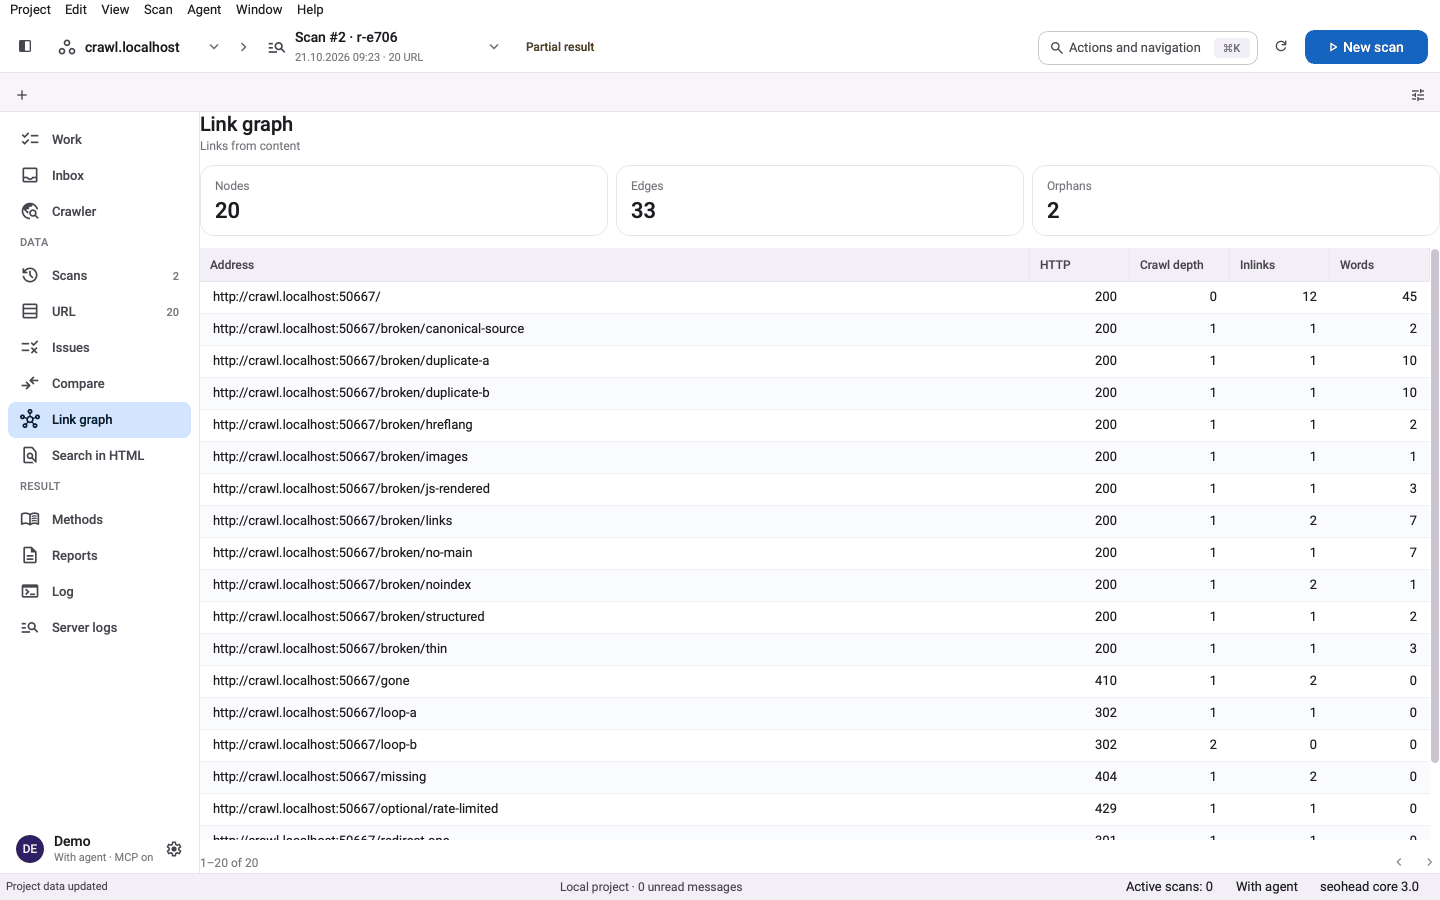
crawl-site segue i link sullo stesso host da una URL di partenza e conserva ogni link in un unico file SQLite. Ogni pagina riceve i suoi inlink, outlink, profondità di click dalla URL di partenza e la posizione di ogni link: navigazione, footer o testo del corpo. Questo separa le pagine linkate dai contenuti da quelle che compaiono solo in un menu.
- Inlink e outlink per pagina
- Profondità di click dalla URL di partenza
- Posizione del link: navigazione, header, sidebar, footer, contenuto
- Percorso di scoperta di ogni pagina