
構造
crawl-siteは、開始URLから同じホストのリンクを辿り、すべてのリンクを1つのSQLiteファイルに保存します。ページごとに、被リンク、発リンク、開始URLからのクリック深度、各リンクの位置(ナビゲーション、フッター、本文)が分かります。これにより、本文からリンクされているページと、メニューにしか載っていないページを区別できます。
- ページごとの被リンクと発リンク
- 開始URLからのクリック深度
- リンク位置:ナビゲーション、ヘッダー、サイドバー、フッター、本文
- 各ページの発見経路
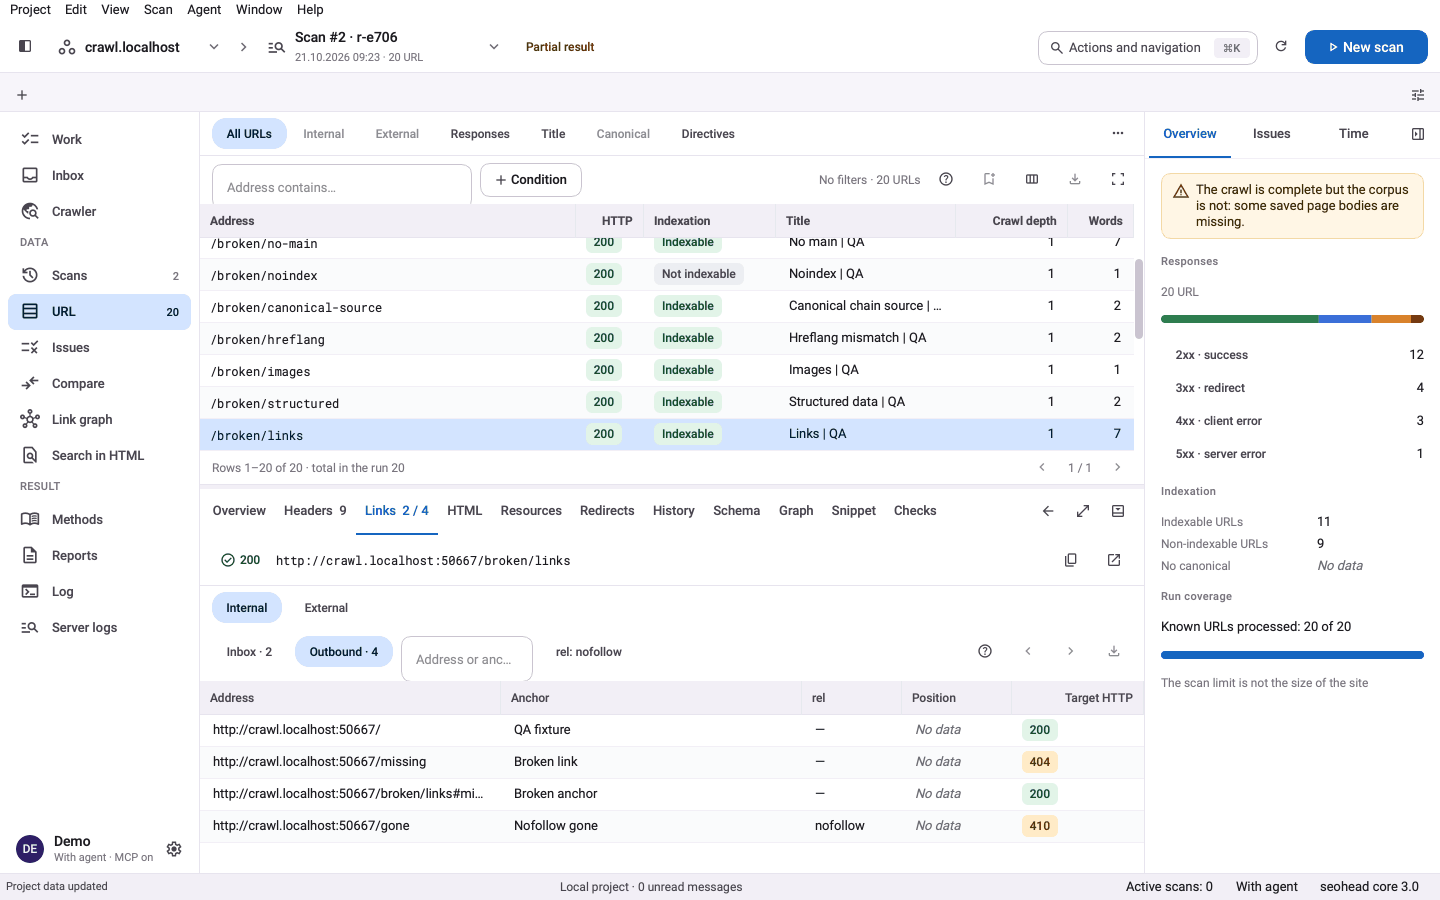
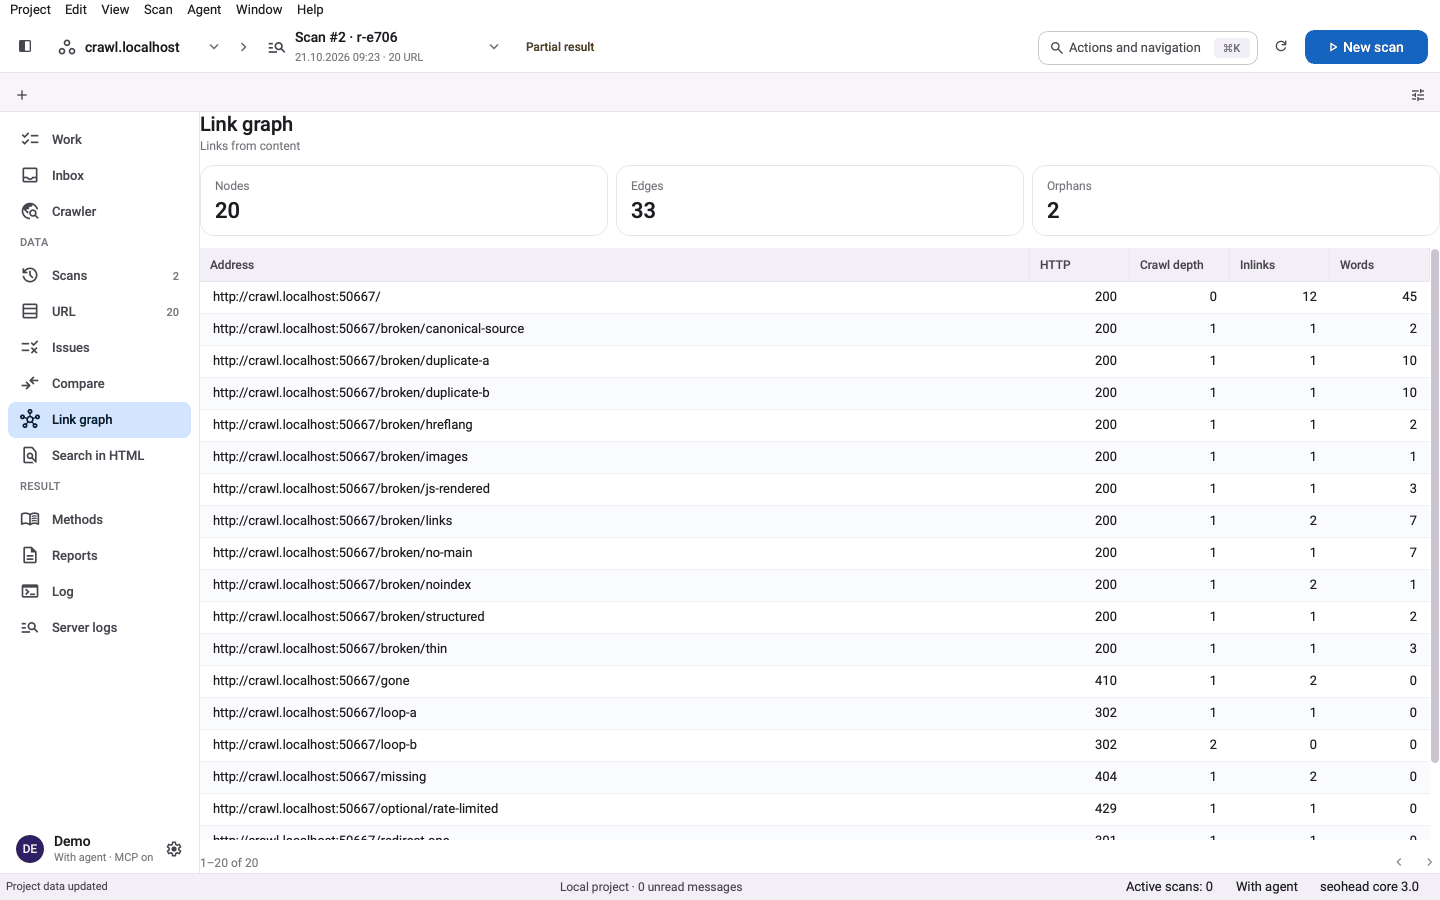
crawl-siteは、開始URLから同じホストのリンクを辿り、すべてのリンクを1つのSQLiteファイルに保存します。ページごとに、被リンク、発リンク、開始URLからのクリック深度、各リンクの位置(ナビゲーション、フッター、本文)が分かります。これにより、本文からリンクされているページと、メニューにしか載っていないページを区別できます。
チェックでは、どの内部リンクからも到達できないページ、発リンクのない行き止まりのページ、共通パーツ(ボイラープレート)からしかリンクされていないページ、被リンクがすべてnofollowのページを検出します。リンクスコアでは、サイトの中央値を大きく下回るページが分かります。レジストリには検出結果ごとに修正方法が登録されています。たとえば、関連ページからの文脈に沿ったリンクの追加です。
「こちら」「続きを読む」「ここをクリック」のような汎用的なアンカーテキストでは、リンク先が何のページなのか、読者にも検索エンジンにも伝わりません。アンカーテキストが空の内部リンクも、アクセシブルなラベルがない限り報告されます。
crawl-siteは、開始URLから同じホストのリンクを辿ります。既定ではrobots.txtに従い、すべてのリンクを1つのSQLiteファイルに保存します。
ページごとに、被リンク、発リンク、開始URLからのクリック深度、各リンクの位置(ナビゲーション、フッター、本文)を記録します。
チェックでは、どのリンクからも到達できないページ、行き止まり、共通パーツやnofollowからしかリンクされていないページ、「こちら」のようなアンカーを報告します。
| チェック項目 | 意味 | 重要度 | 根拠 |
|---|---|---|---|
ORPHAN_PAGE | クロール内に、ページへの内部リンクがない | Important | URLの被リンク数 |
DEEP_CLICK_DEPTH | 開始URLからのクリック数が、設定した下限を超えている | Important | クリック深度と、開始URLからの最短経路 |
NO_INTERNAL_OUTLINKS | 内部リンクが出ていない、行き止まりのページ | Important | ページのURLと発リンク数 |
INLINK_BOILERPLATE_ONLY | ナビゲーション、ヘッダー、サイドバー、フッターからしかリンクされておらず、本文からのリンクがない | Important | テンプレートの領域ごとの被リンクの位置 |
ONLY_NOFOLLOW_INLINKS | ページへの内部リンクがすべてnofollow | Important | rel属性付きの被リンク一覧 |
LOW_LINK_SCORE | 内部リンクスコアが、サイトの中央値を大きく下回っている | Tip | ページのスコアとサイトの中央値の比較 |
GENERIC_ANCHOR_TEXT | 「こちら」「続きを読む」「ここをクリック」のようなアンカーテキストが、リンク先の内容を表していない | Tip | リンク元のページとアンカーテキスト |
INTERNAL_LINK_NO_ANCHORSITEMAP_ORPHANseohead crawl-site --url https://example.com --max-urls 1000 --scan-out ./scans/links.sqlite先にインストールします: インストールガイド。どのコマンドも、AIエージェント向けのMCPツールとして実行できます。