
Аудит внутренней перелинковки и глубины сканирования

Постройте граф внутренних ссылок по результатам сканирования: страницы-сироты, слишком большая глубина кликов, тупики, страницы, на которые ведут только ссылки из навигации, входящие ссылки только с nofollow и ссылочный вес в сравнении с медианой сайта.

Что делает

Структура

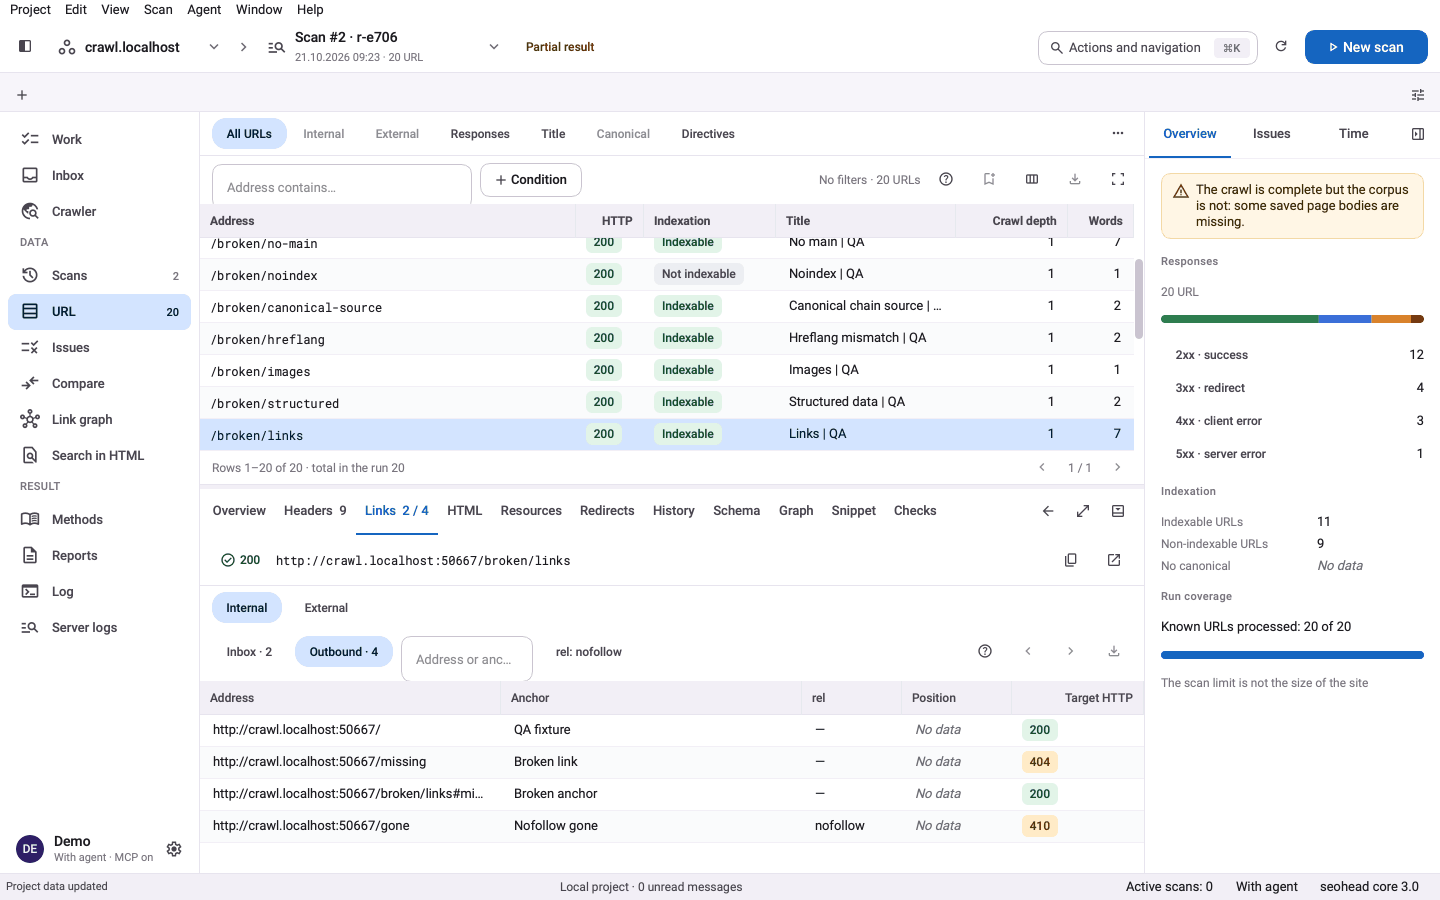
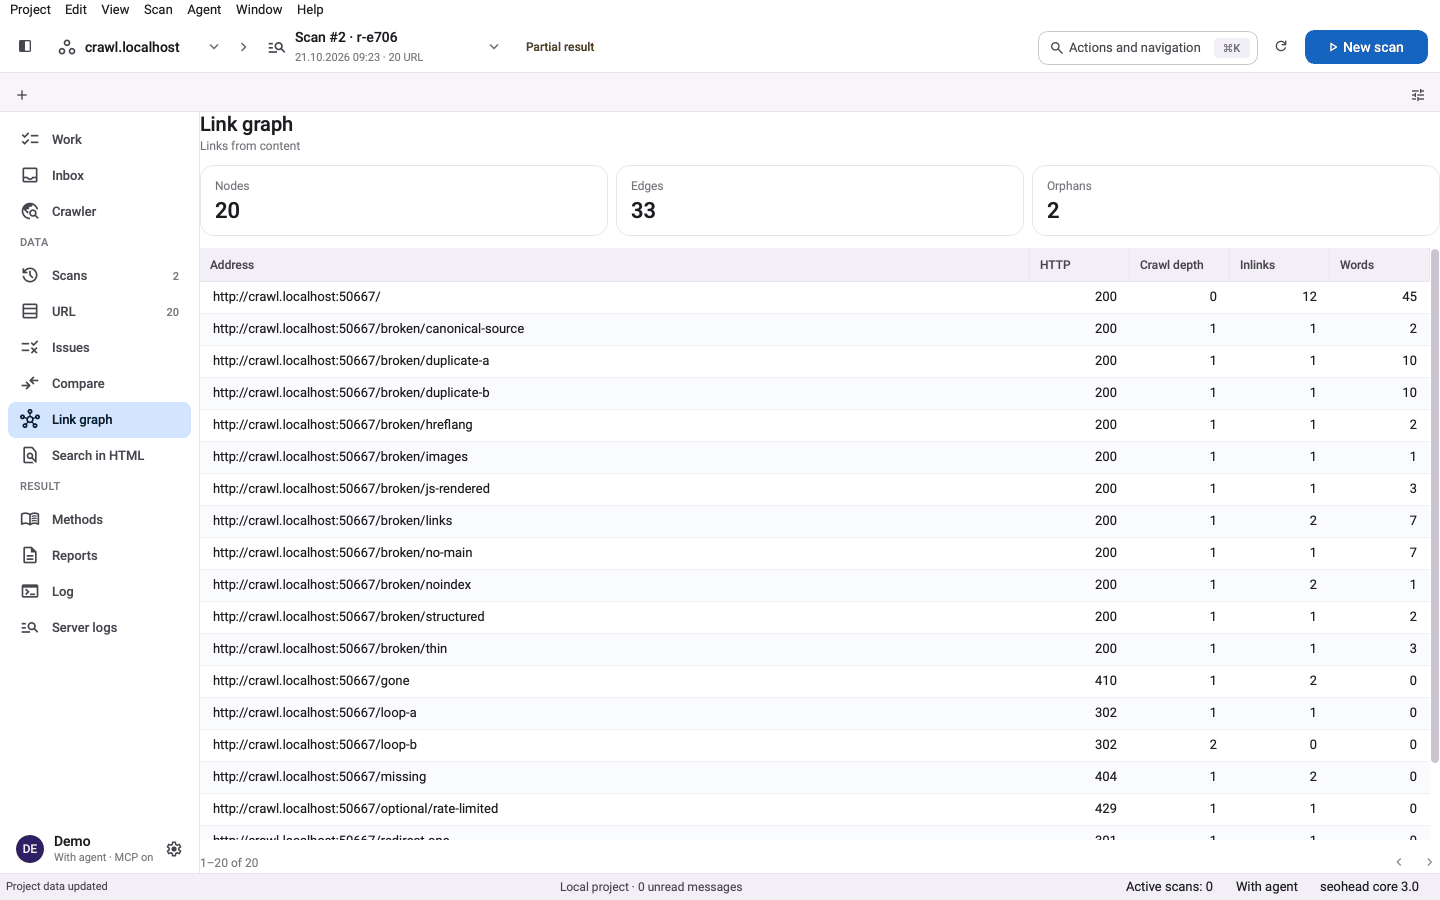
crawl-site переходит по ссылкам внутри того же хоста от стартового URL и хранит все ссылки в одном файле SQLite. Для каждой страницы считаются входящие и исходящие ссылки, глубина клика от стартового URL и место каждой ссылки: навигация, футер или текст страницы. Так видно, какие страницы связаны с контентом, а какие появляются только в меню.

  • Входящие и исходящие ссылки на каждой странице
  • Глубина клика от стартового URL
  • Место ссылки: навигация, шапка, боковая колонка, футер, контент
  • Путь обнаружения каждой страницы

Слабые места

Проверки показывают страницы, на которые не ведёт ни одна внутренняя ссылка, тупики без исходящих ссылок, страницы, на которые ссылаются только из шаблонных блоков, и страницы, у которых все входящие ссылки nofollow. Ссылочный вес показывает страницы, которые сильно ниже медианы сайта. Для каждой находки реестр даёт исправление, например контекстную ссылку с связанной страницы.

  • Страницы-сироты и тупики
  • Страницы, на которые ссылаются только из навигации, шапки, боковой колонки или футера
  • Входящие ссылки только с nofollow
  • Страницы с избыточной глубиной кликов от стартового URL

Анкоры

Общий анкор вроде «здесь», «читать далее» или «нажмите здесь» не говорит ни читателю, ни поисковику, о чём целевая страница. Внутренние ссылки с пустым анкором тоже попадают в отчёт, если для них не задана доступная подпись.

  • Общие анкоры
  • Внутренние ссылки с пустым анкором
  • Анкор выводится вместе с исходной страницей

Три шага — один сохранённый скан

  1. Сканирование сайта от одного стартового URL

    crawl-site переходит по ссылкам внутри хоста от стартового URL, по умолчанию соблюдает robots.txt и сохраняет все ссылки в одном файле SQLite.

  2. Построение графа ссылок

    Для каждой страницы считаются входящие и исходящие ссылки, глубина клика от стартового URL и место каждой ссылки: навигация, футер или текст страницы.

  3. Поиск сирот, тупиков и слабых ссылок

    Проверки показывают страницы без входящих ссылок, тупики, страницы, на которые ссылаются только из шаблонных блоков или с nofollow, и анкоры вроде «здесь».

Проверки в этой возможности

ПроверкаЧто значитКритичностьДоказательство
ORPHAN_PAGEНа странице нет внутренних входящих ссылок в сканированииImportantКоличество входящих ссылок на URL
DEEP_CLICK_DEPTHСтраница находится в кликах дальше от стартового URL, чем заданный порогImportantГлубина клика и кратчайший путь от стартового URL
NO_INTERNAL_OUTLINKSТупиковая страница без внутренних исходящих ссылокImportantURL страницы и количество исходящих ссылок
INLINK_BOILERPLATE_ONLYНа страницу ссылаются только из навигации, шапки, боковой колонки или футера, но никогда из текста страницыImportantМеста входящих ссылок по областям шаблона
ONLY_NOFOLLOW_INLINKSВсе внутренние ссылки на страницу имеют nofollowImportantСписок входящих ссылок с атрибутами rel
LOW_LINK_SCOREВнутренний ссылочный вес сильно ниже медианы сайтаTipВес страницы относительно медианы сайта
GENERIC_ANCHOR_TEXTАнкор вроде «здесь», «читать далее» или «нажмите здесь» не описывает целевую страницуTipИсходная страница и анкорный текст
Ещё в реестре проверок
INTERNAL_LINK_NO_ANCHORSITEMAP_ORPHAN

Одна команда

bash
seohead crawl-site --url https://example.com --max-urls 1000 --scan-out ./scans/links.sqlite

Сначала установите: руководство по установке. Каждая команда работает и как MCP-инструмент для ИИ-агентов.

Что нужно

  • Стартовый URL для crawl-site
  • Или экспорты Inlinks из Screaming Frog для аудита по выгрузкам
  • Полное сканирование для выводов по всему графу

Ограничения

  • Частичное сканирование не доказывает, что страница — сирота: недостающие страницы могут содержать единственную ссылку на неё
  • При частичном сканировании проверка INLINK_BOILERPLATE_ONLY пропускается, а LOW_LINK_SCORE не выводится
  • Ссылки, которые добавляет JavaScript, видны только при сканировании с рендерингом
  • Кроме текста исправления, инструмент не подсказывает, какая страница должна ссылаться на какую

Вопросы

Что-нибудь меняется на моём сайте?
Нет. Сканирование только читает страницы. По умолчанию оно соблюдает robots.txt, а с --robots можно задать report-only или ignore. Результат — файл SQLite, который вы просматриваете сами.
Сколько страниц сканируется?
По умолчанию лимит — 200 URL. Поднять его можно через --max-urls, до 1 000 000. Используйте --max-urls 0 для полного сканирования. Остановленное сканирование можно продолжить с помощью --resume.
Результат полный, если сканирование остановилось раньше?
Нет, для выводов по всему графу — не полный. При частичном сканировании недостающие страницы могут содержать единственную ссылку на страницу, поэтому проверки вроде INLINK_BOILERPLATE_ONLY пропускаются, а LOW_LINK_SCORE не выводится. Прежде чем доверять скору, проведите полное сканирование.
Как быстро идёт сканирование?
Скорость задаёте через --max-urls-per-second или --min-delay. Для живого сайта вежливо начать с 1–2 запросов в секунду.
Используются ли карты сайта?
Да, как дополнительный источник URL: --sitemap добавляет в список URL из XML или сверяет их с найденными, а URL из карты сайта без внутренней входящей ссылки отмечается как сирота карты сайта.

Что ещё посмотреть

Проверьте на своём сайте