
Audit du maillage interne et de la profondeur de crawl

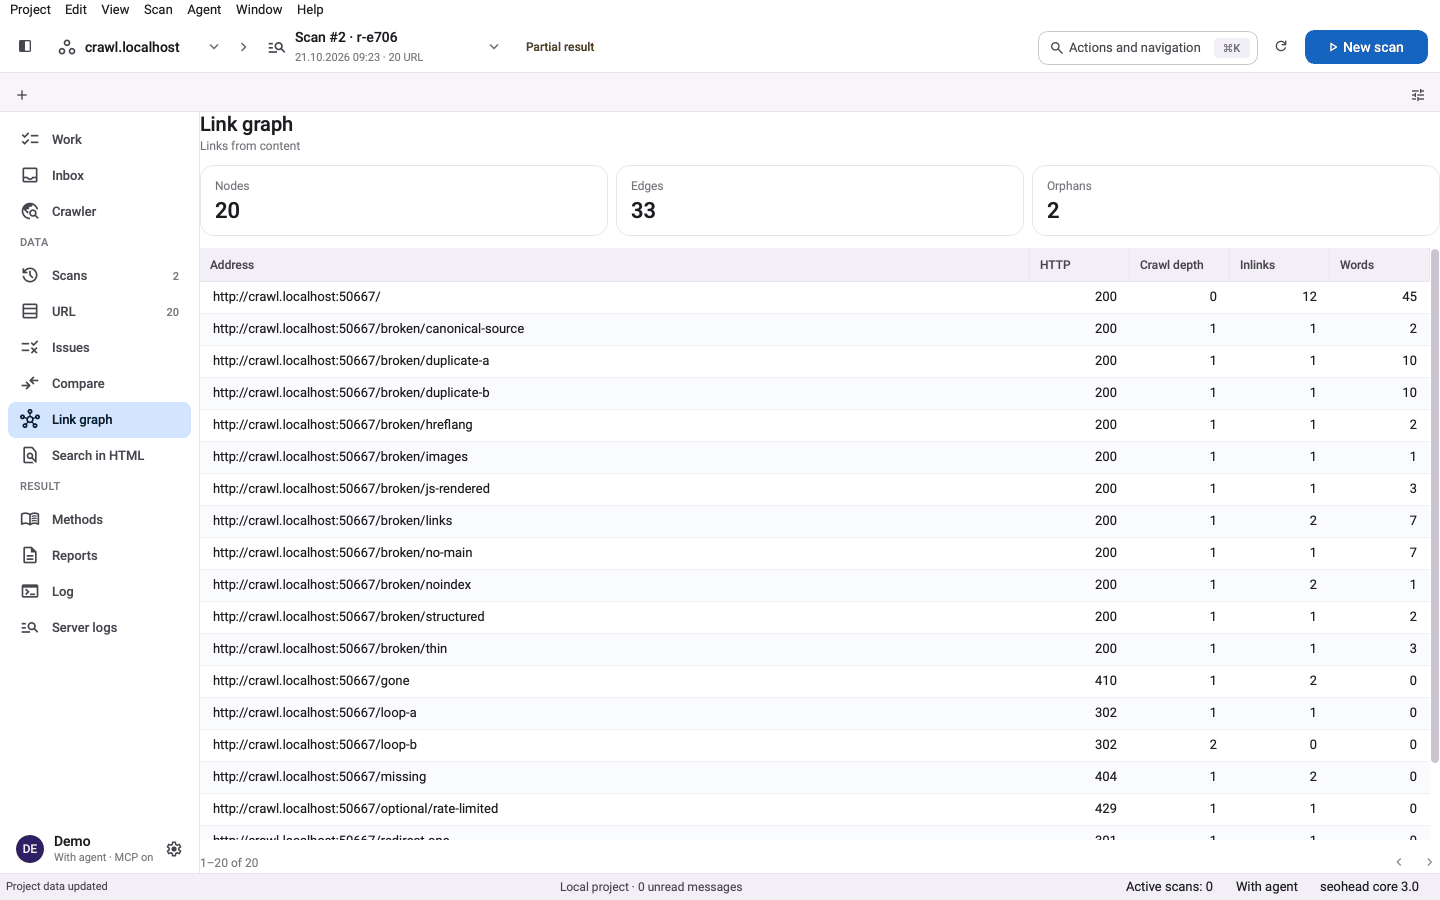
Cartographiez le graphe de maillage interne d’un crawl : pages orphelines, profondeur de clic excessive, culs-de-sac, pages liées uniquement depuis la navigation, pages dont tous les liens entrants sont en nofollow, et score de liens comparé à la médiane du site.

Ce qu'elle fait

Structure

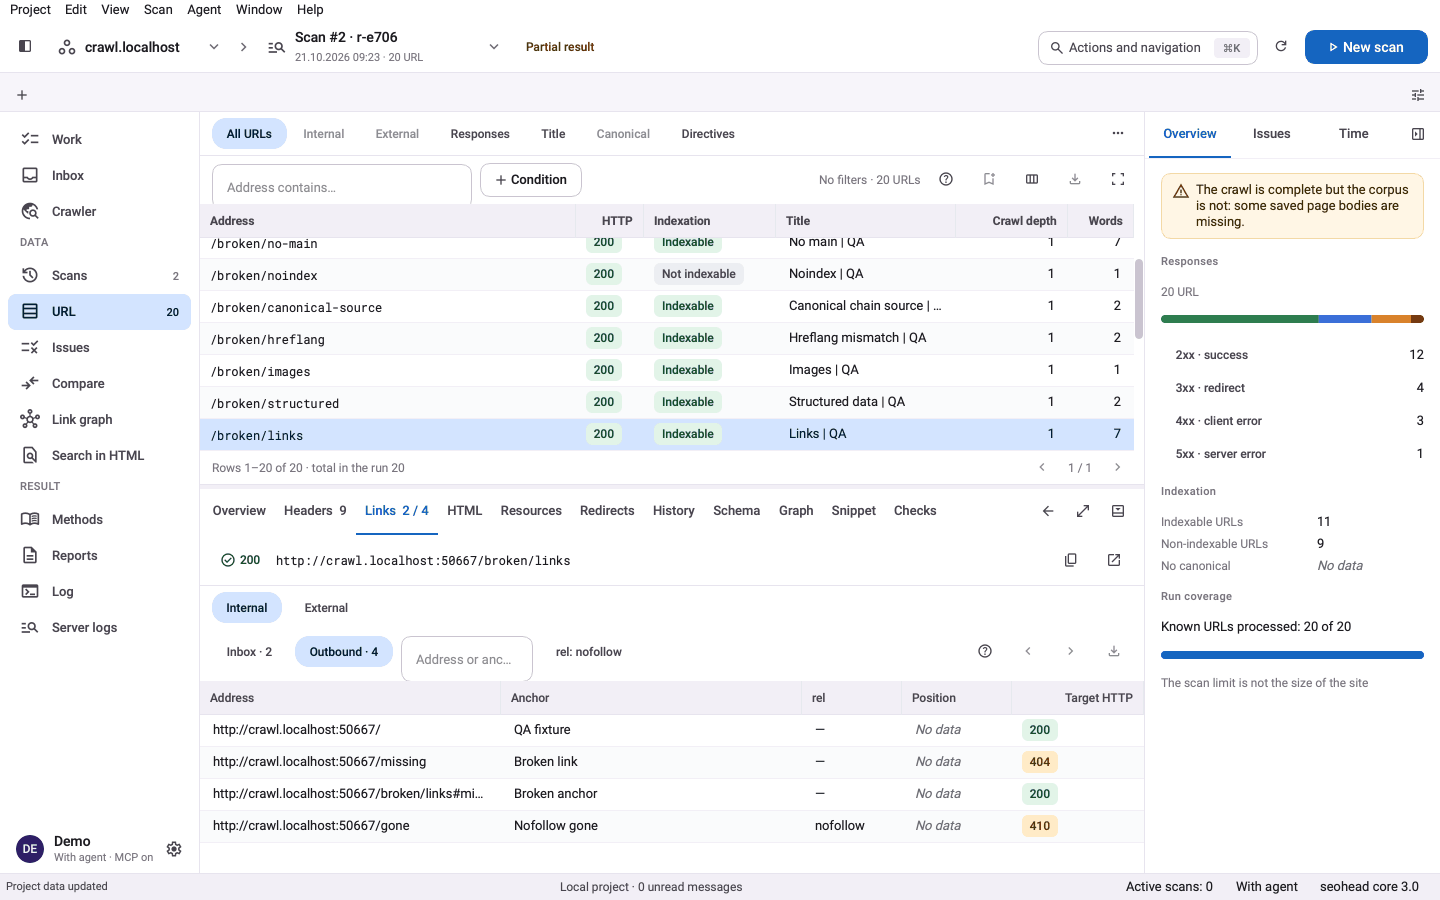
crawl-site suit les liens du même hôte à partir d’une URL de départ et conserve chaque lien dans un seul fichier SQLite. Pour chaque page, il enregistre les liens entrants, les liens sortants, la profondeur de clic depuis l’URL de départ et la position de chaque lien : navigation, pied de page ou corps du texte. On distingue ainsi les pages liées depuis le contenu de celles qui n’apparaissent que dans un menu.

  • Liens entrants et sortants par page
  • Profondeur de clic depuis l’URL de départ
  • Position du lien : navigation, en-tête, barre latérale, pied de page, contenu
  • Chemin de découverte de chaque page

Points faibles

Les contrôles signalent les pages qu’aucun lien interne n’atteint, les culs-de-sac sans lien sortant, les pages liées uniquement depuis les blocs récurrents (boilerplate) et les pages dont tous les liens entrants sont en nofollow. Un score de liens met en évidence les pages nettement en dessous de la médiane du site. Le registre associe à chaque constat une correction, par exemple un lien contextuel depuis une page connexe.

  • Pages orphelines et culs-de-sac
  • Pages liées uniquement depuis la navigation, l’en-tête, la barre latérale ou le pied de page
  • Liens entrants uniquement en nofollow
  • Pages trop éloignées de l’URL de départ en nombre de clics

Ancres

Un texte d’ancre générique, comme « ici », « lire la suite » ou « cliquez ici », n’indique ni aux lecteurs ni aux moteurs de recherche le sujet de la page cible. Les liens internes à ancre vide sont également signalés, sauf si un libellé accessible est fourni.

  • Texte d’ancre générique
  • Liens internes à ancre vide
  • Texte d’ancre affiché avec la page source

Trois étapes, un seul scan enregistré

  1. Crawler le site à partir d’une URL de départ

    crawl-site suit les liens du même hôte à partir de l’URL de départ, respecte robots.txt par défaut et enregistre chaque lien dans un seul fichier SQLite.

  2. Cartographier le graphe de liens

    Chaque page reçoit ses liens entrants, ses liens sortants, sa profondeur de clic depuis l’URL de départ et la position de chaque lien : navigation, pied de page ou corps du texte.

  3. Repérer les pages orphelines, les culs-de-sac et les liens faibles

    Les contrôles signalent les pages qu’aucun lien n’atteint, les culs-de-sac, les pages liées uniquement depuis des blocs récurrents ou en nofollow, et les ancres du type « ici ».

Contrôles de cette fonctionnalité

ContrôleSignificationGravitéPreuve
ORPHAN_PAGELa page ne reçoit aucun lien interne entrant dans le crawlImportantNombre de liens entrants pour l’URL
DEEP_CLICK_DEPTHLa page se trouve à plus de clics de l’URL de départ que le seuil configuréImportantProfondeur de clic et plus court chemin depuis l’URL de départ
NO_INTERNAL_OUTLINKSPage en cul-de-sac, sans lien interne sortantImportantURL de la page et nombre de liens sortants
INLINK_BOILERPLATE_ONLYLa page n’est liée que depuis la navigation, l’en-tête, la barre latérale ou le pied de page, jamais depuis le corps du texteImportantPosition des liens entrants par zone du gabarit
ONLY_NOFOLLOW_INLINKSTous les liens internes vers la page sont en nofollowImportantListe des liens entrants avec leurs attributs rel
LOW_LINK_SCORELe score de liens interne est nettement inférieur à la médiane du siteTipScore de la page comparé à la médiane du site
GENERIC_ANCHOR_TEXTUne ancre telle que « ici », « lire la suite » ou « cliquez ici » ne décrit pas la destinationTipPage source et texte d’ancre
Aussi dans le registre des contrôles
INTERNAL_LINK_NO_ANCHORSITEMAP_ORPHAN

Une seule commande

bash
seohead crawl-site --url https://example.com --max-urls 1000 --scan-out ./scans/links.sqlite

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Une URL de départ pour crawl-site
  • Ou les exports Inlinks de Screaming Frog, pour le parcours d’audit
  • Un crawl complet pour les affirmations portant sur l’ensemble du graphe

Limites

  • Un crawl partiel ne permet pas de prouver qu’une page est orpheline : les pages manquantes peuvent porter l’unique lien vers elle
  • Sur un crawl partiel, INLINK_BOILERPLATE_ONLY est ignoré et LOW_LINK_SCORE n’est pas affiché
  • Les liens ajoutés par JavaScript ne sont vus que si le crawl effectue le rendu des pages
  • L’outil ne suggère pas quelles pages devraient pointer vers quelles autres, au-delà du texte de correction

Questions

Cela modifie-t-il quelque chose sur mon site ?
Non. Le crawl ne fait que lire les pages. Il respecte robots.txt par défaut, et vous pouvez définir le mode rapport seul ou l’ignorer avec --robots. Les résultats sont un fichier SQLite que vous examinez vous-même.
Combien de pages le crawl parcourt-il ?
La limite par défaut est de 200 URL. Augmentez-la avec --max-urls, jusqu’à 1 000 000. Utilisez --max-urls 0 pour un crawl complet. Un crawl arrêté peut être repris avec --resume.
Le résultat est-il complet si le crawl s’arrête tôt ?
Pas pour les constats portant sur l’ensemble du graphe. Sur un crawl partiel, les pages manquantes peuvent porter le seul lien vers une page : des contrôles comme INLINK_BOILERPLATE_ONLY sont donc ignorés et LOW_LINK_SCORE n’est pas affiché. Lancez un crawl complet avant de vous fier au score.
À quelle vitesse le crawl progresse-t-il ?
Vous fixez le débit avec --max-urls-per-second ou --min-delay. Un débit de 1 à 2 requêtes par seconde est un point de départ prudent pour un site en ligne.
Le crawl utilise-t-il les sitemaps ?
Oui, comme source d’URL supplémentaire : --sitemap ajoute les URL XML au crawl ou les recoupe avec celles déjà trouvées, et une URL de sitemap sans lien interne entrant est signalée comme page orpheline du sitemap.